7900XTX本地部署通义千问3实战:53TPS推理速度调优指南

消费级显卡也能玩转大模型本地部署
随着开源大模型的能力不断增强,越来越多的开发者和爱好者开始尝试在本地部署运行,以获得数据隐私、离线可用和低成本推理等优势。2023年以来,以Meta的LLaMA系列、阿里的通义千问广告系列、Mistral等为代表的开源大模型在能力上不断逼近闭源商业模型。这些进步得益于多个技术突破的叠加:训练数据质量的系统性提升(通过数据去重、质量过滤和合成数据扩充)、训练方法的改进(DPO/RLHF对齐技术的普及大幅降低了训练门槛)、以及模型架构的持续优化(GQA分组查询注意力降低了KV Cache的内存需求,RoPE旋转位置编码实现了上下文长度的灵活外推)。Meta的LLaMA系列通过开放权重引发了开源社区的爆发式创新,阿里的Qwen系列在中英双语能力上表现突出,而Mistral则以高效的Mixture-of-Experts架构证明了较小的激活参数量也能实现优秀性能。特别是Qwen3系列在2025年发布后,其27B参数版本在多项基准测试中展现了接近GPT-4级别的推理能力。这种"开源追赶闭源"的趋势,叠加本地部署在数据合规(如GDPR、中国数据安全法)方面的天然优势,使得个人和中小企业对本地推理方案的需求急剧增长。
本文根据一位B站UP主的实测教程,梳理如何在一张 AMD RX 7900XTX 24GB 显卡上,将通义千问3(Qwen3)27B 级别模型跑出令人惊讶的性能表现。
在这套配置下,作者实现了 262K 超长上下文、KV Cache Q4 量化 和 MTP 投机采样 三管齐下,最终把 24GB 显存压榨到 99% 的利用率,输出速度最高可达 5253 TPS(Tokens Per Second),平均也稳定在 47 TPS 左右。TPS 是衡量大语言模型推理速度的核心指标,特指模型在生成阶段每秒输出的 token 数量。人类阅读英文的速度约为每秒 45 个 token,因此当生成速度超过 1520 TPS 时,用户在交互中已经感受不到明显等待。4753 TPS 的输出速度意味着模型生成远超人类阅读速度,在实际使用中几乎等同于即时响应。作为参考,使用 NVIDIA RTX 4090(24GB)运行类似规模的 Q4 量化模型,典型生成速度在 40~60 TPS 范围内,这说明 7900XTX 在经过优化后已经能够接近甚至媲美同等级 NVIDIA 旗舰消费卡的推理性能。
硬件配置与关键参数解析
核心硬件:GPU 才是主角
作者坦言,这套系统的 CPU 只是入门级的 Ryzen 3700,内存虽然有 94GB 但实际用不到那么多。真正决定成败的是 7900XTX 24GB 显卡。这也印证了一个核心观点:本地跑大模型,显存容量与带宽才是瓶颈所在,CPU 反而不是关键。
之所以显存带宽如此重要,是因为大模型推理(尤其是生成阶段)属于典型的显存带宽受限任务(Memory Bandwidth Bound),而非计算受限任务。在计算机体系结构中,任务的性能瓶颈可以用 Roofline 模型来分析,核心指标是算术强度(Arithmetic Intensity),即每字节内存访问所对应的浮点运算次数。大模型 Decode 阶段的算术强度极低——每生成一个 token 需要加载约等于模型参数量的数据(27B 模型约加载 15GB 的 Q4 权重),但对应的浮点运算量相对不大。这意味着 GPU 的数千个计算核心大部分时间在等待数据从显存传输过来,显存带宽直接决定了理论 TPS 上限。7900XTX 拥有 960 GB/s 的显存带宽,粗略估算:960 GB/s ÷ 15GB(Q4模型大小)≈ 64次/秒,考虑 KV Cache 访问和系统开销,实测 47~53 TPS 与理论上限相当吻合。相比之下,RTX 4090 的显存带宽为 1008 GB/s,两者差距仅约 5%,这解释了为什么优化后的 7900XTX 能够接近 4090 的推理性能。
对于 AMD 显卡用户而言,这是一个值得关注的信号——过去本地大模型部署几乎被 NVIDIA CUDA 生态垄断,而如今通过 llama.cpp 的 AMD 支持路径,A 卡也能获得不错的推理体验。llama.cpp 是由 Georgi Gerganov 开发的开源 C/C++ 大语言模型推理框架,其设计目标是在消费级硬件上高效运行量化后的大模型。它采用"零依赖"的设计哲学——纯 C/C++ 实现,不依赖 PyTorch 等重型框架,编译后的二进制文件可直接运行。它使用 GGUF(GPT-Generated Unified Format)模型格式,将模型权重、分词器和元数据打包在单一文件中,极大简化了分发和部署流程。截至2025年,llama.cpp 已支持包括 LLaMA、Qwen、Mistral、Gemma、Phi 等在内的数十种模型架构,HuggingFace 上的量化模型几乎都以 GGUF 格式发布。最初仅支持纯 CPU 推理,后逐步扩展到 NVIDIA CUDA、Apple Metal、以及 AMD ROCm/HIP 等异构计算后端。
AMD 显卡通过 ROCm(Radeon Open Compute)平台获得了 GPU 加速能力。ROCm 是 AMD 对标 NVIDIA CUDA 的开源 GPU 计算平台,提供了类似 CUDA 的编程接口 HIP(Heterogeneous-compute Interface for Portability),使得许多原本为 CUDA 编写的核心算子可以通过 hipify 工具半自动转换,较低成本地移植到 AMD GPU 上运行。长期以来,CUDA 凭借十余年的生态积累、完善的工具链(cuDNN、TensorRT、NCCL等)和广泛的社区支持,在 AI 领域占据绝对主导地位。ROCm 起步较晚,早期主要面向数据中心级 MI 系列加速卡,对消费级 RDNA 架构的支持相对滞后。但从 ROCm 5.x 开始,AMD 逐步改善了对消费级 GPU 的兼容性;ROCm 6.x 版本正式将 7900XTX 等 RDNA 3 显卡纳入官方支持列表,标志着 AMD 消费级显卡在大模型推理领域的可用性迈入了实用阶段。尽管 AMD 生态在 Flash Attention 优化、混合精度训练支持等方面仍存在差距,但对于推理场景(尤其是通过 llama.cpp 这类已完成适配的框架),差距已大幅缩小。
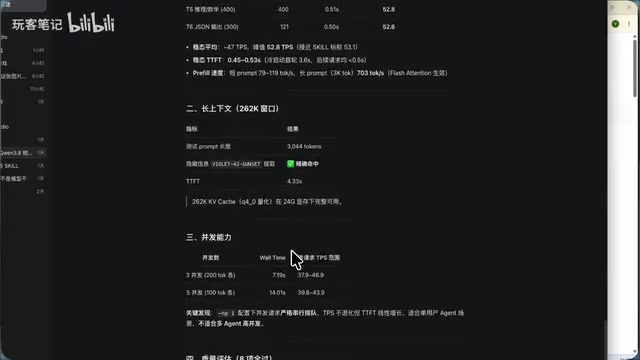
三大关键优化参数
作者将性能最大化归功于三项关键设置的组合:
- 262K 超长上下文:远超一般本地部署常见的 8K~32K,能够处理超长文档和复杂对话。
- KV Cache Q4 量化:对键值缓存进行 Q4 量化,大幅降低显存占用,从而腾出空间支撑更长的上下文窗口。
- MTP 投机采样(Multi-Token Prediction):通过投机式解码,一次预测多个 token,显著提升生成吞吐率。
KV Cache 与 Q4 量化的技术原理
KV Cache(Key-Value Cache)是 Transformer 架构在自回归生成过程中的核心加速机制。要理解它的重要性,需要先了解 Transformer 自回归生成的计算特性:整个生成过程分为两个阶段——Prefill 阶段(也称 Prompt Processing 阶段,一次性接收用户输入的所有 token,通过矩阵乘法并行计算所有 token 的注意力表示,属于计算密集型操作,GPU 利用率较高,速度通常用 PP TPS 衡量,在本文配置下可达数百甚至上千 TPS)和 Decode 阶段(逐 token 生成,带宽密集型)。Decode 阶段每步只生成一个 token,但需要加载全部模型权重进行一次完整的前向传播。由于 batch size 为 1 时的矩阵运算退化为矩阵-向量乘法,无法充分利用 GPU 的并行计算能力,导致 GPU 的算力利用率极低(通常不到 5%)。
在生成每个新 token 时,模型需要用到之前所有 token 的注意力键(Key)和值(Value)向量。如果不做缓存,每生成一个 token 就需要重新计算整个序列的 KV,计算量随序列长度呈二次方增长。KV Cache 将已计算的 KV 向量保存在显存中复用,将复杂度降为线性,但代价是显存占用随上下文长度线性增长。对于 27B 参数的模型在 262K 上下文长度下,FP16 精度的 KV Cache 可能需要数十 GB 显存。
Q4 量化将每个缓存值从 16 位浮点压缩到约 4 位整数表示,显存占用直接降至约四分之一。从数学原理上看,模型量化的核心思想是用低精度数值近似表示原始的高精度权重。以 Q4 量化为例,原始 FP16(16位浮点,范围约±65504)的权重被映射到 4 位整数(仅16个离散值)。具体实现通常采用分组量化:将权重按固定大小(如32或64个一组)分组,每组共享一个缩放因子(scale)和零点(zero-point),组内每个权重用 4 位整数存储。GGUF 格式中的量化方案形成了一个完整谱系:Q2_K、Q3_K_S/M/L、Q4_K_S/M、Q5_K_S/M、Q6_K、Q8_0 等,后缀 K 表示使用 k-quant 技术(重要性感知量化),S/M/L 分别代表小/中/大变体,区别在于哪些层使用更高精度。Q4_K_M 是中等变体,对注意力层的 Q/K 矩阵保持 Q6 精度,其余使用 Q4,在文件大小和精度间取得了被社区广泛验证的最佳平衡。从整体效果看,Q4_K_M 在精度损失仅 2%~5% 的前提下实现了显著的显存节省。
MTP 投机采样的工作机制
MTP(Multi-Token Prediction)投机采样是一种加速自回归语言模型生成速度的解码策略。传统自回归生成每次前向传播只产生一个 token,受限于模型推理延迟,吞吐量存在天然瓶颈。这也正是 Decode 阶段 GPU 算力利用率极低的根本原因——每次前向传播的计算量与加载整个模型权重的 I/O 开销不成比例。
投机解码(Speculative Decoding)的核心思想是:使用一个轻量级的"草稿模型"(Draft Model)一次性快速预测多个候选 token,然后用完整的大模型对这些候选 token 进行并行验证。由于 Transformer 在验证模式下可以一次性处理多个 token(类似 prefill 阶段),验证多个 token 的成本与验证单个 token 相差不大。Qwen3 模型原生内置了 MTP 模块,无需额外的草稿模型,模型自身的辅助预测头即可生成候选序列,进一步简化了部署流程。当候选 token 的接受率较高时,每次前向传播的有效输出 token 数量可达 24 个,从而将整体生成速度提升 1.5x3x,这也是本文中 47~53 TPS 高吞吐的关键技术支撑。
三者叠加后,显卡显存占用达到 23.9GB / 24GB,几乎完全跑满,同时保持了高命中率与高并发。这种"极限压榨"的调优思路,是本地部署追求性价比的典型做法。
Q4 量化到底能不能用?各量化等级精度损失对比
很多用户对量化精度存有疑虑,担心量化会严重损害模型质量。量化精度损失的评估通常采用困惑度(Perplexity)作为核心指标,在 WikiText-2 等标准数据集上进行测试。困惑度是信息论中交叉熵的指数形式,直观含义是模型在预测下一个 token 时的"困惑程度"——困惑度为 10 意味着模型平均在 10 个等可能的候选中做选择。在 WikiText-2 数据集上,FP16 精度的 Qwen3-27B 困惑度可能在 57 范围内,Q4_K_M 量化后困惑度通常上升 0.10.3 个点。此外,还会在 MMLU、HellaSwag、ARC 等下游任务基准上对比量化前后的准确率变化。Q4_K_M 量化方案在这些测试中通常表现出仅 1~3 个百分点的准确率下降。
需要注意的是,困惑度作为评估指标存在局限性:它衡量的是概率分布层面的偏差,但用户实际感知的输出质量(如逻辑连贯性、创意表达、指令遵循能力)与困惑度的相关性并非完全线性。这也是为什么 Q4 量化虽然在困惑度上有可测量的退化,但在人类盲测评估中大多数用户无法区分 Q4 量化与 FP16 原始模型的输出质量差异——微小的概率分布偏移在采样(temperature>0)后往往被噪声掩盖。
以下是各量化等级的精度损失实测对比:
| 量化版本 | 精度损失 | 适用场景 |
|---|---|---|
| Q5 | 近乎无损,人类无法分辨 | 显存充足时的高质量选择 |
| Q4 | 约 2%~5% 损失 | 黄金平衡点,绝大多数场景默认首选 |
| Q3 | 约 8%~15% 损失 | 显存不足时的妥协方案 |
| Q2 | 约 30%~50% 损失 | 不建议使用 |
结论非常明确:Q4 是绝大多数用户的最优解。它在质量和显存占用之间取得了极佳的平衡,24GB 显存搭配 Q4_K_M 版本正是甜点组合。只有在显存实在不够的低端设备上,才考虑退而求其次使用 Q3;而 Q2 的损失过大,实用价值有限。
显存容量与模型规模的选择指南
选择本地部署的模型规模时,显存容量是最核心的约束条件。Q4 量化下,模型权重的显存占用大致为:参数量(十亿)× 0.5GB。例如 27B 模型约占 13.5GB,剩余显存用于 KV Cache、计算中间状态和系统开销。这解释了为什么 24GB 显存能够承载 27B Q4 模型并支撑 262K 上下文——通过 KV Cache 的 Q4 量化,将原本需要的数十 GB 缓存压缩到了可接受的范围内。对于 16GB 显存的显卡(如 RTX 4060 Ti 16GB 或 RX 7800XT 16GB),建议选择 14B 级别的 Q4 模型或 27B 的 Q2/Q3 模型,但上下文长度需相应缩短。8GB 显存则通常只能运行 7B8B 级别的 Q4 模型,上下文长度受限在 8K16K 范围内。
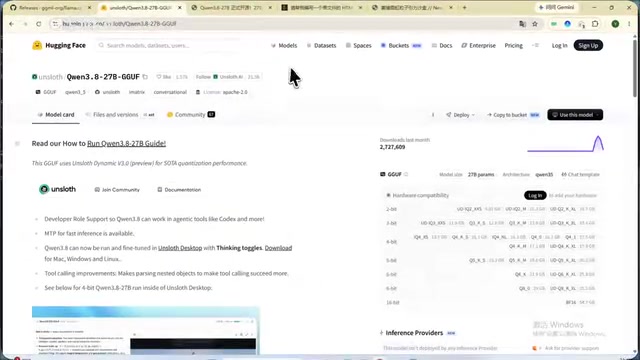
保姆级部署教程:从零开始本地运行 Qwen3
部署前需要准备的三样东西
整个部署流程其实并不复杂,核心需要三部分:
- 模型文件:根据显存容量选择对应量化版本。24GB 显存推荐 Q4_K_M。模型文件通常以 GGUF 格式发布在 HuggingFace 等平台上,文件大小在 Q4 量化下约为参数量的一半(如 27B 模型约 15GB 左右),下载时建议使用支持断点续传的工具。
- 推理引擎(llama.cpp):Windows 用户推荐使用 llama.cpp;苹果电脑可用 LM Studio 或类似工具。
- 对应的运行时:NVIDIA 用户下载 CUDA 版本(30 系及以后用 CUDA 13),AMD 用户则下载 A 卡专用版本。
作者特别提醒,CUDA 相关的两个文件需要一起下载,模型则严格按照显存容量对号入座。
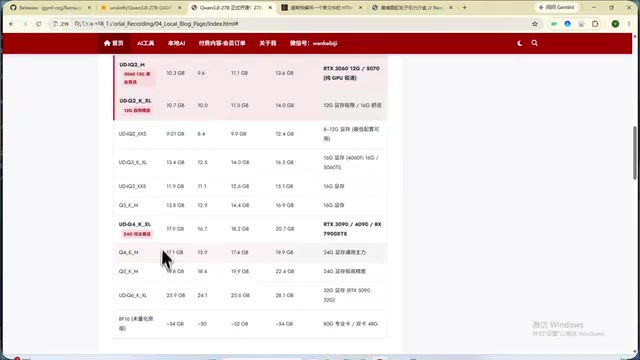
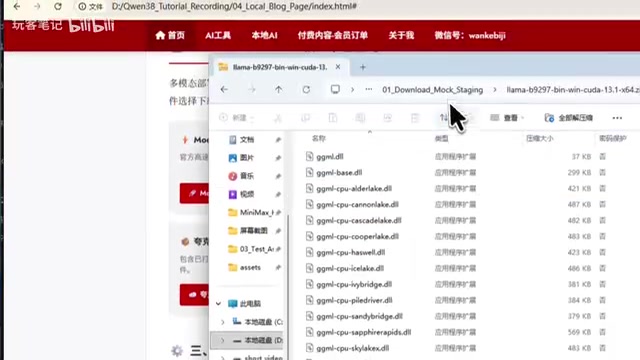
详细安装步骤
部署流程可以概括为以下几步:
- 解压 llama.cpp 文件夹,将 CUDA(或 A 卡运行时)文件复制粘贴进该文件夹。
- 在根目录新建
models文件夹,把下载的模型文件放进去。 - 将一键启动脚本放到根目录。作者提供了 24G 专用版本和多模型自由切换版本两种脚本。启动脚本本质上是调用 llama.cpp 的
llama-server命令,并传入模型路径、上下文长度(-c 262144)、GPU 层数(-ngl 99表示全部层卸载到 GPU)、KV Cache 量化类型等参数。理解这些参数的含义有助于用户根据自己的硬件条件进行微调。 - 双击运行一键启动脚本。
启动成功后,程序会显示一个本地访问地址。将 127.0.0.1:8080 粘贴到浏览器并回车,即可进入 Web 交互界面。这个服务端同时提供了兼容 OpenAI API 格式的 HTTP 接口(通常监听在 localhost:8080/v1/chat/completions),这意味着任何支持 OpenAI API 的客户端都可以零代码修改地接入本地模型——只需将 API Base URL 从 https://api.openai.com 改为 http://127.0.0.1:8080 即可。这种设计创造了一个强大的互操作层:Open WebUI 提供了类 ChatGPT 的 Web 界面并支持多模型管理;Chatbox 是跨平台的桌面客户端;SillyTavern 则专注于角色扮演和创意写作场景。对于开发者,Python 的 openai 库、LangChain、LlamaIndex 等框架也可以直接对接,使得基于本地模型构建 RAG(检索增强生成)、Agent 等复杂应用成为可能,而无需修改任何调用代码,灵活性非常高。
模型加载与实际使用
进入界面后,在模型列表中选择对应量化版本(Q4 用户选 Q4,低端设备选 Q2),等待加载完成后即可开始对话。作者还展示了此前用该模型生成的炫酷网页,证明其代码生成能力相当可靠。
总结:AMD 显卡本地部署大模型的关键收获
这套教程给本地大模型部署带来几点重要启示:
首先,AMD 显卡的本地推理生态正在成熟。7900XTX 凭借 24GB 大显存和 960 GB/s 的显存带宽,成为消费级本地部署的高性价比选择,不再是 NVIDIA 的专属天下。随着 ROCm 平台对 RDNA 3 架构的支持日趋完善,以及 llama.cpp 等开源框架持续优化 AMD 后端,A 卡用户在本地大模型推理领域的体验正在快速追赶 N 卡生态。值得注意的是,7900XTX 的市场售价通常比 RTX 4090 低 30%~40%,这使得它在"每美元 TPS"这一性价比指标上甚至超越了 NVIDIA 旗舰。
其次,参数调优比堆硬件更关键。通过 KV Cache 量化和 MTP 投机采样等技术,可以在有限显存下实现超长上下文与高吞吐,这体现了工程优化的价值。这些技术并非简单的"开关式"配置,而是需要理解 Transformer 架构中注意力机制的内存特性、自回归生成的计算瓶颈,以及量化对不同模型层的差异化影响,才能找到最优的参数组合。
最后,Q4 量化是本地部署的实用共识。在质量与资源占用之间,Q4 提供了最佳平衡,值得作为默认选择。随着量化技术的持续演进(如 GGUF 格式对更多量化方案的支持、重要性感知量化等新方法的引入),未来 Q4 级别量化的精度损失有望进一步降低。
对于希望在本地拥有一个可控、隐私、免费的强力 AI 助手的用户来说,这套方案提供了极具参考价值的实战路径。
相关推荐

Arsaze:把Cursor的Tab补全带到视频剪辑
Arsaze是一款AI原生视频编辑器,把Cursor的Tab补全交互带入视频剪辑:剪一次按Tab即可重复风格,还能删除转录文字来裁剪片段。本文解析其工作流、账户限制与评测结论。

GitHub会消亡吗?开源维护者倦怠与AI时代的协作危机
Lex Fridman播客讨论开源维护者倦怠与GitHub的困境:海量拉取请求压垮核心维护者,AI加剧代码膨胀。文章以数学期刊审稿与庞加莱猜想验证为类比,剖析知识生产中验证环节为何必须刻意缓慢,以及开源社区如何避免维护者退出的失败模式。

别再做千篇一律的AI网站:3个工具让编码Agent脱胎换骨
介绍三个提升AI编码Agent能力的工具:FFmpeg skill让Claude Code和Cursor本地剪辑视频,Hallmark用50套设计主题解决AI网站千篇一律的问题,Jailbreaks提供25种以上模型的提示词配置,并分析技能化扩展的共同逻辑。