7个Python特性:让代码变糟的陷阱

七个 Python 特性在错误场景下反而会让代码更难维护,关键在于理解其权衡边界。
文章结合资深开发者的实战经验,盘点了七个“用不好就变糟”的 Python 特性。property 伪装成字段却可能隐藏数据库查询等重操作,涉及 I/O 时应改用方法;dataclass 默认公开全部字段,无法守护业务规则,需要约束时应回归普通类;模式匹配在结构简单时属于杀鸡用牛刀;functools.cache 永不过期,会导致汇率等动态数据陈旧,应改用带 TTL 的 cachetools;装饰器堆叠会埋没业务流并把执行顺序变成隐性架构决策;async 具有传染性,应留在基础设施边缘,业务逻辑接收数据而非自行获取;slots 虽省内存却改变对象模型,仅适合海量小对象。核心观点是:特性和工具本身没有错,错在脱离场景使用。
Python 以简洁优雅著称,但有些特性一旦用错场景,反而会让代码更难维护、更易出错。一位资深开发者结合自己日常使用经验,列出了 7 个"用不好就变糟"的 Python 特性,并逐一分析其权衡取舍。
1. property:看似字段,实则暗藏重操作
property 非常适合轻量、可预测的计算属性,比如根据 first_name 和 last_name 拼出 full_name。但问题在于,它伪装成了普通属性访问。
如果一行 invoice.total 背后实际做了:建立数据库连接、拉取发票数据、查询税率、校验 VAT ID、再计算总额——那它就不再是"属性",而是一个完整的业务流程。开发者按字段访问的预期调用,却触发了昂贵的 I/O 操作,这种"惊喜"往往是 bug 的温床。
更合理的做法是改成普通方法,用 get_total() 这类命名明示"这是一次获取",必要时甚至声明为 async,让调用方对延迟有心理准备。核心原则:property 用于"像属性的行为",涉及数据拉取、API 调用或高开销操作时,请改用方法。
2. data class:便利背后是业务规则的流失
dataclass 能消除大量样板代码,实例化和打印都极其方便,并且从类定义就能一眼看出数据结构。问题在于,每个字段默认都是公开的。
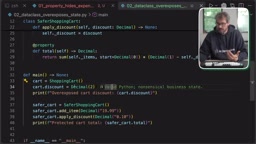
设想一个购物车 dataclass,包含 items 和 discount。由于没有任何约束,调用方可以传入 discount=2.0(即 200%)这种业务上毫无意义的数值。dataclass 只负责"打开所有字段",并不承担业务规则。
当对象需要守护业务规则时,应改用普通类,并提供方法来强制执行约束——比如 add_item 只在价格为正时生效,apply_discount 限制折扣在 0 到 1 之间。dataclass 依然适合配置、事件、值对象等场景,但不要把所有领域对象都变成 dataclass。
3. 模式匹配:结构匹配的好工具,却常被过度使用
Python 的 match 语法在需要匹配复杂结构时非常亮眼,比如判断用户是否为管理员,或按姓名及其组合返回不同结果。
但很多情况下,直接检查 is_admin 标志位,比一套模式匹配清晰得多。只有当行为预期会变得更复杂——比如未来需要组合多个条件——才值得引入模式匹配。能用简单方案解决时就别用复杂方案,可读性永远优先。
4. 缓存:functools.cache 的隐蔽陷阱
functools.cache 用起来简单到令人愉悦:加个装饰器就完事。但它有一个致命缺陷——缓存永不过期。
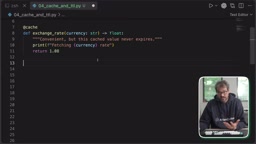
以汇率为例,一旦汇率变动,程序仍会读取旧值,直接导致数据陈旧和不一致。更稳妥的方式是显式控制缓存的生存周期和容量,例如使用 cachetools 库提供的 TTLCache,设定最大条目数和 TTL 值,再以几乎相同的方式装饰函数。缓存能显著提速,但你必须清楚它的边界在哪里。
functools.cache 是 Python 3.9 引入的无界缓存装饰器,它基于函数参数构建键值映射,等价于 lru_cache(maxsize=None)。正因为它不限制容量也不设置过期时间,任何一次调用结果都会被永久保留——函数的参数只要不重复,缓存条目就会持续累积。在长运行进程中,这既是内存泄漏的来源,也让缓存的语义变成“一旦算过,永远算对”。对于配置项、静态常量这类天然不变的数据,这种“永久记忆”是优点;但对于汇率、用户状态、外部接口返回等会随时间或环境变化的值,它就变成了静默的数据陈旧源,且不会报错,只会悄悄给出过期的结果。这也是为什么需要引入带 TTL(生存时间)和容量上限的缓存实现。
5. 装饰器:跨切面很优雅,堆叠却会埋没业务流
装饰器让日志、性能分析等横切关注点变得简洁。但当 4 个装饰器同时叠加在一个 create_account 函数上时,事情就失控了。
审计、重试、事务、权限校验层层包裹,函数体本身提供的信息远远不够。更麻烦的是,你必须理解 Python 的装饰器解析顺序(从下往上应用),才能判断执行次序——权限校验该放在重试之前吗?审计应该在函数真正执行时才触发吗?这些都变成了隐藏的架构决策。
装饰器适合横切行为,但别为了函数体好看,就把关键业务流程藏进装饰器里。
装饰器的解析顺序是理解其堆叠行为的核心。当你写下多个装饰器时,它们是从下往上依次应用到被装饰函数上的:最靠近函数的装饰器最先包裹原始函数,最上面的最后包裹。而执行时,控制流则从最外层(最上面)进入,逐层向内,直到原始函数,返回时再逐层向外。这意味着堆叠顺序直接决定了权限校验、重试、事务各自的时机和范围——把重试放在权限之前,会连权限失败也一起重试;把事务放在审计之外,审计就可能记录到未提交或已回滚的状态。这些顺序差异不会体现在函数签名里,却构成了隐性的架构决策,也是堆叠装饰器最容易失控的地方。
6. async:不要让它侵蚀业务逻辑
async 能并发执行 I/O 操作,让应用更具响应性。但它具有"传染性":一个 API 调用是 async,调用它的函数也变成 async,很快整个脚本都是 async。
作者建议把 async 视为基础设施层的关注点而非业务逻辑的关注点。一种做法是让业务逻辑保持同步,在边缘用适配器包装异步 API——比如用 asyncio.run 把异步的 fetch_profile 藏在一个同步方法后面。不过这种方案在已有事件循环的环境下会失效。
另一种更干净的方案是把数据获取与业务决策分离:decide_checkout 不再自己获取信用档案,而是直接接收 order 和 profile 作为参数。数据由 main 函数在异步边界处获取,再传入业务逻辑。
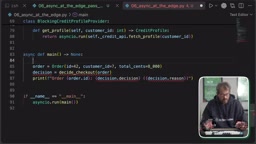
这样业务逻辑完全与基础设施解耦:async 留在边缘,逻辑保持纯净。
async 的“传染性”根源在于 Python 的协程模型:async def 定义的函数返回协程对象,必须由事件循环(event loop)驱动执行,而 await 关键字只能在 async 函数内部使用。因此一旦某一层是异步的,所有调用它的同步函数都必须改为 async,否则无法 await;这就是所谓的“函数着色”问题。事件循环本身是单线程的并发调度器,适合 I/O 密集型任务——网络请求、文件读写等待期间可以切换到其他任务。但它不适合 CPU 密集计算,那会阻塞整个循环。理解这一点,就能理解作者的主张:把 async 视为基础设施细节而非业务语义。业务逻辑本应只关心“做什么”,异步只是“怎么取数据”的实现方式,把两者分开,逻辑才可测试、可复用,也不会因为底层换了同步或异步的获取方式而被迫改写。
7. slots:优化对象模型,也改变了使用预期
slots=True 能优化 dataclass 的内存占用,代价是改变 Python 的对象模型——你无法再动态添加属性。比如给 point 加上 label 会直接报错,因为不再有可编辑的 __dict__。
这并非坏事。作者只在满足三个条件时才使用 slots:对象数量极多、确定不会动态加属性、且处于受控的内部模块。对于第三方系统会访问的类,则不建议使用。毕竟,动态赋值本身就不是好设计,它会丢失类型信息,让使用者无从判断对象包含哪些数据。保持代码严格一点,通常更可靠。
常见问题
property 和普通方法该如何选择?
判断标准是开销和可预测性。轻量计算用 property,涉及 I/O、远程调用或高开销操作时用方法,并可通过命名(如 get_xxx)或 async 明确提示调用方。
dataclass 还能用吗? 可以。它适合配置、事件、值对象等纯数据场景。但当对象需要守护业务规则时,应改用普通类并提供强制约束的方法。
缓存该怎么设置过期?
避免直接使用永不过期的 functools.cache 处理会变化的数据。改用 cachetools.TTLCache,显式设定 TTL 和最大容量。
slots 什么情况下值得用? 仅在你确定会有海量小对象、不会动态添加属性,且该模块不对外暴露时使用。否则它的性能收益有限,反而会改变开发者对类的预期。
相关推荐

Huberman理性补充剂指南:五层健康框架与科学决策法
斯坦福神经生物学教授Huberman提出理性补充剂框架:行为与营养是地基,基础复方补充作保险,睡眠/激素/认知方向坚持单品实验,Omega-3是单品首选,褪黑素不推荐。

镀金时代曼哈顿室内设计的幕后画家
HN 讨论聚焦镀金时代曼哈顿室内设计背后的画家:他创作壁画与装饰画,却因作品被视为建筑附属而长期被历史忽略。本文梳理其角色与署名困境。

AI Agent 也会被社交工程?看懂提示词注入与工具权限风险
通过 Invariant Lab 的 GitHub Issue 注入与 Brave 的 AI 浏览器攻击两个真实案例,解析 Prompt Injection 如何诱导 AI Agent 越权操作,并从最小权限、工具校验、操作审计三层给出防护建议。