8G显存本地部署Qwen3-VL 27B:接入ComfyUI生成视频保姆级教程

Qwen3-VL 27B凭借量化部署与ComfyUI接入,将多模态AI视频创作门槛降至8G显存。
阿里开源的Qwen3-VL 27B在Artificial Analysis复杂能力榜600余个模型中排名第26,属同体量模型第一梯队,单月下载近500万。文章介绍了一套完整的本地化AI视频创作方案:通过LM Studio加载GGUF量化版本实现低显存本地部署(最低6G显存可用),再将模型以节点形式接入ComfyUI,为MiniMax H3视频生成工作流自动产出高质量提示词。社区面向16G显存优化的量化版本在保留模型能力的同时降低推理压力,工作流内置低显存专属节点,使8G/12G显存用户也能完整运行"多模态理解 + 视频生成"的一体化链路,为AI视频创作者提供了实用的本地化解决方案。
Qwen3-VL 27B:27B体量里的第一梯队
阿里新一代开源权重模型Qwen3-VL 27B(视频中称“签问3.8/27B”)发布后迅速走红,单月下载量接近500万。它不只是一个对话模型,而是具备看图、理解视频、处理长文本与复杂指令的多模态能力,同时为低显存用户提供了量化版本。
在第三方模型评测网站Artificial Analysis的复杂能力榜单中,这款模型在600多个模型里排到第26名,而排在它前面的基本都是各家旗舰付费模型。这个成绩说明它并非“能跑就行”的小模型,而是在27B这个参数体量内真正属于第一梯队的选手。对于想在本地跑一个兼顾性能与硬件门槛模型的用户来说,这是一个颇具吸引力的选择。
多模态大模型(Multimodal LLM) 是指同时能处理文本、图像乃至视频等多种信息类型的大语言模型,区别于只接受纯文本输入的传统语言模型。Qwen3-VL中的"VL"即 Vision-Language 的缩写,代表它具备视觉-语言联合理解能力。参数量(27B = 270亿参数) 决定了模型的"容量"上限,通常参数越多、能力越强,但同时对显存和算力的需求也越高。量化(Quantization)技术通过将模型权重从高精度浮点数压缩为低精度整数(如INT4、INT8),可以在损失极少精度的前提下大幅减少显存占用,使原本需要80GB显存才能运行的旗舰模型,压缩到消费级显卡可接受的范围内。
本地部署:用LM Studio几步搞定
本地部署的核心逻辑并不复杂,关键在于选对模型版本与正确的文件组织方式。
第一步是下载与自己设备性能匹配的模型版本。显存不同对应的量化版本不同,8G甚至6G显存用户都能找到可用的量化方案。UP主提到会把模型版本选择建议与部署方法整理成文档,可在评论区获取。
第二步是下载并安装本地大模型工具LM Studio。安装完成后打开软件,进入通用设置页面找到“模型目录”,在这里指定你的模型存放路径,再把Qwen3-VL的GGUF格式模型导入。
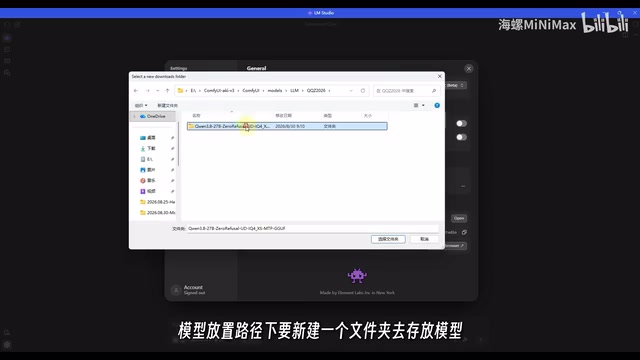
这里有个容易踩坑的细节:模型不能直接丢在根目录下,必须在模型路径下新建一个文件夹(比如命名为Qwen)再放入模型,否则LM Studio无法正确读取。UP主还给出一个节省硬盘空间的技巧——直接把模型放进自己的ComfyUI模型文件夹内,实现一个模型两头共用。重启LM Studio后,模型就能在本地直接运行了。
GGUF(GPT-Generated Unified Format) 是由 llama.cpp 项目定义的模型文件格式,专为本地推理优化设计。它将模型权重、量化参数及元数据打包进单一文件,方便分发和加载,已成为本地部署开源大模型的事实标准格式。LM Studio 是一款面向普通用户的本地大模型管理工具,提供图形化界面,支持直接加载 GGUF 文件并在本机 CPU/GPU 上进行推理,无需配置复杂的 Python 环境。与云端 API 调用相比,本地部署的优势在于数据不出本机、无需联网、无 token 费用,缺点是受限于本地硬件性能,推理速度通常慢于云端。
接入ComfyUI:给视频生成工作流提供提示词
本地跑通模型只是第一步,真正发挥创作价值的是把它接入ComfyUI,让它为MiniMax H3视频生成工作流自动生成提示词。
UP主已经做好了支持该模型调用的节点包,用户只需安装节点包,再安装llama-cpp和对应的轮子(wheel)文件即可,整个过程配有图文教程。
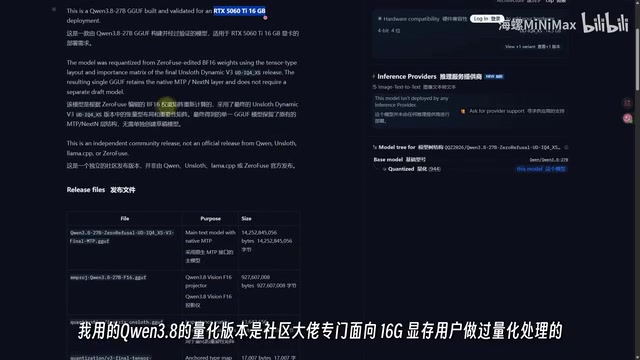
视频中使用的是社区大佬专门面向16G显存用户做的量化版本,特点是模型能力保留相对完整,同时显存压力更低、本地推理速度更舒服。
这个版本还有一个被反复强调的特性——Zero Refusal(零拒绝)。UP主对比了官方版本与越狱版本:面对相同问题,官方版本会直接拒绝回答,而无审查版本则做到了有问必答。这里需要提醒的是,这类“越狱”版本来自社区改造而非官方,使用时应注意合规边界与内容风险,本文仅客观陈述其技术特性。
ComfyUI 是一款基于节点图(Node Graph)的 AI 生成工作流编辑器,用户通过连接不同功能的"节点"来组建自动化流水线,广泛用于图像和视频生成任务。每个节点承担单一功能(如加载模型、输入提示词、采样、解码输出),节点之间通过连线传递数据,整个流程可视化且可复用。llama-cpp 是运行 GGUF 模型的底层推理引擎,而"轮子(wheel)"指 Python 的 .whl 安装包格式,安装对应 CUDA 版本的 wheel 文件能让 llama-cpp 调用 GPU 加速,显著提升本地推理速度。将 Qwen3-VL 以节点形式嵌入 ComfyUI,意味着多模态理解与视频生成可以在同一个工作流中自动串联,减少手动复制提示词的中间步骤。
工作流使用:低显存也能跑的视频生成
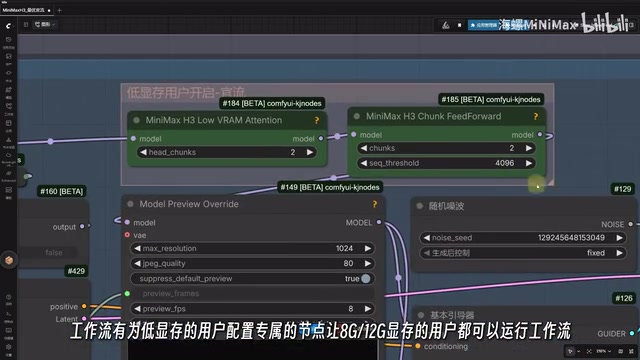
工作流的使用门槛被压得很低。拿到工作流后,先对应选择好模型。工作流中为低显存用户配置了专属节点,让8G、12G显存的用户也能顺利运行。
接下来调整视频生成的尺寸比例、所需秒数,上传参考图,然后在Qwen3-VL的推理模块中输入视频的大致内容描述即可。系统提示词UP主已经预先填好,普通用户无需改动。模型加载器处的推理强度可以根据需求自行选择,最后点击运行等待视频产出。
整套流程把“本地大模型 + 多模态理解 + 视频生成”串成了一条链路:用Qwen3-VL理解你的意图并产出高质量提示词,再交给MiniMax H3完成视频生成,对AI视频创作者而言是一套相当实用的本地化方案。
小结
这套方案的价值在于兼顾性能与门槛。Qwen3-VL 27B在同体量模型中排名靠前,配合量化版本和ComfyUI的低显存节点,把原本需要高端显卡的多模态创作下放到了8G显存的普通设备上。对想入门AI视频创作的新手来说,这是一个值得尝试的本地部署路径。相关模型下载建议、地址与工作流资源,UP主均在评论区提供。
相关推荐

Anthropic 官方揭秘:Opus 5.5 的 12 条提示词新规则
Anthropic 官方发布 Opus 5.5 提示词指南,涵盖 effort 默认档位、缓存保留、agents.md 支持、time matters 提速等 12 条实用技巧,帮你让 Claude 系统更快、成本更低。

用Claude Opus构建工具站:一个月上线130+工具并变现
本文详解如何用Claude Opus在一个月内构建并变现超过130个在线工具的网站,涵盖选题规划、框架搭建、AI代码生成、质量检查、规模化与AdSense联盟变现的完整步骤。

Claude Code Hooks完整教学:Event、Matcher、Handler三层架构详解
Claude Code Hooks完整教学,详解Event、Matcher、Handler三层架构。涵盖SessionStart、PreToolUse、PostToolUse、Stop等核心Event与五种Handler类型,附Git金钥检查、文章AI味检测实战案例及Codex差异说明。