8卡3090家用AI主机实测:600英镑一张,性能对标192GB新机

Reddit用户用8张二手3090攒出192GB显存家用推理集群,吞吐堪比商用设备。
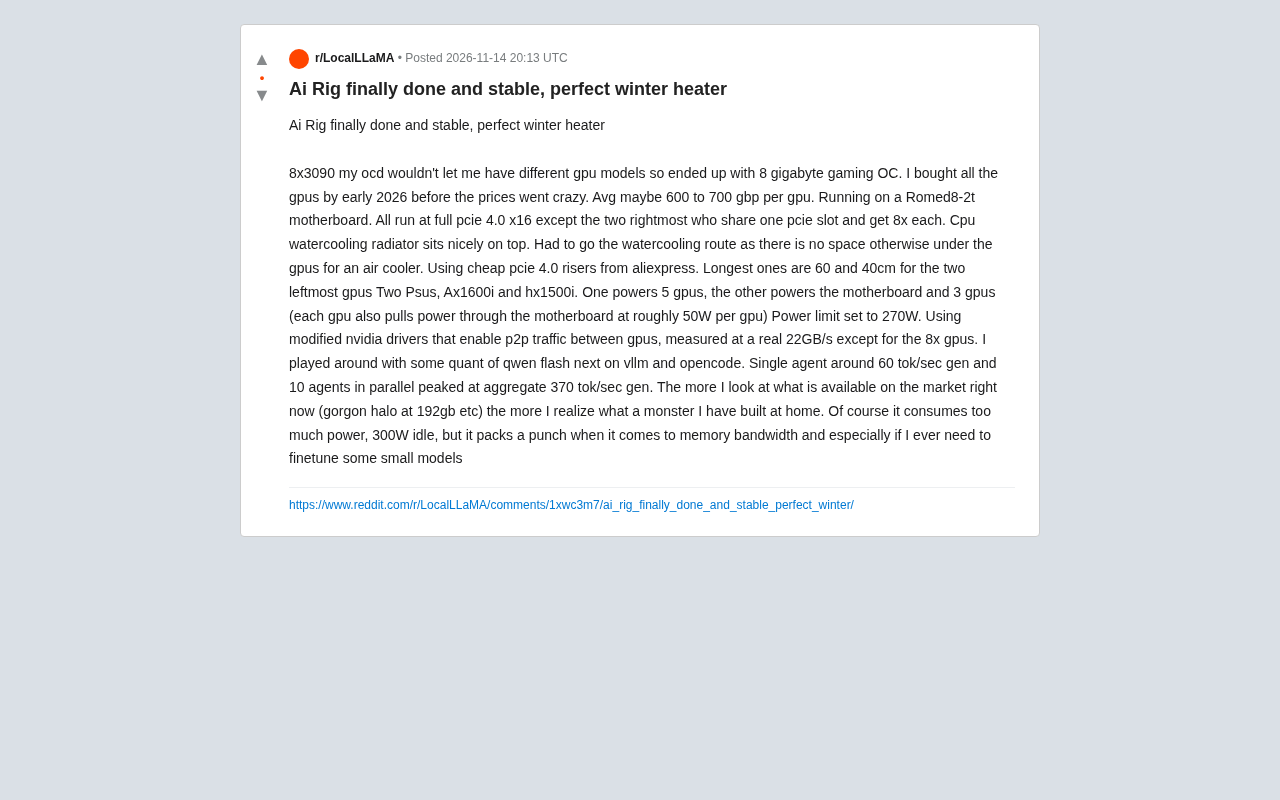
一位Reddit用户分享了8卡RTX 3090家用AI主机的搭建经历。他在涨价前以每张600至700英镑购入八张技嘉3090,总显存192GB,选用Romed8-2t服务器主板实现多卡PCIe 4.0 x16连接。由于显卡间距不足,风冷不可行,只能采用水冷方案,并以双电源分别供电、功耗限制270W。软件层面,他通过魔改NVIDIA驱动开启GPU间P2P直连,实测带宽22GB/s,并在vLLM上运行量化版Qwen模型,单智能体约60 tok/sec,10智能体并行聚合吞吐达370 tok/sec。待机功耗300W被戏称为冬季取暖器,但作者认为192GB显存在家用场景下仍具竞争力。
一位Reddit用户分享了他的8卡RTX 3090 AI主机搭建经历。这台被戏称为「完美冬季取暖器」的机器,用二手硬件堆出了堪比商用设备的推理性能,也揭示了当前AI硬件市场的一个尴尬现实:旧卡集群的性价比正在被重新审视。
为什么选择8张3090而非新卡
作者在2026年初、价格暴涨前购入全部显卡,平均每张600到700英镑。他坦言自己的强迫症「不允许混用不同型号」,最终八张全是技嘉Gaming OC版本。这个选择背后有一个朴素的计算:总显存达到192GB,而当时市场上同显存级别的新品价格远高于此。
主板选用Romed8-2t,这是一块面向服务器的板子,原生支持多卡并行。除最右侧两张共享一个PCIe插槽、各跑8x外,其余六张均以PCIe 4.0 x16满速运行。这种配置在消费级平台上几乎不可能实现,也是作者选择服务器主板的核心原因。
RTX 3090发布于2020年,基于Ampere架构,拥有24GB GDDR6X显存和936GB/s的显存带宽,是首款支持NVLink的消费级显卡之一。其关键优势在于显存容量与带宽的组合:单卡24GB在当时远超同代消费卡,而八卡并联即可达到192GB,接近部分专业推理服务器的显存规模。相比之下,新一代消费卡虽算力更强,但显存容量提升有限且价格高企,这使得二手3090在「大显存、低单价」这一维度上仍具吸引力,代价则是更高的功耗与更老的架构效率。
水冷是唯一出路
显卡之间的间距不足以容纳风冷散热器,作者被迫走上水冷路线。CPU水冷冷排被安置在顶部,空间利用得相当紧凑。转接线用的是速卖通上的廉价PCIe 4.0延长线,最左侧两张卡分别用了60cm和40cm的长线。
供电方案同样务实:两台电源,AX1600i负责5张卡,HX1500i负责主板加3张卡。每张显卡还会通过主板额外取电约50W,这个细节常被忽略,但对电源分配有实际影响。功耗限制设为270W,在性能与发热之间取了平衡。
魔改驱动释放P2P带宽
作者使用了修改版NVIDIA驱动,开启GPU之间的P2P直连通信。实测带宽达到22GB/s,只有那两张跑8x的卡例外。这一点对多卡推理至关重要——P2P能绕过主机内存,显著降低卡间数据传输延迟。
在软件栈上,他用vLLM和opencode跑了Qwen Flash的某个量化版本。单智能体生成速度约60 tok/sec,10个智能体并行时聚合吞吐峰值达到370 tok/sec。对一个家用集群来说,这个数字意味着可以同时服务多个并发请求,而不只是跑跑单轮对话。
P2P(Peer-to-Peer)直连通信指的是GPU之间通过PCIe总线直接交换数据,而无需经过CPU和系统内存中转。在标准的消费级NVIDIA驱动中,这一功能通常被禁用,原因是产品线区隔与稳定性考量。开启P2P后,多卡推理时张量并行所需的卡间通信延迟显著降低,带宽也远高于绕行主机内存的路径。对于vLLM这类依赖张量并行的推理框架,P2P往往是多卡扩展效率的瓶颈所在。文中实测22GB/s的带宽,接近PCIe 4.0 x16的理论上限,说明驱动魔改确实打通了直连通道,而跑在8x链路上的两张卡则因通道数减半而带宽受限。
vLLM是一个面向大语言模型推理的高吞吐服务框架,核心创新是PagedAttention——把KV Cache按页管理,像操作系统管理内存一样减少显存碎片,从而在同等显存下支撑更大的批处理规模。文中提到的「10个智能体并行」正是vLLM连续批处理能力的体现:多个请求被动态拼批,聚合吞吐因此远高于单请求生成速度。单智能体60 tok/sec与10智能体370 tok/sec的差距,反映的正是批处理带来的吞吐增益,而非单请求延迟的改善。
300W待机功耗与「怪物」的自嘲
作者自嘲这是「完美冬季取暖器」,待机功耗就有300W。但他也清醒地意识到,看看现在市场上的新品——比如192GB显存的Gorgon Halo——反而更觉得自己在家攒出了一头怪物。
这台机器的价值不在于跑分,而在于内存带宽和显存容量。如果未来需要微调小模型,192GB显存提供了足够的余地。对于预算有限但需要大显存的开发者,二手3090集群仍是一条可行路径,代价是功耗、噪音和搭建复杂度。
家用多卡集群的现实启示
这个案例折射出AI硬件市场的一个结构性矛盾:新卡显存越做越大,但价格也水涨船高;旧卡二手价格在涨价潮前相对友好,却需要用户自己解决散热、供电和驱动问题。作者的成功建立在几个前提上——涨价前入手、愿意折腾水冷、能找到服务器主板、以及接受300W的待机开销。
对多数人来说,复刻这套方案的门槛不低。但它至少证明了一件事:在家用环境下,8卡3090的推理吞吐可以支撑多智能体并发,而P2P驱动魔改是释放性能的关键一步。
相关推荐
感恩节甜点新创意:山核桃焦糖奶油酥皮点心
美食创作者 Carolina Gelen 分享咸焦糖山核桃奶油酥皮点心做法,在罗马尼亚传统甜点 creme schnitte 基础上加入山核桃,适合感恩节餐桌。文章详解焦糖熬制、卡仕达回温、酥皮处理与糖渍山核桃的制作要点。

KDE纪录片上线:开源桌面社区的自述
KDE社区自制纪录片在Hacker News引发讨论,本文分析开源项目为何需要影像化的自述、PeerTube发布选择的意义,以及纪录片对开源桌面生态文化延续的价值。

谷歌的化学元素命名梗:从Argon到Krypton,Gemini模型版本名玩脱了?
谷歌Gemini模型被曝用Argon、Carbon、Hydrogen等化学元素命名,Reddit网友调侃即将发布Krypton、Oxygen乃至整张元素周期表。本文分析这一命名策略背后的用户困惑与AI产品版本管理问题。