90%的Agent只会聊天不会干活:真Agent的三层架构与落地铁律

真正能干活的Agent需具备感知、决策、执行三层能力,并内置纠错闭环,而非简单的套壳对话机器人。
市面上大多数"Agent"本质上仍是对话机器人,听得懂指令却无法完成从理解到执行的完整闭环。真正能落地的Agent必须同时具备感知层(读取多模态输入)、决策层(拆解任务、规划步骤)和执行层(安全调用真实工具)三层能力。其中任务拆解是最易被忽视却最关键的环节,跳过它是Agent频繁跑偏的主因。此外,实战中第一次执行几乎不可能全对,因此真Agent的核心不是"从不犯错",而是内置"执行—校验—反思—修正—记忆"的纠错闭环。要将Agent真正部署到生产环境,还需遵守七个避坑点和三条铁律,尤其要保留人类的最终否决权与关键链路熔断机制,方能在真实业务场景中稳定运行。
为什么大多数Agent只是「套壳对话机器人」
市面上号称能「干活」的Agent,绝大多数不过是包了一层壳的对话机器人。它们听得懂你说什么,却走不完从理解到执行的完整闭环——听懂指令是一回事,真正把事情做完是另一回事。
判断一个Agent是不是「真能干活」,关键看它是否具备完整的执行链路。真正能落地的Agent,不只是听懂指令,还会自己规划步骤、自己动手调用工具,出了错还能自我修正。这套配合就像人的神经系统,缺一层都不行。
换句话说,随便套一个大模型加几个API,并不能称之为Agent。它可能会「说」,但不会「做」,更不会在做错时「救自己」。
真Agent的三层能力:感知、决策、执行
一个能干活的Agent必须同时具备三层能力,缺一不可:
- 感知层:像眼睛和耳朵,文本、语音、图像都能读取理解;
- 决策层:像大脑,会自己规划步骤、拆解任务、排定执行顺序;
- 执行层:像手脚,能直接调用工具,把动作真正落地。
以「帮我订明天去上海的机票」为例:感知层先听懂你的需求;决策层把它拆成查航班、比价格、选舱位几个子步骤;执行层则真正去调用订票接口,一步步完成下单。三层全部协同运转,才算完成了一次真实的任务闭环。
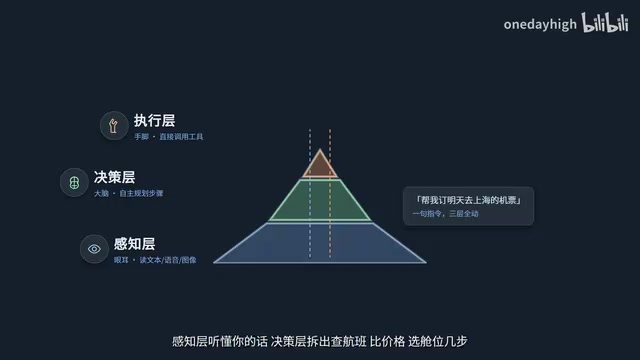
这里最容易被忽视的是任务拆解。拿到一个模糊的大需求时,靠谱的Agent第一步不是直接硬干,而是先拆成多个可落地的小任务,校验每个任务的可行性,再排好执行顺序。很多Agent之所以「跑偏」,正是因为跳过了这一步,直接一头扎进去。
决策层通常依赖规划算法来实现任务拆解与排序。当前主流方案包括 ReAct(Reasoning + Acting)框架——让模型在每一步先"想"再"动",把推理过程显式写出来;以及 Plan-and-Execute 模式——先一次性生成完整计划,再逐步执行。两者的核心差异在于是否允许中途动态修改计划:ReAct 每步都可以根据最新结果重新推理,灵活性更高但开销也更大;Plan-and-Execute 更高效,但面对意外情况时容错能力相对较弱。理解这一层的设计取舍,有助于判断某个 Agent 框架是否适合你的具体场景。
安全可控地调用真实工具
光会拆解还不够,能干活的Agent必须能安全可控地调用真实工具。写代码、跑命令、查文档,每一步都不是嘴上说说,而是真的在运行环境里留下可验证的结果。
很多用户遇到的「只会说、不会动」的Agent,恰恰卡在了工具调用这一关。它能描述该怎么做,却无法真正执行,或者在调用工具时频频出错——参数写错、权限不够、结果不对,都是实战中的常态。
纠错闭环:真Agent的核心不是不犯错
实战中,Agent第一次执行几乎不可能全对。如果让它一条路走到黑,百分百翻车。有人部署的Agent跑崩三次就直接退出,完全不知道怎么救——这正是缺少纠错机制的典型表现。
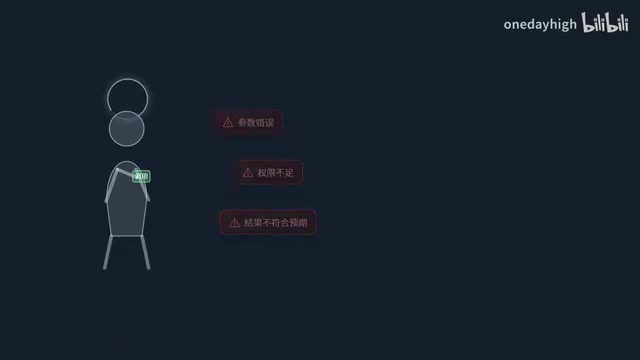
真正能干活的Agent,核心不是「从不犯错」,而是自带纠错闭环:执行完会自己校验结果,发现不对就反思哪里错了,修正参数再重新跑,直到拿到符合要求的结果。
更进一步,反思出来的经验会被写进记忆——短期记忆保存当前上下文,长期记忆存下历史教训,下次不再踩同一个坑。这套「执行—校验—反思—修正—记忆」的循环,才是Agent能真正落地的核心。
这里提到的记忆机制在工程实现上有明确分层。短期记忆通常就是模型的上下文窗口(Context Window),存放当前会话的对话历史和中间结果,随会话结束而清空。长期记忆则需要借助外部存储,常见方案是向量数据库(如 Chroma、Pinecone),将历史经验转换为向量后存储,需要时通过语义检索召回相关片段注入上下文。值得注意的是,长期记忆的质量直接决定 Agent"不踩重复坑"的能力上限——如果写入的反思过于模糊,检索时就很难命中真正有用的历史教训。因此,反思阶段生成的经验摘要需要足够具体,最好包含失败原因、修正方式和适用条件。
一个真实的生产场景:快递分拣
抽象的架构落到具体场景更容易理解。以快递分拣为例:
- 感知:传送带上的包裹,Agent用摄像头一扫,就能识别哪个面单破损;
- 决策:判断包裹不能正常分拣,需要转人工处理;
- 执行:机械臂将包裹分流进复核槽,并自动上报工单。
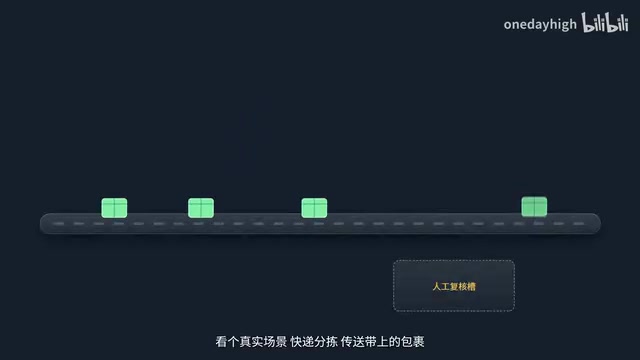
这个流程的关键在于:处理不了的交给人,关键动作有人兜底,每一步都有迹可查。这才是在真实生产环境里干活的样子,而不是实验室里的Demo。
七个一线避坑点与三条铁律
要把Agent真正部署到生产环境,有一份实战避坑清单值得参考:
- 别让Agent拿到全量高危权限;
- 任务拆解力度不能太粗;
- 必须加执行超时中断;
- 工具使用前做参数校验;
- 每步执行留完整日志;
- 结果校验规则要可量化;
- 给人类留最终否决权。
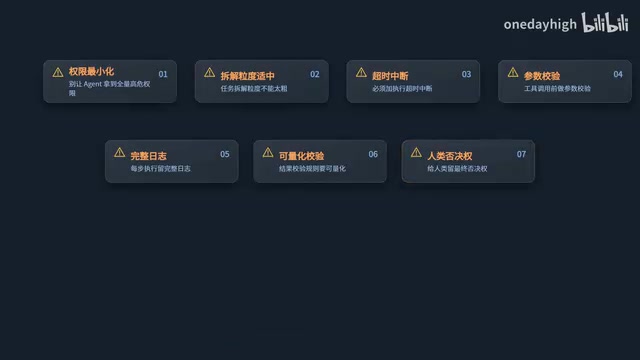
在此之上还有三条铁律:工具别贪多,工具越多Agent越容易选错;单个Agent够用就别急着上多Agent,避免过度设计;关键链路加熔断,连续失败就停下报警,别硬闯。
熔断机制(Circuit Breaker)借鉴自分布式系统设计:当某个服务或操作连续失败达到阈值时,系统主动"断开"该路径并触发告警,而不是无限重试直至资源耗尽或造成级联故障。在 Agent 场景中,这一机制尤为关键——一个没有熔断的 Agent 遭遇工具调用异常时,可能陷入死循环、不断消耗 Token 和 API 配额,甚至在有副作用的操作(如发邮件、写数据库)上反复执行错误动作。合理的熔断策略通常包括:设定单次任务的最大重试次数、单步执行的超时上限,以及触发熔断后的降级行为(停止执行并通知人工)。
判断标准与上手建议
总结下来,一个能真正干活、可以放进生产环境的Agent,应当满足五个条件:会拆解复杂任务、能安全调用工具、出错会自我修正、每步都留可追溯日志、不越权且能替人做关键决策。用这五条对照,就能分清哪些是真能用的Agent,哪些只是概念炒作。
那该从哪入手?最好的方式是从一个真实的小需求开始。哪怕先用框架写一个五到八行的最小循环,亲手跑通一次「拆解—调用—校验」的流程,也比读十篇科普更有价值。
Agent不会取代开发者,但未来的赢家,一定是那些懂得驾驭Agent的人。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。