9050份AI剧本实测:拆解AI写作的「套话」与评测偏见
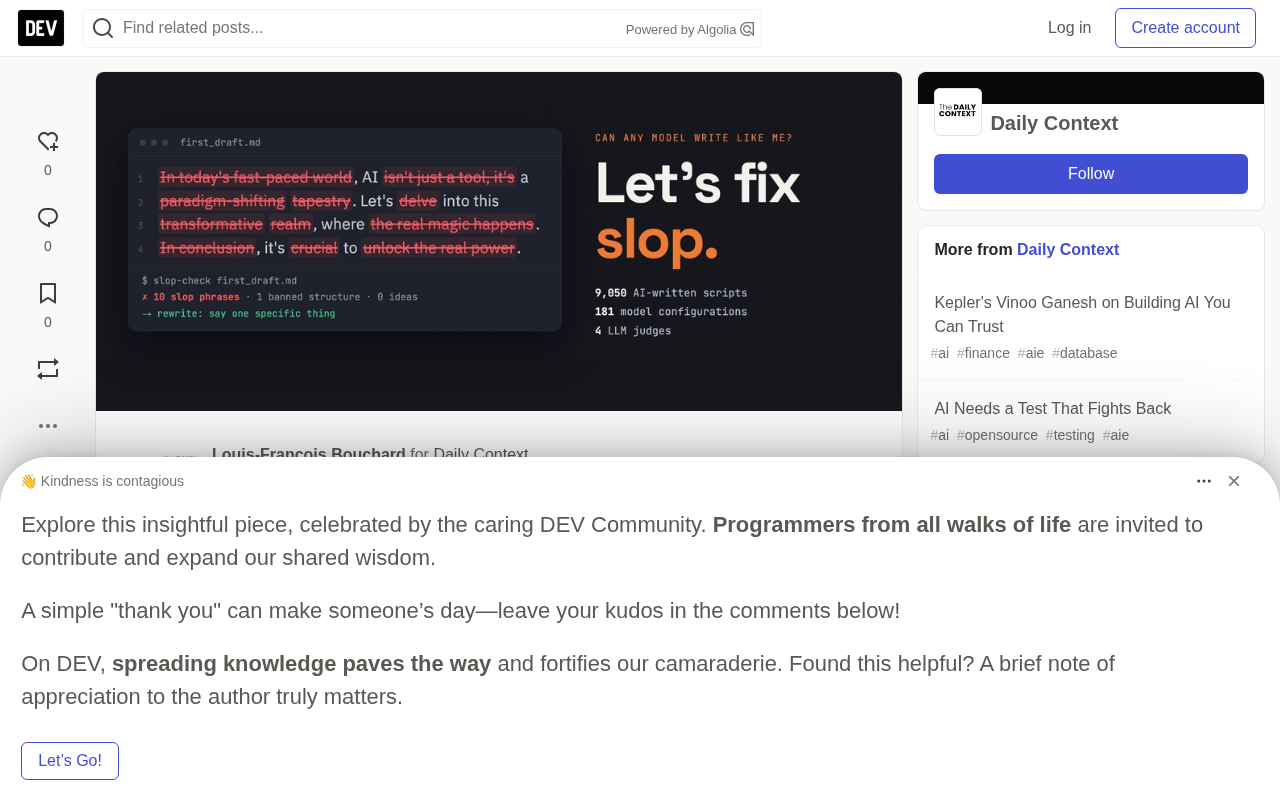
9050份AI脚本评测显示:套话易除,声音难仿,多草稿加跨实验室裁判更划算。
作者用9050份脚本和181种配置,建立了一个围绕“像我一样写作”的评测体系。结果发现,slop套话可以通过详细提示词有效控制,GPT-6 Astra在slop上得分最高,但整体仍不像作者本人;真正难点是tone and voice,Claude系列因此占据前11名。成本方面,Opus 5.5从xhigh到max价格涨4倍、分数提升不到1%,而便宜开源模型GLM-5.3 Flash生成多份草稿挑最好,可接近Opus 5.5且便宜约20倍。所有LLM裁判都有实验室偏好,必须用跨实验室评审团。作者据此给出写作流水线:长指令、正反例、代码检查禁用短语、多草稿生成、跨实验室裁判挑选合并,以及最后的人类把关。
你大概已经读过太多版本的这段话了,可能这周就读过:
“在当今快节奏的世界里,AI不仅仅是一个工具,它是一幅颠覆范式的织锦。让我们深入这个变革的领域,真正的魔法就在这里发生。”
Towards AI 团队如今大量使用 AI 起草视频、课程、书籍和文章,数量以千计。团队几乎一切都用 Claude,但需要审阅的内容常常听起来就像上面那段。从六月起,作者开始量化“哪些模型能真正像我一样写作”。在 9050 份脚本之后,一个意外发现是:这些“套话词”其实很容易修掉。
实验设置:把“我的声音”变成评分标准
作者选取了自己的十份视频脚本,其中一些已发布、一些被留存以防数据污染。四个人花了近一个月、约 400 小时,把它们打磨成尽可能清晰详细的评分规则(rubric),并把“它们为什么有效”转化为可评测的标准。
评测时,模型可以获得作者的 voice guide、storytelling guide、输出规则、过往范例、brief 和研究材料,看它能否重新生成像样的内容。随后由四个 LLM 裁判分别打分:一个 GPT、一个 Claude、一个开源模型,以及最近加入的 Jev。
截至目前已测量 181 种配置,覆盖所有 thinking level,并计划覆盖后续所有新模型。作者强调,最重要的不是榜单本身,而是构建这个新基准、审阅数千次生成、反复迭代 rubric 后学到的结论。
rubric(评分规则)与 LLM-as-judge:rubric 在这里不是简单的打分表,而是把“这篇稿子为什么有效”拆解成可复现、可逐条核查的维度,例如声音一致度、结构清晰度、禁用短语命中率、论证密度等,每个维度都配有权重和判定示例。LLM裁判(LLM-as-judge)则是让大模型按同一份 rubric 给生成结果打分,成本远低于人工、可大量重复,但已知存在位置偏好、长度偏好和“偏爱自家输出”等偏差。因此作者才需要多裁判评审团、并在评分前尽量固定 rubric 与提示词,让分数变化主要反映模型能力,而不是评判过程中的噪声。
套话少,不等于写得好
前 15 名配置在 slop 检查上都超过 90 分,也就是说,只要提示词足够详细,类似开头那种句子基本能被控制住。181 个配置中,“最干净”的模型是 GPT-6 Astra(max effort),slop 得分 94.9。
但要小心:slop 只是其中一个指标。Astra 目前在总榜上排第 62,因为它不像作者本人:tone and voice 只有 82,而 Opus 是 90。Claude 系列整体占据了前 11 名。
作者的核心体会是:删掉几个“Claude 腔”只是一次快速编辑,烦人但一个 pass 就能修;重建一个声音则不然,需要大量脑力、重构文本、更换例子,所以目前写东西仍然倾向用 Claude。
slop 与 tone and voice 的区别:slop(套话)通常指那些高频、空洞、可跨语境套用的表达,例如“在当今快节奏的世界里”“颠覆范式的织锦”“让我们深入探索”等。它更像是文本表面的填充物,删掉或替换成具体信息即可修复。tone and voice 则指向更深层的写作人格:句子节奏、用词偏好、举例习惯、论证展开方式,以及作者对什么话题会自然兴奋或克制。一个模型可以几乎没有 slop,却仍然不像你,因为它只是换了一套干净但陌生的声音。这也是为什么 slop 得分高只说明文本“不油”,并不等于“像我”。
Max effort 的边际收益非常小
Opus 5.5 在 max effort 下是测得最好的写作者,90.8 分(满分 100)。而在 xhigh 档,得分 90.0,每份脚本成本 0.69 美元,而不是 2.75 美元。
也就是说,价格涨了 4 倍,分数提升不到 1%。作者的选择是默认用 xhigh,只在每句话都很重要的少数稿件上开 max。
便宜模型改变了“工作单位”
开源权重模型 GLM-5.3 Flash 得分 88.2,每份脚本 1.5 美分。Opus 5.5 在 max 下贵将近 190 倍,分数只高约 3%。
这不只是“用 GLM 生成类似写作便宜近 200 倍”,而是说:用对方法,你可以用开源模型生成比 Claude 更好的结果,同时更便宜。团队还测量了不同生成之间的方差:如果用 GLM 生成 10 份草稿并挑最好的一份,结果会与 Opus 5.5 极其接近,而且仍然便宜 20 倍。如果再加一个强裁判、配上好 rubric,并能把不同草稿的段落合并成“最强缝合稿”,理论上会明显优于 Opus 5.5,同时成本更低。
作者的结论很直接:生成现在很便宜,挑选才是难点。把钱花在评判和挑选上,而不是生成上。
pass@k 与多草稿择优:当单次生成足够便宜时,更有效的策略不是追求“一次就写对”,而是生成 k 份草稿,再从中挑选最好的一份,这对应代码生成评测中常用的 pass@k 思想。GLM-5.3 Flash 这类开源权重模型单篇成本极低,因此可以用数量弥补单次质量差距:生成 10 份草稿后,最优草稿往往能与更贵模型的一次输出相当。若再引入强裁判按 rubric 挑选,甚至把多份草稿中各自最好的段落拼接成“缝合稿”,整体质量还可能超过单一昂贵模型。核心变化在于,生成不再是瓶颈,评判、选择和合并才是新的成本中心。
每个裁判都偏爱自己的实验室
相比其他裁判,GPT 裁判会给 OpenAI 的稿子加 2.75 分,并从 Anthropic 的稿子上扣 2.14 分。DeepSeek广告 裁判会给 DeepSeek 和 Kimi 加约 1 分。Claude 裁判的倾斜最小,约为其他裁判的一半,但它仍偏袒自家,而且令人意外地更喜欢 Google。Jev 相对中立,也略微偏好 Gemini 模型,但它无法为自己的评分给出理由,这让它在这些任务上不够稳定,作者猜测可能是因为写作更偏向“系统 2”式评判。
没有裁判是中立的。用评审团,绝不要让写作者所属实验室成为唯一打分者。
我会采用的 AI 写作流水线
选模型的标准不是“写得最惊艳”,而是“用最少编辑就能到达目标、且不让你抓狂”。然后:
- 写很长、非常具体的指令:你的声音、结构、规则。
- 展示该怎么做,以及不该怎么做。点名你讨厌的短语,并在代码里检查草稿,而不是信任提示词。
- 附上你过去最好的作品全文,最好再说明它们为什么好。
- 用便宜的开源模型生成多份草稿。
- 让来自另一个实验室的高思考档裁判,按清晰 rubric 挑选或合并最好的部分。
- 用另一个裁判跑一到两轮 review-and-edit。超过两轮,作者没看到太多帮助。
- 最后保留人类。即便是 Opus 5.5 的草稿也需要人。
一个前提:这套测量的是作者本人在自己脚本上的声音,只是一个数据点,不是真理。切换任何东西之前,先用自己的写作测试。构建这套评测流水线非常有用,团队已经把它改用到许多客户的定制任务上,效果很好。
作者将在 10 月 13 日(周二)10:40 的 Turing room — Evals Track 演讲中发布完整基准 ToneBench,包含每个数字背后的方法论。
为什么需要跨实验室评审团:大模型裁判的偏好往往与其训练来源、对齐目标和风格倾向相关,表现为给自家模型更高分、给竞争实验室模型更低分。这种偏差即使裁判模型本身很强,也不会自动消失,因为它在“什么算好文字”上带有系统性口味。让写作者所属实验室的模型单独打分,等于让同一套偏好既当运动员又当裁判。更稳妥的做法是使用来自不同实验室的多个裁判,必要时取平均或投票,并要求裁判按明确 rubric 给出逐项理由。若某个裁判无法解释评分依据,它的分数就应被降权,因为不可解释的偏好会放大噪声。
相关推荐

Meta与出版商的AI数据之争:服务条款修改引爆互联网未来之战
Meta修改商业账户服务条款,允许用关联网站数据训练AI模型,引发出版商和创作者强烈反弹。媒体行业组织联名致信扎克伯格,Meta被迫删除"训练"措辞并推迟条款生效。这场争议揭示了AI时代数据授权与互联网未来的深层博弈。

当Outside Xbox遇上血染钟楼:Minecraft里的军团对局
Outside Xbox嘉宾Ellen和Mike做客Minecraft版《血染钟楼》,迎战军团恶魔局。三名好人如何在信息噪音中对抗多数邪恶?本文解析军团机制、信息角色博弈与终局逆转。

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。