阿拉伯方言数学推理基准DAR-MGSM发布:文化本地化如何难倒大模型

DAR-MGSM首次系统评测大模型在阿拉伯方言数学应用题上的表现,揭示文化本地化带来的推理挑战。
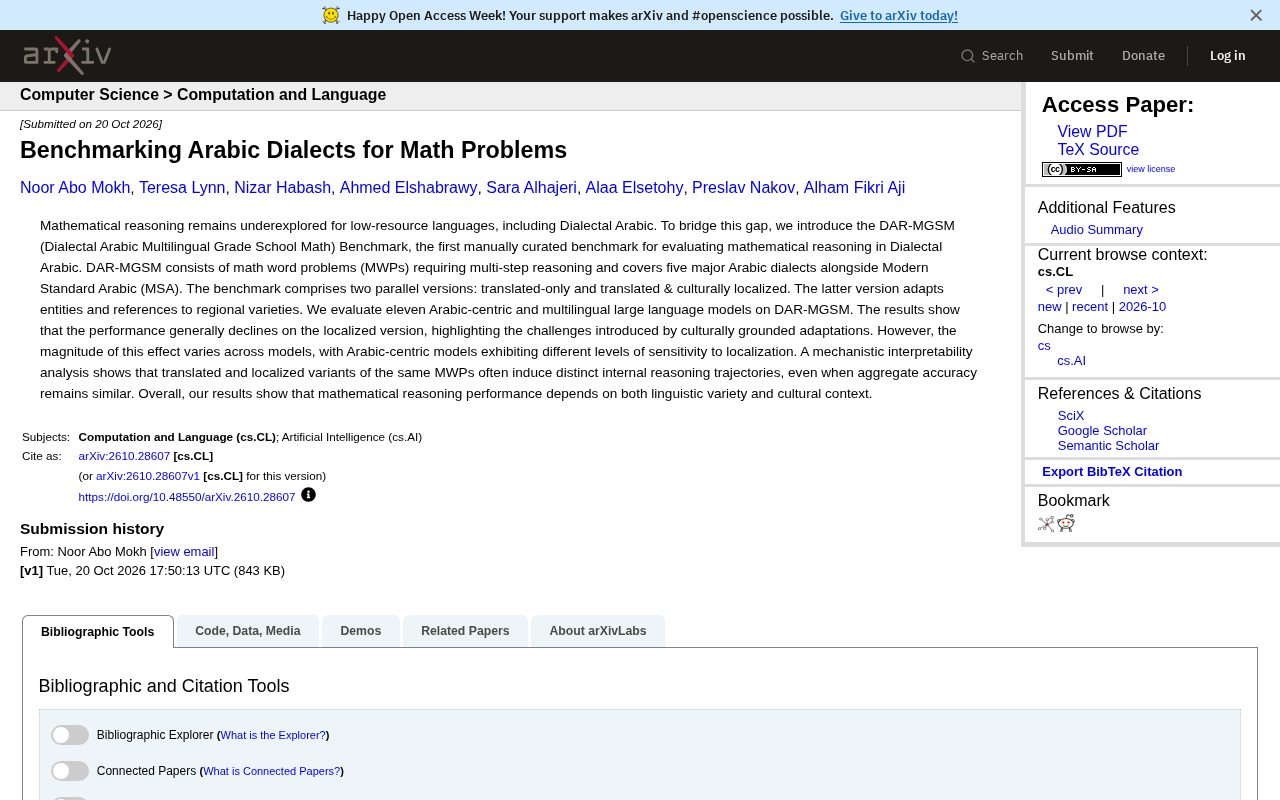
DAR-MGSM是首个覆盖五大阿拉伯方言和现代标准阿拉伯语的数学推理基准,包含翻译版与文化本地化双版本。对十一款模型的评测显示,文化本地化版本上性能普遍下降,且下降幅度因模型而异。机制可解释性分析进一步发现,同一题目的两个版本即使准确率相近,模型内部推理轨迹也常显著不同。该基准提示多语言推理评测应将语言变体和文化语境作为独立维度测量,而非笼统归入多语言性能。
数学推理能力在大模型中一直是衡量智能水平的关键标尺,但现有评测几乎集中在英语等高资源语言上,对低资源语言尤其是阿拉伯方言的覆盖近乎空白。最近,一项名为 DAR-MGSM(Dialectal Arabic Multilingual Grade School Math) 的基准测试填补了这一缺口,它首次系统性地评估了大型语言模型在阿拉伯方言数学应用题上的表现,并揭示了一个容易被忽视的维度——文化本地化带来的挑战。
为什么阿拉伯方言的数学推理值得单独评测?
阿拉伯语世界存在显著的双言现象:现代标准阿拉伯语(MSA)用于正式书写和教育,而日常交流则使用埃及、海湾、黎凡特、马格里布和马什里克等五大方言。对于大模型而言,方言文本在词汇、句法和文化指代上与MSA差异巨大,直接套用MSA的训练数据往往失效。数学应用题又比一般文本更复杂——它要求多步逻辑推理,同时依赖对题目中实体和场景的理解。如果模型不熟悉方言中的日常表达,即使数学能力再强,也可能在第一步就卡住。
DAR-MGSM的出发点正是:语言变体本身就会显著影响推理表现,而这一点在以往的基准中被系统性忽略了。
双言现象(diglossia) 是社会语言学中的核心概念,指同一语言社群在不同场合使用两种功能分化的语言变体。在阿拉伯语世界,现代标准阿拉伯语(MSA)是《古兰经》、新闻、教育和正式文书的载体,而日常口语则是各地域方言。二者在音系、词汇和句法上差异显著,甚至可视为不同语言。对于语言模型而言,MSA语料在网络上占绝对主导,方言数据稀缺且拼写不规范,导致模型在方言输入上出现分布偏移。数学应用题又高度依赖对场景实体(人名、货币、单位)的理解,方言中的这些表达往往与MSA截然不同,因此单纯依赖MSA训练数据难以泛化到方言场景。
基准设计:平行翻译与本地化双版本
DAR-MGSM的核心设计颇具巧思。研究者构建了两个平行版本:
- 翻译版(translated-only):将数学应用题从源语言直译为五种阿拉伯方言和MSA。
- 翻译并文化本地化版(translated & culturally localized):在翻译基础上,将题目中的人名、货币、度量单位、生活场景等实体替换为对应地区的常见表达。
两个版本题目在数学结构上完全一致,唯一变量是文化语境。这种控制变量法让研究者能够干净地分离出“文化本地化”对模型推理的独立影响。
控制变量法 在基准构建中体现为:两个版本保持数学结构、数值和解题步骤完全一致,仅改变文化实体(如人名、货币、度量单位、生活场景)。这种设计使得任何性能差异都可归因于文化本地化这一单一变量,而非题目难度或语言复杂度。在自然语言处理评测中,此类平行对照设计常用于分离语言形式与语义内容的影响,例如机器翻译中的形式化 vs. 语义化评估。DAR-MGSM将这一思路迁移到数学推理,使得“文化语境”成为可量化的实验变量,而非模糊的背景因素。
十一款模型实测:本地化版本普遍更难
研究团队在DAR-MGSM上评测了十一款以阿拉伯语为中心和多语言的大模型。整体结论明确:模型在文化本地化版本上的表现普遍下降。这意味着,当题目从“字面翻译”走向“文化适配”,模型需要额外调动对地区常识的理解,推理难度随之上升。
不过,下降幅度因模型而异。以阿拉伯语为训练重心的模型表现出不同程度的敏感性——有的相对稳健,有的则对本地化改动反应剧烈。这暗示模型对文化语境的适应能力并非简单随参数规模增长,而与训练数据的语言分布和文化覆盖密切相关。
可解释性分析:准确率相似,推理路径却分道扬镳
更值得关注的是论文中的机制可解释性分析。研究者发现,同一道数学题的翻译版和本地化版,即使最终准确率接近,模型内部激活的推理轨迹也常常截然不同。换句话说,表面上的“答对了”可能掩盖了底层推理过程的差异。
这一发现对评测方法论提出了警示:仅看准确率数字可能低估文化因素的作用。两个版本在模型内部触发了不同的计算路径,说明文化语境不是无关紧要的装饰,而是深度参与推理构建的变量。
机制可解释性(mechanistic interpretability) 旨在通过分析模型内部神经元、注意力头或激活向量的模式,理解其计算过程。常见方法包括探测分类器、因果追踪和激活补丁。在DAR-MGSM的分析中,研究者比较同一数学题在翻译版与本地化版下模型各层的隐藏状态轨迹,发现即使最终答案正确,中间表征的相似度也可能很低。这表明模型可能通过不同“电路”解决表面相同的问题,而准确率指标无法捕捉这种内部差异。该发现呼应了可解释性研究的一个核心观点:行为等价不等于机制等价,评测需结合内部表征分析才能全面评估模型能力。
对多语言AI评测的启示
DAR-MGSM的意义超出了阿拉伯语本身。它提供了一个可复用的评测范式:在低资源语言上评估推理能力时,语言变体和文化语境应当作为独立维度被测量,而不是笼统地归入“多语言性能”。对于正在推进阿拉伯市场产品或研究中东语言理解能力的团队,这一基准也给出了更贴近真实使用场景的测试工具——用户不会用MSA做日常数学题,他们用的是自己熟悉的方言和本地化的生活场景。
数学推理的跨语言评测,正在从“翻译够不够准”走向“文化接不接地气”。DAR-MGSM把这个问题摆上了台面。
相关推荐

Claude Pro不含API权限?Max与Team计划新增API额度详解
Claude Pro订阅不含API访问权限,API需单独计费。但Max和Team计划现已包含每月API额度:Max 5x为100美元,Max 20x为200美元,Team每席位最高合计500美元。本文详解各档位额度、领取方式及对开发者的影响。

隔离环境实测35万星REA:4秒装完,但两个坑要当心
隔离实验室实测35万星开源逆向工程工具REA:4秒安装、15秒列出截图工具全部外联地址、梳理565个通信通道,同时暴露写入用户级设置与31个高风险工具权限两个坑,附三条安全使用规则。
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
一位开发者因Adobe提前取消费转向逆向工程,用AI Coding Agent几周内做出7款开源替代品。本文解析逆向工程原理、Reverse Engineer Anything这个MCP Server六天破10万星的原因,以及AI克隆应用在性能、专有数据和法律层面的真实边界。