阿拉伯语流式语音识别频繁断句?技术解析与应对方案

阿拉伯语流式STT频繁误判句尾,根源在于方言与训练数据不匹配及端点检测策略局限。
一位开发多语言实时翻译应用的开发者发现,同一套基于Deepgram的流式STT系统在英语和西班牙语上运行正常,却在阿拉伯语上频繁出现"半句断句"——系统过早判定发言结束,导致语义被截断。这一问题的本质是流式语音识别中端点检测(Endpointing)与识别准确率之间的经典工程矛盾。改用整句处理可显著提升准确率,但代价是近两秒的额外延迟,在实时对话场景中体验明显下降。问题的深层原因在于:主流STT模型以现代标准阿拉伯语(MSA)为主要训练数据,而实际口语使用的是各地方言,两者之间存在显著的"双言现象"鸿沟,导致模型置信度下降、端点检测频繁误触发。应对策略包括按语言差异化配置静音阈值、引入语义级端点检测、利用中间结果做增量翻译与回滚等。
问题背景:流式STT为何在阿拉伯语上翻车
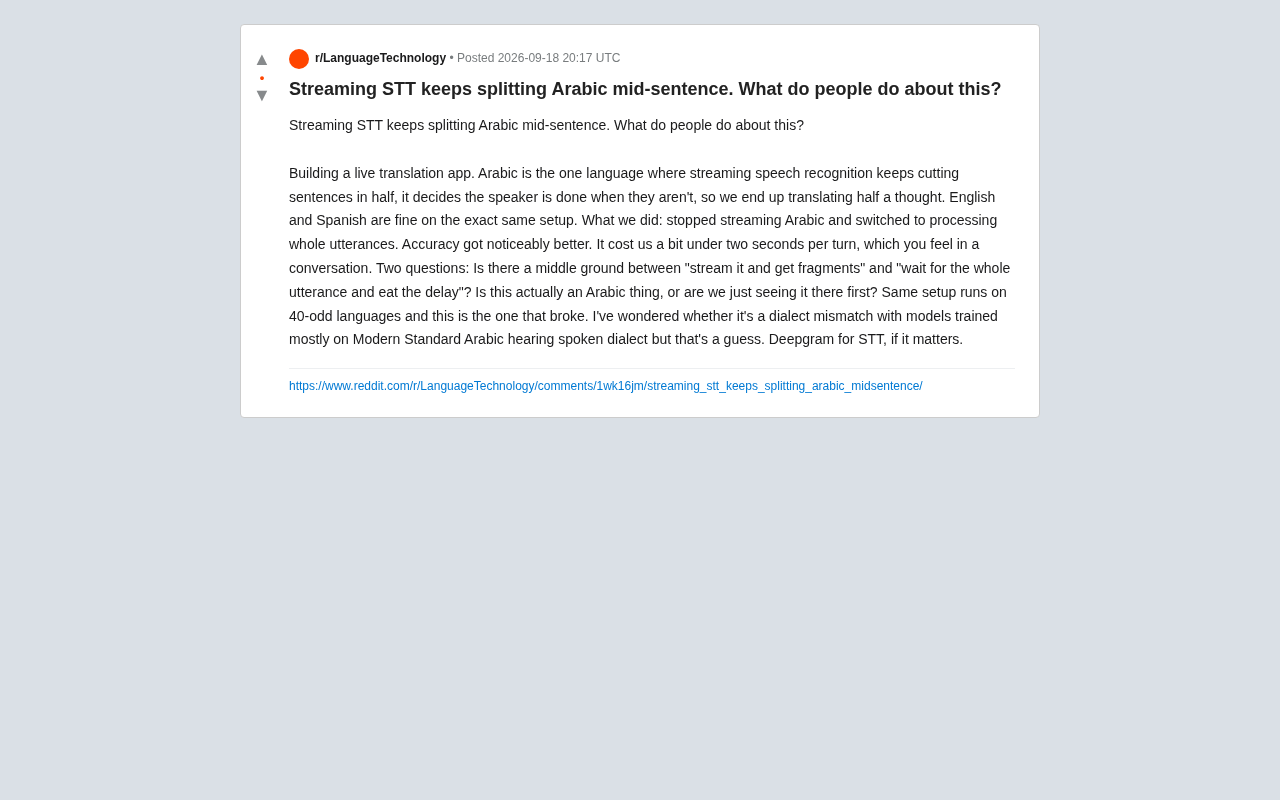
一位正在开发实时翻译应用的开发者在Reddit上抛出了一个棘手的问题:在同一套技术栈下,英语和西班牙语的流式语音识别(Streaming STT)表现良好,唯独阿拉伯语频繁出现"半句断句"的现象——系统会错误判断说话者已经结束发言,结果只翻译了半个意思。
这位开发者使用的是 Deepgram 作为语音识别引擎,整套系统支持40多种语言,但只有阿拉伯语出现了这种问题。他最终的临时解决方案是:放弃对阿拉伯语的流式处理,改为处理完整语句(whole utterances)。准确率明显提升,但代价是每轮对话增加了接近两秒的延迟,在实时对话场景中这种延迟相当明显。
核心矛盾:延迟与准确率的权衡
这个案例本质上暴露了流式语音识别中一个经典的工程矛盾——端点检测(Endpointing)与识别准确率之间的取舍。
流式STT依赖"端点检测"来判断一句话何时结束,通常基于静音时长(VAD,语音活动检测)和语言模型的置信度。当系统误判静音为句子结束时,就会过早提交结果(premature finalization),导致语义被拦腰截断。
开发者提出了一个关键问题:在"流式处理拿到碎片"和"等待完整语句吃下延迟"之间,是否存在中间地带?
答案是肯定的。业界常见的折中方案包括:
- 调整端点静音阈值:延长判定句子结束所需的静音时长,减少误判,但会略微增加延迟。
- 利用中间结果(interim results):先输出临时转写结果,在最终确认前持续修正,翻译层面可采用"增量翻译+回滚"策略。
- 语义级端点检测:结合语言模型判断句子是否语义完整,而不仅依赖静音,避免在语义未闭合处切断。
- 动态缓冲窗口:对特定语言设置更宽松的缓冲区,平衡响应速度与完整性。
VAD(Voice Activity Detection,语音活动检测)是流式STT系统的底层组件,负责将音频流切分为"有声"与"静音"两段,是端点检测的第一道判断。传统VAD基于能量阈值或过零率等信号特征工作,对背景噪声和非典型发音较为敏感。现代系统通常在VAD之上叠加语言模型置信度评分,只有当声学信号静音且语言模型也认为当前上下文"可以成句"时,才最终触发端点提交。这种双重机制在英语、西班牙语等训练数据丰富的语言上工作良好,但一旦遇到模型欠拟合的语言,语言模型的置信度判断失准,整个端点逻辑就会退化为几乎只靠VAD兜底,误触发率大幅上升。
这真的是"阿拉伯语特有"的问题吗
开发者的第二个疑问更具普遍价值:这究竟是阿拉伯语的固有特性,还是只是恰好在这门语言上先暴露出来?
他自己给出了一个合理的猜测——方言与训练数据的不匹配。当前主流语音模型大量基于现代标准阿拉伯语(Modern Standard Arabic, MSA)训练,而实际口语中人们使用的是各地方言(如埃及方言、海湾方言、黎凡特方言等)。当模型"听到"与训练语料差异较大的口语方言时,声学与语言模型的置信度都会下降,端点检测因此更容易出错。
这个推断具有相当的技术合理性。阿拉伯语的几个特征可能加剧问题:
语言结构层面
阿拉伯语存在丰富的词内停顿、喉音和长元音,这些声学特征可能被VAD误判为句间静音。此外,阿拉伯语的语序和连接词使用方式与英语、西班牙语差异较大,基于英语中心训练的端点逻辑未必适用。
数据分布层面
MSA与口语方言之间存在"双言现象"(Diglossia)——书面语和口语几乎是两套系统。如果模型的训练重心偏向MSA,处理日常口语时的整体鲁棒性都会打折扣,断句只是最先被察觉的表征之一。
双言现象(Diglossia)由语言学家查尔斯·弗格森(Charles Ferguson)于1959年正式提出,专指同一语言社区中高变体(H-variety)与低变体(L-variety)并存、分工明确的状态。阿拉伯语是教科书级别的案例:现代标准阿拉伯语用于新闻、官方文件和正式演讲,而日常交流中人们使用与MSA在语音、词汇、语法上均有显著差异的地区方言。对STT模型来说,这意味着即便在MSA上取得高准确率,也不能外推到口语场景——两者之间的声学分布差距,有时不亚于两门不同的语言。这也是为什么"阿拉伯语支持"在技术指标上需要进一步细分:模型究竟在哪种阿拉伯语上做了验证,直接决定其实际可用性。
给同类项目的实践建议
对于正在构建多语言实时系统的开发者,这个案例提供了几点可借鉴的思路:
按语言差异化配置。不要用一套端点参数套用所有语言。阿拉伯语这类问题语言应单独调优静音阈值和缓冲策略,而非全局统一。
评估模型的方言覆盖能力。在选择STT供应商时,明确询问其阿拉伯语模型对口语方言的支持程度。若目标用户使用特定方言,优先选择针对该方言优化或提供自定义训练的方案。
分场景选择流式或整句模式。在对延迟不敏感的场景(如会议记录)可采用整句处理保准确率;在对话场景则需在延迟可接受范围内寻找端点参数的甜蜜点。近两秒的延迟对实时对话确实偏高,可尝试将静音阈值控制在合理区间。
建立可回滚的翻译流程。允许翻译结果在STT修正后更新,能在很大程度上缓解流式碎片带来的语义割裂问题。
小结
这个来自一线开发者的真实困惑,折射出多语言语音技术在非英语语言上的普遍短板。阿拉伯语的断句问题既有语言学上的客观原因(方言与MSA的鸿沟),也有工程实现上端点检测策略的局限。目前尚无完美的"银弹",但通过差异化参数配置、语义级端点判断和增量翻译等手段,开发者完全可以在延迟与准确率之间找到更优的平衡点。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。