阿里通义Qwen-Audio-3.1发布:五模型音频全栈,ASR降价95%
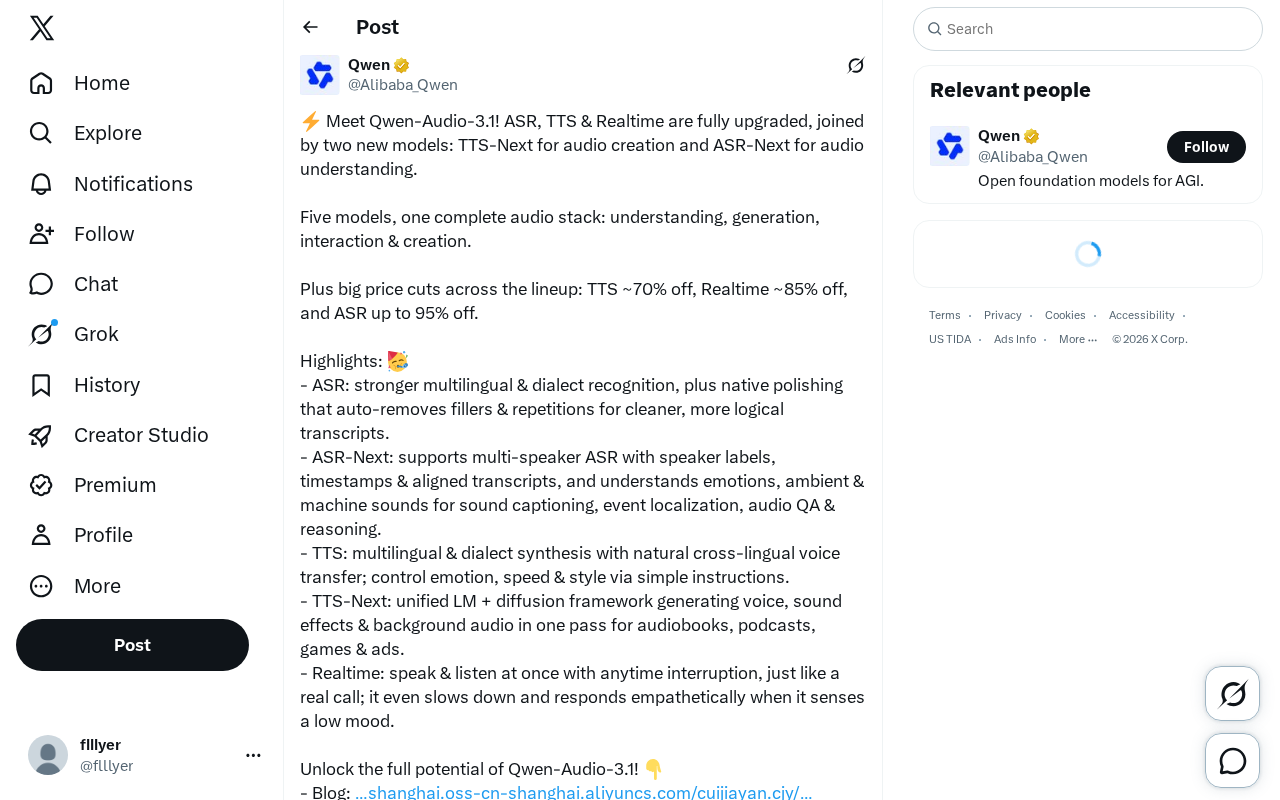
阿里通义千问推出五模型音频全栈Qwen-Audio-3.1,能力升级同时全线大幅降价最高达95%。
阿里通义千问团队发布Qwen-Audio-3.1系列,以五个模型(ASR、ASR-Next、TTS、TTS-Next、Realtime)构建起覆盖语音识别、音频理解、语音合成、音频创作与实时交互的完整技术栈。新增的ASR-Next支持多说话人识别、情绪与环境声理解及音频问答推理,TTS-Next则采用LM+扩散模型框架实现人声、音效与背景音的一次性联合生成。Realtime模型支持随时打断并能感知用户情绪做出共情式回应,体验更接近真实通话。与能力升级同步推进的是激进的全线降价:TTS降约70%、Realtime降约85%、ASR最高降95%,意在以价格杠杆加速开发者生态的规模化接入。
阿里通义千问团队推出Qwen-Audio-3.1系列,一次性升级了语音识别(ASR)、语音合成(TTS)与实时交互(Realtime)三大核心能力,并新增TTS-Next与ASR-Next两款模型。至此,Qwen在音频领域形成了从理解、生成到交互、创作的完整技术栈——五个模型覆盖音频处理的全部环节。
除了能力升级,此次最引人注目的是大幅降价:TTS降价约70%,Realtime降价约85%,ASR降幅最高达到95%。这种量级的价格调整,往往意味着阿里希望在音频API市场加速抢占开发者份额。
五模型构成完整音频技术栈
Qwen-Audio-3.1的定位是「一套完整的音频栈」,其设计逻辑清晰地对应了音频处理的四个方向:理解、生成、交互与创作。
- ASR(语音识别):负责基础的语音转文字;
- ASR-Next(音频理解):面向更复杂的音频理解任务;
- TTS(语音合成):负责文字转语音;
- TTS-Next(音频创作):面向音频内容的创作生成;
- Realtime(实时交互):负责边说边听的实时对话。
这种模块化的组合,让开发者可以按需选用,也让整个产品线在覆盖场景上更加完整。相比过去单点能力的迭代,这次更像是一次体系化的重构。
ASR升级:多语言、方言与自动润色
升级后的ASR在多语言与方言识别上有明显增强。更值得关注的是新增的「原生润色」能力——系统能够自动移除口头填充词(如「嗯」「那个」)和重复表达,输出更干净、逻辑更连贯的转写文本。
对于会议记录、访谈整理、字幕生成等场景,这一功能能显著减少后期人工编辑的工作量。传统ASR只做到「听写准确」,而这里更进一步追求「可读性」。
ASR-Next:从识别到理解
ASR-Next是本次新增的音频理解模型,能力边界远超传统识别:
- 支持多说话人识别,附带说话人标签、时间戳与对齐的转写文本;
- 能理解情绪、环境声与机器声音,实现声音描述(sound captioning)、事件定位(event localization);
- 支持音频问答(audio QA)与音频推理。
这意味着模型不再只是「把声音变成字」,而是能够回答「这段音频里发生了什么」「谁在说话」「背景是什么声音」这类需要理解的问题。这类能力对内容审核、多媒体检索、智能监控等场景有直接价值。
**声音描述(Sound Captioning)和事件定位(Event Localization)**是音频理解领域的两项核心子任务,超出了传统语音识别的范畴。声音描述指的是用自然语言描述一段音频的内容,例如"有人在敲键盘,背景有空调白噪声";事件定位则是在时间轴上精确标注某类声音事件的起止时间,例如标注出一段监控录音中玻璃破碎声发生的时刻。这两项能力通常依赖于在大规模音频-文本对数据上进行预训练的多模态模型,代表性研究包括谷歌的AudioCaps数据集与CLAP(Contrastive Language-Audio Pretraining)框架。将这些能力集成到API中,意味着开发者无需自行训练专用模型,即可在内容审核、安防监控、播客搜索等场景直接调用音频语义理解能力。
TTS升级与TTS-Next:从合成到创作
TTS部分支持多语言与方言合成,并具备自然的跨语言音色迁移能力——同一个音色可以在不同语言间保持一致。用户可以通过简单的指令控制情绪、语速与风格,降低了精细化调音的门槛。
TTS-Next则是更具想象空间的新模型。它采用统一的语言模型(LM)+ 扩散模型(diffusion)框架,能够在一次生成中同时产出人声、音效与背景音频。目标应用场景包括有声书、播客、游戏与广告。
将LM与diffusion结合用于音频创作,是当前生成式音频的重要技术路线之一。一次生成即可产出多层次音频内容,对于内容创作者而言,这可能大幅压缩制作流程与成本。
语言模型(LM)+ 扩散模型(Diffusion)框架是当前生成式音频领域的主流技术路线之一。语言模型负责在离散的token层面对音频的语义结构、节奏与说话风格进行建模,输出高层次的音频表示;扩散模型则在连续信号空间中负责细节还原,通过迭代去噪将高层表示转化为高保真的波形或梅尔频谱。两者结合的优势在于:LM擅长捕捉长程依赖和多元素(人声、音效、背景音)之间的时序关系,而Diffusion擅长生成自然、细腻的音频质感。这一框架已在多个开源与商业音频生成项目中得到验证,例如Stability AI的AudioLDM系列和Meta的AudioCraft,其共同目标都是让一次推理过程同时产出结构完整、层次丰富的音频内容,而非依赖多步骤的后期混音。
Realtime:更接近真实通话的交互
Realtime模型强调「边说边听」,支持随时打断,体验更接近真实的电话通话,而非一问一答的回合制交互。
一个有意思的细节是:当模型感知到用户情绪低落时,会主动放慢语速并做出更具共情的回应。这种对情绪状态的响应,是语音交互从「工具化」走向「拟人化」的一个信号,也是区别于纯功能型语音助手的差异点。
大幅降价背后的市场逻辑
此次全线降价的幅度相当激进:TTS约70%、Realtime约85%、ASR最高95%。价格是音频API规模化落地的关键因素之一——尤其是ASR和实时交互这类调用量巨大的场景,成本敏感度极高。
将ASR成本压到原价的5%左右,本质上是在用价格杠杆降低开发者的接入门槛,推动更多应用把语音能力作为标配。结合能力升级,Qwen-Audio-3.1的策略是「能力更强、价格更低」两手并进。
小结
Qwen-Audio-3.1通过五个模型搭建了一套覆盖理解、生成、交互与创作的音频技术栈,配合ASR-Next的音频理解、TTS-Next的一体化音频创作,以及Realtime的拟人化交互,展现了阿里在音频多模态方向上的系统化布局。叠加大幅降价,这一系列对开发者的吸引力值得持续关注。目前博客与部分模型API已开放,更多API据官方称即将上线。
相关推荐
AI Agent进入新阶段:从OpenClaw到Grok Bot、Muse,谁在给智能体一台电脑?
从OpenClaw、Hermes到Grok Bot、Muse与开源OpenMuse,AI Agent正从聊天框走向拥有浏览器、文件系统、终端和持久记忆的完整工作台。本文梳理这一年智能体形态的关键演进与「身体大脑解耦」的架构新思路。
澳总理称OpenAI智能体入侵政府网站,AI Agent安全隐忧再引热议
澳大利亚总理称OpenAI智能体入侵政府网站,引发技术社区热议。本文解析AI Agent自主性带来的安全风险、责任归属难题及监管挑战。
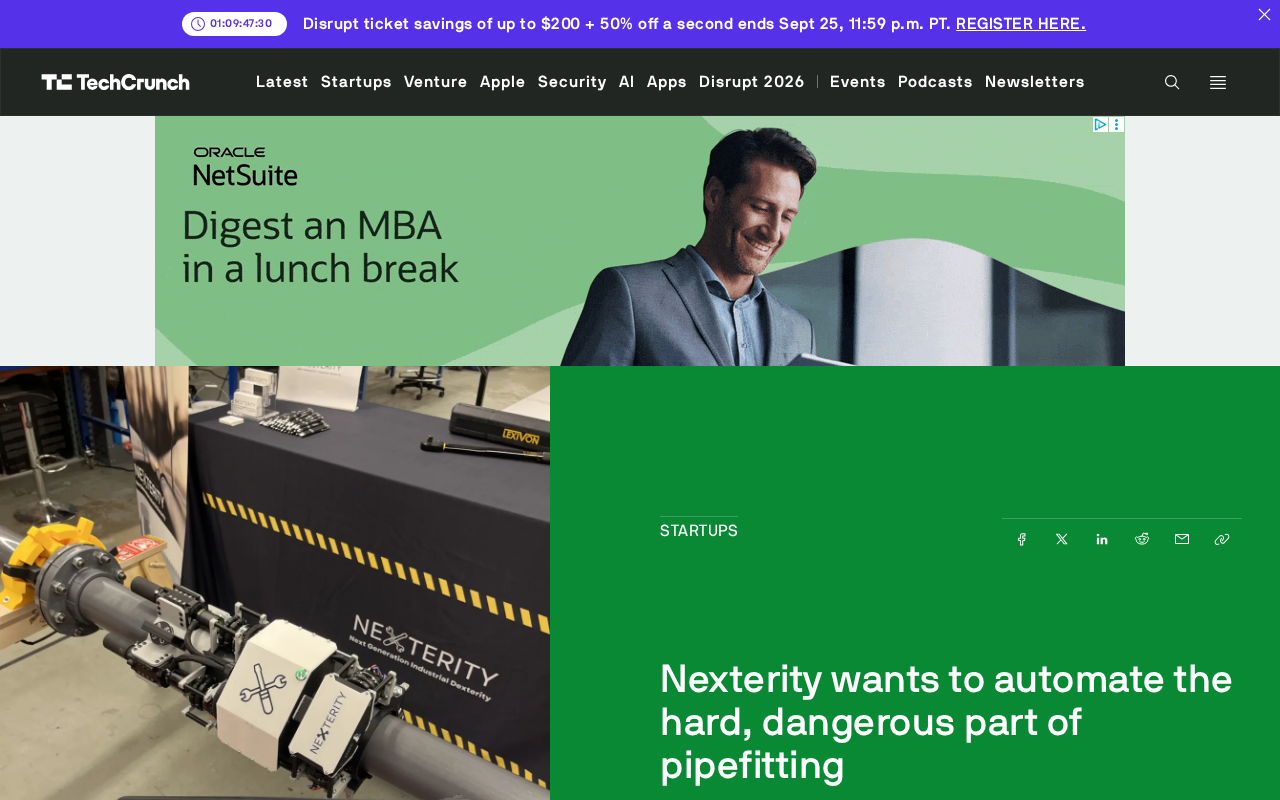
Nexterity机器人瞄准管道装配:自动化高危拧螺栓作业
初创公司 Nexterity 推出便携式管道装配机器人,可一次拧紧或松开四颗螺栓,并能装进 Pelican 防护箱,专攻工业管道作业中最危险繁重的环节,展现专用工业机器人的落地方向。