Adam优化器与自然梯度下降的几何距离有多远?

新研究用几何度量揭示Adam偏离自然梯度的程度与问题条件数强相关,但偏差不损害最终收敛。
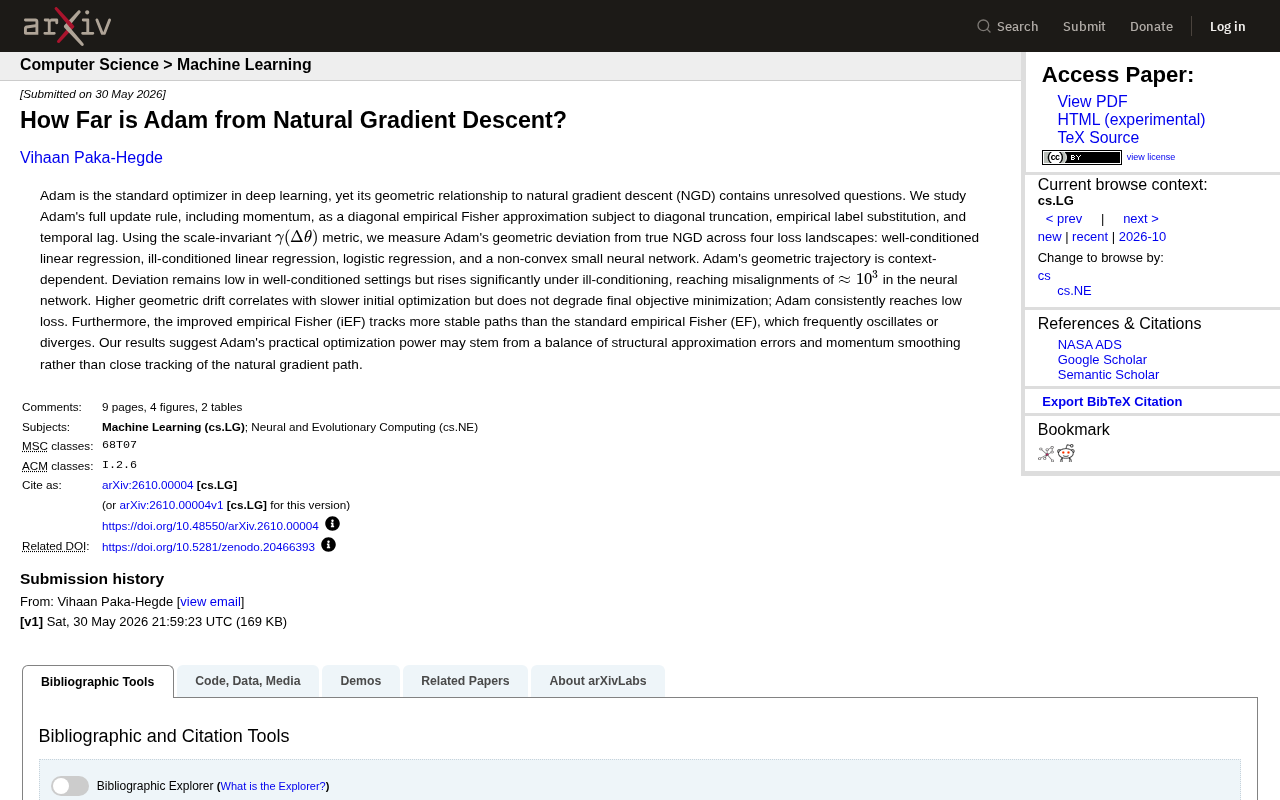
一篇arXiv新研究(arXiv:2610.00004v1)系统分析了Adam优化器与自然梯度下降(NGD)之间的几何距离。研究将Adam更新规则解析为受对角截断、经验标签替换和时间滞后三重约束的对角经验Fisher近似,并在四类损失曲面上用尺度不变度量进行验证。核心发现是:Adam与NGD的几何偏差高度依赖于问题的条件数——良态问题下偏差极小,而在非凸神经网络中方向错位可达约$10^3$量级。然而,更高的几何漂移只拖慢初期收敛速度,并不妨碍最终收敛到低损失。研究据此提出,Adam的优化威力可能源于结构性近似误差与动量平滑之间的平衡,而非对自然梯度路径的精确追踪,为理解这一广泛使用的优化器提供了新的理论视角。
一个被忽视的理论问题
Adam早已成为深度学习训练的默认优化器,几乎每一个主流模型的训练脚本中都能看到它的身影。但一个基础问题长期悬而未决:Adam在几何意义上,究竟距离理论上更优雅的**自然梯度下降(Natural Gradient Descent, NGD)**有多远?
一篇发表于arXiv的新研究(arXiv:2610.00004v1)正面回应了这个问题。研究者将Adam的完整更新规则——包括动量项在内——拆解为一种对角经验Fisher近似(diagonal empirical Fisher approximation),并指出它在实践中受到三重约束:对角截断(diagonal truncation)、经验标签替换(empirical label substitution)以及时间滞后(temporal lag)。这三者共同决定了Adam与真正NGD之间的偏差程度。
自然梯度下降(NGD) 由Amari于1998年提出,其核心思想是在参数空间中用Fisher信息矩阵(Fisher Information Matrix, FIM)对梯度进行预条件化,使更新方向不依赖于参数的任意重参数化。直觉上,普通梯度下降沿欧氏空间的"最速下降"方向移动,而自然梯度则沿概率分布空间(由KL散度定义的黎曼流形)的"最速下降"方向移动。这使得NGD在理论上具有参数化不变性——无论你如何重新表达模型参数,更新方向保持一致。然而,完整FIM的计算复杂度为 $O(p^2)$($p$ 为参数量),对现代深度网络完全不可行。Adam可以被视为一种极度简化的NGD近似:用梯度平方的指数移动平均(即 $v_t$)来估计Fisher矩阵的对角元素,从而以极低成本实现某种"自适应学习率"效果。
用几何度量衡量偏差
研究采用了一个尺度不变的度量指标 $\gamma(\Delta\theta)$ 来测量Adam更新方向相对于真实NGD方向的几何偏离。之所以强调"尺度不变",是因为优化过程中步长和参数规模变化剧烈,只有不受尺度影响的度量才能公平比较不同阶段、不同任务下的方向一致性。
作者在四类损失曲面上进行了系统测试:
- 良态线性回归(well-conditioned linear regression)
- 病态线性回归(ill-conditioned linear regression)
- 逻辑回归(logistic regression)
- 非凸的小型神经网络
这种从简单到复杂、从凸到非凸的梯度设计,使得研究能够清晰定位几何偏差随问题难度上升的变化趋势。
偏差高度依赖于问题的条件数
结果最核心的发现是:Adam的几何轨迹是情境相关的(context-dependent),没有一个统一的"偏离常数"。
在良态设定下,Adam与NGD的方向偏差很小,几乎可以视为对自然梯度的良好逼近。但一旦进入病态问题,偏差显著上升;而在非凸小型神经网络中,这种方向错位甚至达到约 $10^3$ 的量级。换句话说,在最接近真实深度学习场景的任务里,Adam走的路径与理论上的自然梯度路径相距甚远。
这一结论颇具反直觉色彩——Adam在实践中表现优异,却并不是因为它紧贴着自然梯度的"正确方向"前进。
条件数(condition number) 是衡量一个问题对输入扰动的敏感程度的指标,定义为矩阵最大特征值与最小特征值之比 $\kappa = \lambda_{\max}/\lambda_{\min}$。在优化语境中,损失曲面的条件数越高,意味着不同参数方向上的曲率差异越悬殊——曲面在某些方向上极为陡峭,在另一些方向上则极为平坦。这种"峡谷形"地貌正是普通梯度下降收敛缓慢的根本原因,也是二阶方法(如NGD)能够大幅加速的场景。Adam在良态问题(低条件数)上偏差小,是因为各方向曲率相近时,对角近似已足够;而在病态问题(高条件数)上,Fisher矩阵的非对角元素携带的方向信息至关重要,对角截断导致的误差就会急剧放大,与真实NGD的方向偏差也随之显著上升。
几何漂移不等于性能损失
研究进一步揭示了一个关键的解耦关系:更高的几何漂移只拖慢了初期优化速度,却并未损害最终的目标函数最小化。
无论方向偏差多大,Adam始终能够收敛到较低的损失值。这意味着方向上的"不精确"并不致命——Adam最终总能抵达好的解,只是前期可能走得更迂回一些。这为"为什么一个近似如此粗糙的方法却如此好用"提供了实证层面的解释。
此外,研究对比了两种Fisher近似方式:改进经验Fisher(improved empirical Fisher, iEF) 相比标准经验Fisher(EF) 能够追踪更稳定的路径。标准EF在实验中频繁出现震荡甚至发散,而iEF表现得更为平滑可靠。这对后续优化器设计提供了有价值的参考方向。
经验Fisher(Empirical Fisher, EF)与改进经验Fisher(iEF) 的核心区别在于标签的来源。标准EF使用模型在训练数据上观察到的真实标签来估计Fisher矩阵,即 $\hat{F} = \mathbb{E}_{x,y\sim\mathcal{D}}[\nabla\log p(y|x)\nabla\log p(y|x)^\top]$;而理论上正确的Fisher信息矩阵应从模型自身的预测分布 $p(y|x;\theta)$ 中采样标签。这一替换看似细微,却会带来梯度估计的偏差,在训练初期或模型预测与真实标签分布差异较大时尤为明显。iEF通过从模型当前预测分布采样标签来计算Fisher近似,从而避免了这种"经验标签替换"引入的额外误差,使优化路径更接近真实自然梯度轨迹,在实验中也表现出更低的震荡和更稳定的收敛。
Adam的真正威力来自哪里
综合这些实验证据,研究给出了一个富有启发性的论断:Adam的实际优化能力,可能源于结构性近似误差与动量平滑之间的某种平衡,而非对自然梯度路径的精确追踪。
这个观点重新定义了我们对Adam的理解。长期以来,人们倾向于用"Adam近似二阶信息"来解释它的效果。但本研究表明,动量带来的平滑作用、以及对角近似所引入的误差,二者相互抵消、相互调和,共同构成了Adam的鲁棒性。它更像是一套经过经验打磨的工程折衷方案,而不是对理论最优方向的忠实复刻。
对实践者的启示
对于日常使用Adam的工程师和研究者来说,这篇论文至少带来三点可借鉴的认知:
- 不要迷信Adam的方向正确性。在病态或高度非凸问题上,它偏离自然梯度的程度可能超乎想象,但这并不妨碍最终收敛。
- 初期收敛慢可能是几何漂移的信号。如果训练前期进展缓慢,背后或许正是方向偏差在起作用,而非超参数设置问题。
- 改进经验Fisher(iEF)值得关注。对于试图设计新型二阶或自然梯度方法的研究者,iEF提供了比标准EF更稳定的路径基础。
这项工作并未否定Adam,恰恰相反,它用严谨的几何分析解释了Adam为何能在不精确中保持高效,也为下一代优化器的设计指明了可能的突破口。
相关推荐

Rysh Forge 实测:一份 OpenAPI 规范自动生成 Claude 可调用的 Agent 工具
Rysh Forge 用一条命令把 OpenAPI 规范自动转换成 Claude 可调用的 Agent 工具,同时生成 MCP server、Python SDK 和文档,并对写操作强制人工确认,实现全链路可观测。本文解析其工作流与价值。

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。