Agens Volundr 32B:72层仅18层保留KV缓存的混合架构实践
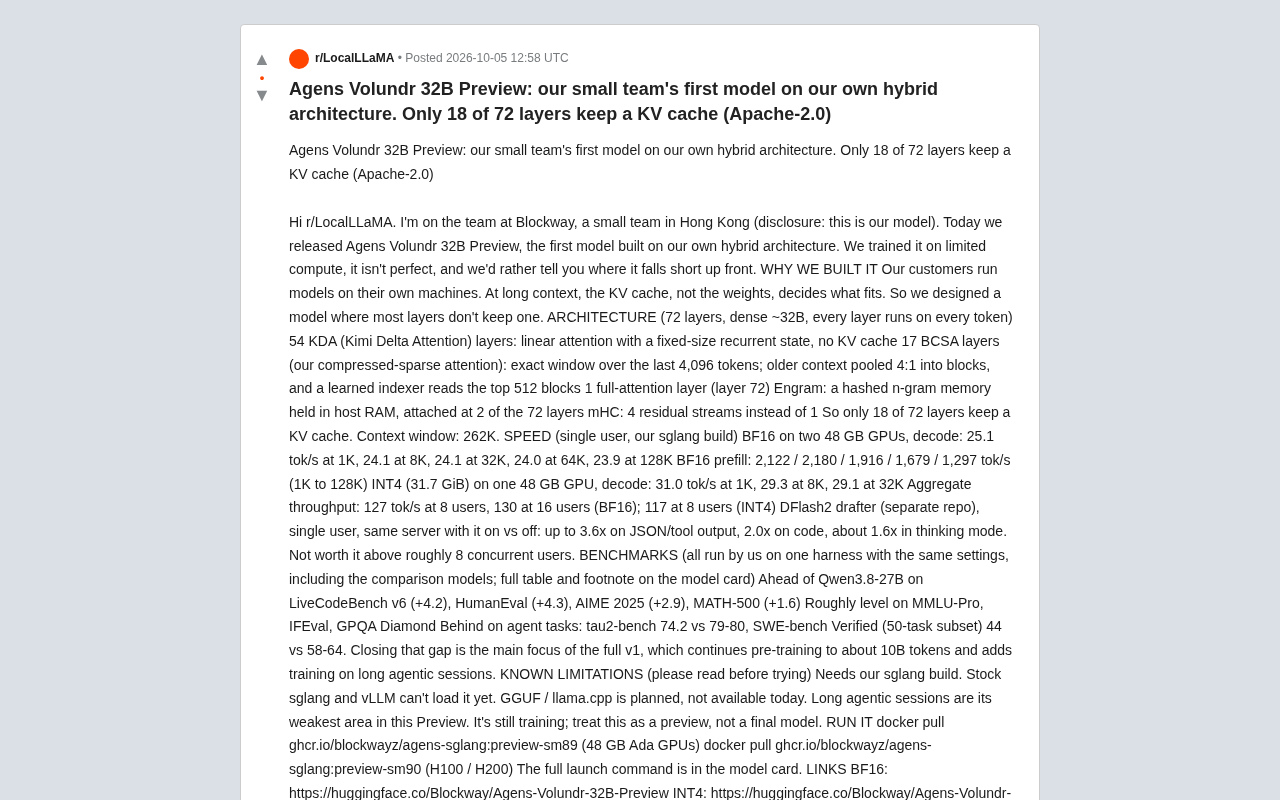
香港小团队 Blockway 开源 32B 混合架构模型,72 层中仅 18 层保留 KV 缓存,实现 262K 长上下文下显存高效推理。
Blockway 团队发布的 Agens Volundr 32B Preview 是一个以「本地长上下文部署」为核心设计目标的混合架构模型。其关键取舍在于:72 层中仅 18 层维护 KV 缓存,主体由 54 层 KDA 线性注意力和 17 层 BCSA 压缩稀疏注意力构成,辅以基于哈希的 Engram 记忆和多残差流机制。实测解码速度在上下文从 1K 拉长至 128K 时几乎无衰减,INT4 量化版可在单张 48GB GPU 上运行。基准测试显示编码与数学任务领先同级的 Qwen3.8-27B,但 Agent 任务(SWE-bench、tau2-bench)存在明显差距,团队将此列为后续版本的主攻方向。模型以 Apache-2.0 协议开源,但目前仅支持团队自研的 sglang 构建,vLLM 和 GGUF 支持尚未就绪。
香港小团队 Blockway 在 r/LocalLLaMA 发布了他们基于自研混合架构打造的首个模型——Agens Volundr 32B Preview。这个模型最引人注目的设计在于:全部 72 层中只有 18 层保留 KV 缓存。在长上下文本地推理场景下,这种取舍直指一个被反复讨论的痛点——真正决定显存能否装下的,往往不是权重,而是 KV 缓存。
为什么要砍掉大部分 KV 缓存
Blockway 团队给出的出发点非常务实:他们的客户在自己的机器上跑模型。当上下文拉长时,KV 缓存会随序列长度线性膨胀,成为显存占用的主导因素,而非模型权重本身。基于这个观察,团队设计了一种「绝大多数层都不维护 KV 缓存」的架构。
这是一个典型的工程权衡思路。传统 Transformer 每一层都需要缓存历史 token 的 Key/Value,在 262K 这种超长上下文下,缓存开销会迅速吞噬显存预算。把缓存层压缩到最低限度,意味着同样的硬件可以支撑更长的上下文窗口——这正是本地部署用户最关心的指标之一。
架构拆解:四类层的分工
模型为稠密结构,约 32B 参数,72 层,每一层对每个 token 都会运行。其层级构成相当有意思:
线性注意力为主体
- 54 层 KDA(Kimi Delta Attention):线性注意力,使用固定大小的循环状态,不保留 KV 缓存。这部分占据了四分之三的层数,是「省缓存」的核心来源。
- 17 层 BCSA(压缩稀疏注意力):对最近 4096 个 token 做精确窗口注意力;更久远的上下文按 4:1 池化成块,再由一个可学习的 indexer 读取 top 512 个块。
- 1 层全注意力(第 72 层):保留完整注意力能力,作为架构的「兜底」。
KDA(Kimi Delta Attention)是线性注意力机制的一种变体。传统 Transformer 的注意力计算复杂度随序列长度呈二次方增长(O(n²)),而线性注意力通过将注意力矩阵分解为核函数的乘积,将计算复杂度降至 O(n),并以固定大小的循环隐状态替代逐步增长的 KV 缓存。代价是无法做到任意两个 token 之间的精确全局注意力,理论表达能力有所下降。BCSA(Block-wise Compressed Sparse Attention)则代表了一种折中方案:对近期 token 保留精确的滑动窗口注意力以维持局部精度,对远程历史进行池化压缩后再由可学习模块检索最相关的块——这与 Longformer、BigBird 等稀疏注意力方案的思路相近,但加入了可学习索引机制来优化远程信息的召回质量。将这两类低缓存或无缓存注意力堆叠为主体,再辅以少量精确全注意力层,是当前业界平衡长上下文能力与推理效率的主流探索方向之一。
记忆与残差增强
除了注意力层,团队还引入了两项辅助机制:Engram 是一套基于哈希的 n-gram 记忆,存放在主机内存(host RAM)中,挂接在 72 层中的 2 层上;mHC 则用 4 条残差流取代传统的单条残差流。
最终结果是:72 层里只有 18 层保留 KV 缓存,上下文窗口达到 262K。这种「以线性注意力为主、少量精确注意力为辅」的混合思路,和近期业界探索的多种长上下文方案一脉相承。
Engram 机制借鉴了神经科学中「印迹」(engram)的概念——即记忆在神经网络中的物理存储痕迹。在工程实现上,它利用哈希函数将 n-gram 序列映射到宿主机内存(CPU RAM)中的固定槽位,使模型可以在不占用 GPU 显存的前提下检索较长范围的 token 组合统计信息。这类外挂记忆设计与 Memorizing Transformers、Unlimiformer 等工作的思路类似,核心诉求都是以廉价的内存带宽换取更长的有效上下文覆盖。mHC(多条残差流)则对应架构领域近年来的另一个探索方向:Transformer 的单残差流在层间信息路由上存在瓶颈,多残差流设计允许不同类型的特征在独立通道中传播,理论上可以提升模型的表达多样性,但也会增加参数量和实现复杂度。
速度表现:长上下文下几乎不掉速
团队公布了基于自研 sglang 构建的单用户性能数据,其中最值得关注的是解码速度随上下文增长的稳定性:
- BF16(两张 48GB GPU):解码从 1K 时的 25.1 tok/s 到 128K 时的 23.9 tok/s,几乎没有衰减。
- BF16 预填充:从 1K 的 2122 tok/s 到 128K 的 1297 tok/s。
- INT4(31.7 GiB,单张 48GB GPU):解码在 1K 时 31.0 tok/s,32K 时仍有 29.1 tok/s。
解码速度在上下文从 1K 拉到 128K 时几乎平稳,这正是砍掉 KV 缓存带来的直接收益——缓存不随序列线性膨胀,长文本解码的边际成本大幅下降。
此外,团队还提供了一个独立仓库的 DFlash2 drafter(推测解码加速)。在同一服务器上开启后,JSON/工具调用输出最高可提速 3.6 倍,代码约 2.0 倍,思考模式约 1.6 倍。不过他们坦言,在约 8 个并发用户以上时,这个加速就不划算了。聚合吞吐方面,BF16 在 8 用户时 127 tok/s、16 用户时 130 tok/s。
推测解码(Speculative Decoding)是一种通过「小模型起草、大模型验证」来提升自回归生成速度的技术。DFlash2 drafter 属于此类加速方案:由一个轻量起草模型(drafter)快速生成多个候选 token,再由主模型批量验证并接受其中正确的部分,从而在不改变输出分布的前提下减少主模型的前向传播次数。这一方法在输出模式较规则(如 JSON、代码)时加速效果最显著,因为起草模型更容易预测正确,验证接受率高;而在开放式推理或思考模式下,输出不确定性更高,接受率下降,加速比因此缩小。团队报告的 3.6×/2.0×/1.6× 差异正好印证了这一规律。并发用户增多时,GPU 批处理效率提升,起草模型带来的边际收益相对下降,因此高并发场景下该方案性价比降低。
基准成绩:代码数学领先,Agent 任务落后
团队强调所有基准都由他们自己在同一套 harness、相同设置下跑出,包括对比模型。对标 Qwen3.8-27B 的结果呈现出明显的强弱分化:
领先的部分:
- LiveCodeBench v6(+4.2)
- HumanEval(+4.3)
- AIME 2025(+2.9)
- MATH-500(+1.6)
基本持平:MMLU-Pro、IFEval、GPQA Diamond。
明显落后:tau2-bench 为 74.2,对手为 79–80;SWE-bench Verified(50 题子集)仅 44,对手为 58–64。
也就是说,模型在编码和数学推理上表现不俗,但在 Agent 任务上存在明显短板。团队没有回避这一点,并表示完整版 v1 的主攻方向正是缩小这一差距——继续预训练到约 100 亿 token,并加入长 Agent 会话的训练。
已知限制与上手方式
团队的坦诚值得一提,他们在发帖中直接列出了限制:
- 目前必须使用他们自己的 sglang 构建,原版 sglang 和 vLLM 还无法加载。
- GGUF / llama.cpp 支持仍在计划中,当前不可用。
- 长 Agent 会话是本 Preview 最弱的环节。
- 模型仍在训练中,这是预览版而非最终版。
上手方式通过 Docker 镜像提供,分别针对 48GB Ada 架构 GPU(sm89)与 H100/H200(sm90)。模型以 Apache-2.0 协议开源,BF16、INT4 权重及 DFlash2 drafter 均已上传至 Hugging Face,项目页和推理代码托管在 GitHub。
小团队做架构创新的意义
抛开具体分数,这个项目更有价值的地方在于它展示了一条路径:在算力有限的条件下,小团队依然可以通过架构层面的取舍去解决真实的部署痛点。Agens Volundr 没有去追逐全面超越同级模型,而是把资源集中在「长上下文下的显存效率」这一明确目标上。
团队在帖子里反复强调「在有限算力下训练」「这不完美」「请先读限制再试用」,并主动邀请社区提交失败案例和希望补测的基准。这种把短板摆在明面上的做法,在当下充斥着跑分营销的发布氛围中显得难得。对于关注本地部署、长上下文推理以及注意力架构演进的读者来说,这是一个值得跟进的实验样本。
相关推荐
n8n实战:从零搭建你的第一个AI Agent工作流
基于n8n in 100 days系列第14集实操,详解如何用n8n搭建第一个AI Agent:从When chat message received触发节点、AI Agent与Chat Model,到Memory记忆模块的作用与设计逻辑。

Aleph Alpha开放Kolibri 78B在线免费试用
Aleph Alpha旗下780亿参数大模型Kolibri 78B现已开放免费在线试用,用户无需部署即可通过网页体验这款欧洲本土AI模型的对话能力。

Jonathan Haidt警告:AI是教育的"中子弹"
社会心理学家Jonathan Haidt将AI称为教育的"中子弹",警告其可能保留教育外壳却掏空学习内核。本文解读这一比喻背后的担忧、争论及对教育者的启示。