Agent Loop面试必考:与LLM单次调用的本质区别

用"生命周期、工具、记忆、交付物"四维框架,拆解Agent Loop与LLM单次调用的本质区别。
本文以一位B站UP主整理的"Agent Loop面试十连问"第一题为切入点,分析当前AI工程师面试中考察重点从"会不会"向"怎么做"的迁移趋势。针对"Agent Loop与LLM单次API调用有何本质区别"这一高频问题,文章提出了一套四维对比框架:生命周期(瞬时交互 vs. 持续循环)、工具调用(纯文本生成 vs. 主动调用外部资源)、记忆(无状态 vs. 跨步骤状态积累)、交付物(文本输出 vs. 任务结果)。四个维度之间存在递进逻辑,共同说明为什么Agent是一个"系统"而非"一次调用"。掌握这套结构化回答框架,既能应对面试,也是理解Agent工程落地核心骨架的有效切入口。
面试风向变了:从「会不会」到「怎么做」
如果你最近准备AI工程师或大模型相关岗位的面试,会发现考察重点正在发生明显迁移。过去面试官更关注你是否了解某个概念、用过哪些框架;而现在,问题越来越偏向落地细节——Agent Loop是怎么设计的?Maker和Checker为什么要分离?循环的退出条件如何定义?
这类问题之所以难接,是因为它们考察的不是记忆,而是你对Agent系统运行机制的真实理解。回答不好,面试基本就卡住了。本文围绕一位B站UP主整理的「Agent Loop面试十连问」的第一题展开,拆解一个看似简单却极容易答砸的问题。
第一题:Agent Loop和LLM单次API调用的本质区别
这是整个系列的开场题,表面上非常基础,但正因为简单,反而最能暴露回答者的理解深度。
很多人脱口而出:「一个能调工具,一个不能调工具。」这个答案不能说错,但过于单薄,无法体现系统性思考。面试官真正想听到的,是你能否把两者的差异结构化地讲清楚。
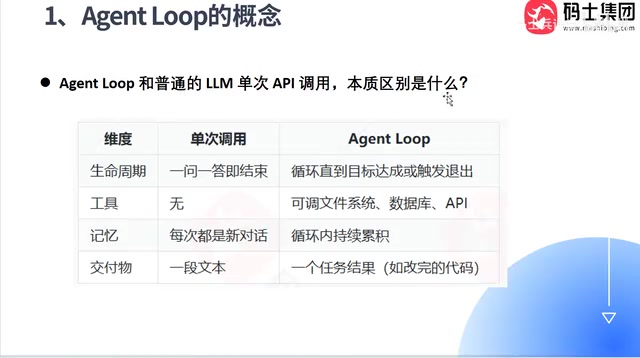
用四个维度构建回答框架
与其给一句话结论,不如把差异拆解成四个维度,逐一对比。这样的回答既清晰又显得有条理。
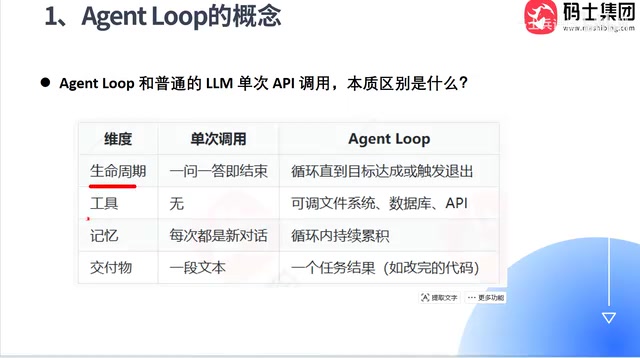
一、生命周期
普通的LLM单次调用是「一问一答」,请求发出、响应返回,一个周期就结束了。而Agent Loop本质是一个循环结构,它会持续运行,直到目标达成或触发预设的退出条件。生命周期的差异是两者最根本的分野——一个是瞬时的,一个是持续演进的。
二、工具调用
单次调用通常不涉及外部工具,模型只是基于已有知识生成文本。Agent Loop则能够主动调用文件系统、数据库、各类API等外部工具,借助这些能力去感知环境、获取信息、执行操作。工具是Agent突破纯文本生成局限的关键。
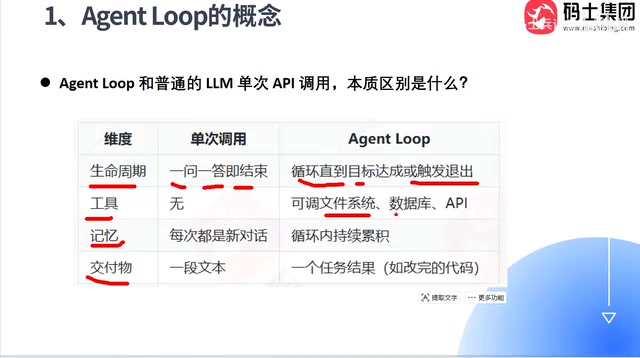
三、记忆
单次调用的每一次交互都是独立的、全新的对话,上下文不会天然延续。而Agent Loop在循环内部可以持续积累状态——它记得上一步做了什么、得到了什么结果,从而让后续决策基于累积的信息,而非从零开始。
四、交付物
单次调用的产出一般是一段文本。而Agent Loop交付的是一个「任务结果」——它可能是修复后的代码、一份完成的报告、一次成功的数据库操作。换句话说,前者给的是答案,后者给的是成果。
Agent Loop 是指大模型驱动的自主任务执行循环,其基本运转模式通常被概括为"感知—规划—行动—观察"(Perceive-Plan-Act-Observe)的反复迭代。每一轮循环中,模型根据当前状态和目标制定下一步动作,执行后观察结果,再将结果作为新的输入进入下一轮,直到任务完成或超出预设的限制(如最大步数、Token消耗上限)。这一架构最早在 ReAct(Reasoning + Acting)论文中得到系统性阐述,随后在 AutoGPT、LangChain Agent、OpenAI Assistants API 等主流框架中被广泛实现。理解 Agent Loop 的循环本质,是区分它与单次 API 调用的前提——后者只完成循环中的"规划"一步,既无行动能力,也无跨步骤的状态积累。
为什么这个框架在面试中有效
把一个开放性问题拆成「生命周期—工具—记忆—交付物」四个维度,好处在于:它展现了你对Agent系统的结构化认知,而不是零散的印象。面试官能从中判断你是否真正理解Agent为何是一个「系统」而非「一次调用」。
这四个维度之间其实存在内在逻辑关联:正因为需要持续运行(生命周期),才需要工具去推进任务;正因为是循环推进,才需要记忆来维持连续性;而所有这些的最终目的,是交付一个完整的任务结果,而非一次性的文本输出。
理解了这层递进关系,你不仅能答好这一题,也为后续讨论Maker/Checker分离、退出条件设计等更深入的问题打下了基础。
Maker/Checker 分离是 Agent 系统设计中的一种可靠性模式:由一个 Agent(Maker)负责生成或执行任务,另一个独立 Agent(Checker)负责验证输出的正确性与安全性。这种分离的核心动机在于,大模型存在自我校验盲点——生成错误时往往也会对错误产生高置信度,难以自我发现。引入独立的 Checker 可以打破这种"自我强化"的偏差,类似于软件工程中的代码审查机制。在实际工程实现中,Maker 和 Checker 可以是同一个基础模型的不同实例,也可以是能力侧重不同的两个模型,关键在于它们拥有独立的上下文和评判视角。这一模式是 Agent Loop 退出条件设计的重要依据:只有 Checker 通过验证,循环才被允许终止并交付结果。
小结
Agent Loop之所以成为当下面试的高频考点,是因为它正是Agent工程落地的核心骨架。面对「它和单次调用有什么区别」这类问题,不要停留在「能不能调工具」的层面,而要从生命周期、工具、记忆、交付物四个角度系统作答。掌握这套框架,既是应对面试的模板,也是真正理解Agent运行机制的切入口。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。