Agent Skills架构精讲:从Skill.md到工具调用的底层逻辑

Agent Skills是扩展AI Agent能力的轻量开放格式,核心是写给模型看的SKILL.md元数据文件。
Agent Skills是一种轻量、开放的格式,用于为AI Agent补充具体的执行能力,弥补大语言模型"只有推理大脑、缺乏功能手脚"的天然局限。一个Skills最小只需一个SKILL.md文件,其中name与description是核心元数据;完整的Skills还可包含可执行脚本、引用资源和模板等可选组件。文章着重纠正了两个常见误区:一是"Skills只是一个MD文件"的简化认知——MD只是入口,背后的工作流与资源体系才是真正价值所在;二是对description重要性的低估——description不是写给人看的README,而是大语言模型进行工具路由和调用决策的语义依据,其质量直接决定Agent能否在正确时机触发正确技能。
什么是Agent Skills
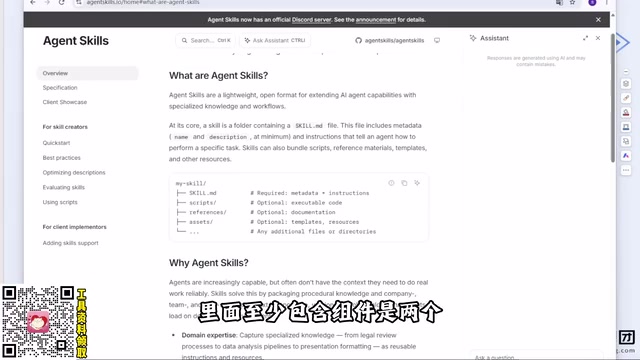
围绕Agent开发的讨论中,Skills(智能体技能)是一个近来被频繁提及却常被误解的概念。按照Agent Skills官方文档的定义,智能体技能是「一种轻量级、开放式的格式,用于借助专业知识与工作流来扩展AI Agent的能力」。
这句定义的核心落点在于「扩展能力」四个字。大语言模型本身——无论是DeepSeek广告、Kimi、豆包,还是GPT、Claude——本质上只是一个具备分析与推理能力的「大脑」,它并不自带任何额外功能。当我们希望它替我们完成具体任务时,模型其实并不知道自己手上有哪些工具、方法或技能可以调用。Skills的作用,就是让Agent能够根据项目需求,迭代出一套可复用的技能,从而完成完整的业务开发。
从技术生态的角度来看,Agent Skills与当前主流的Agent开发框架(如LangChain、AutoGen、Coze等)中的"工具链"概念有所区分。工具链通常以代码为核心,依赖特定框架的API集成;而Skills采用更接近"声明式"的设计哲学——用结构化文档描述能力边界,使技能可以在不同Agent平台之间复用和共享。这种设计思路类似于npm包或PyPI模块,开发者可以发布、引用他人的Skills,而不必从零构建每一项能力。正因如此,Skills才被定义为"开放式格式",而非某个特定框架的私有规范。
Skill.md:一个Skills的最小构成
一个Skills的核心是一个 SKILL.md 文件,它承载了这项技能的元数据(metadata)。在所有元数据中,最基础、也是最不可省略的两项是:
- name:技能的名字
- description:技能的描述
如果你想自定义一个Skills,或者使用线上现成的Skills,至少要确认它包含这两个字段。除此之外,一个完整的Skills目录结构通常还会包含更多可选组件:
- scripts:外部执行脚本,比如Python脚本、批处理命令等
- references:额外的引用资源,如数据文件
- resources / assets:模板、静态页面、静态样式等其他资源
这里有一个关键的「最小化要求」:一个Skills只需要包含一个 SKILL.md 就可以运行,其余组件都是可选的。但如果你想把一项技能的能力发挥到极致,建议尽可能补齐这些组件。是否需要它们,最终取决于业务复杂度——一个简单的天气查询Skills,可能直接调用开源接口即可,完全用不上scripts、references这些额外结构。

被低估的description:它不是写给人看的
视频中反复强调的一个观点,值得单独拎出来讲:description不是给人看的,而是给大语言模型看的。
这一点很容易被开发者忽视。在大模型开发中,我们经常会定义一种叫做 tool(工具)的东西,它本质上等同于一个函数或方法。定义好工具后,通常会用规范的编码方式给它加上一个描述符,写上这个工具的用途,也就是description。
很多人会把description类比成项目的README。但两者的受众完全不同:README告诉「人」这个项目是干什么的、技术架构如何、功能怎么划分;而description是让大语言模型理解「这个工具/技能到底能完成什么功能」。
只有当模型读懂了description,它在遇到具体场景时才能够正确地「发现」这些Skills并触发调用。换句话说,description的质量直接决定了模型能否在恰当时机识别并使用你的技能。这也是为什么作者强调:凡是涉及description的地方都很重要,不只是Skills,工具定义同样如此。

对Vibe Coding时代的提醒
值得留意的一个延伸提醒是:如今手写代码的机会越来越少,很多人依赖各类AI辅助编码(vibe coding)来实现功能。但即便如此,对于description这类关键组件,仍然建议开发者亲自过一遍、把控质量。因为这些描述直接影响Agent的行为准确性,交给工具全自动生成往往难以保证效果。
从大语言模型的工作机制来理解这一点会更直观。当Agent在处理用户请求时,模型需要在可用工具或技能列表中做出选择——这个选择过程并非靠硬编码规则,而是靠模型对description文本的语义理解来匹配意图。技术上称之为"工具路由"(tool routing)或"函数调用"(function calling)。以OpenAI的Function Calling为例,模型会将用户输入与每个工具的name和description进行语义比对,再决定是否调用、调用哪一个。如果description措辞模糊、覆盖场景不清晰,模型要么不触发调用,要么触发错误的工具。因此description本质上是写给模型的"调用合同",需要像设计API接口一样认真对待。
Vibe Coding(氛围编程)是近年流行的一种开发方式,指开发者主要通过向AI描述需求、由AI生成代码来完成功能,而非深入手写每一行逻辑。这种方式极大降低了编程门槛,但也带来了一个隐性风险:开发者对AI生成内容的质量缺乏足够审查。对于description这类直接影响模型行为的配置,AI自动生成的措辞往往偏向通用、缺乏场景针对性,可能造成Agent在实际运行中触发失准。这并非否定AI辅助编码的价值,而是提醒开发者:越是"不起眼"的配置项,越需要人工介入把关,因为它们往往是整个系统行为链条的起点。
Skills真的「只是一个MD文件」吗
网上流传着一种说法:Skills说白了就是一个MD文件。
从最小化构成的角度看,这个说法有其合理之处——毕竟 SKILL.md 确实是唯一必备的文件。但如果就此认为Skills「仅仅」是个Markdown文档,则是一种以偏概全的误读。

一个真正强大的Skills,往往是 SKILL.md(元数据与说明)+ scripts(可执行逻辑)+ references(引用资源)+ 模板资源的组合体。MD文件只是入口和「说明书」,真正让技能落地的,是背后那套完整的工作流与资源体系。把Skills简化为「一个MD文件」,会让人错失它作为Agent能力扩展框架的真正价值。
学习方法:读官网仍是最优路径
作者在讲解中给出了一条朴素但有效的学习建议:学习任何一门新技术或新技术点,最好的渠道就是读官网。
Agent Skills官网虽然是纯英文,但描述整体较易理解,配合翻译软件(如选中即译的插件)几乎没有阅读门槛。官网上除了基础定义,还提供了Quick Start与Best Practices(最佳实践)等内容,是建立系统认知的第一手资料。不要用「太浪费时间」或「看不懂英文」当借口——在AI辅助工具随手可得的今天,这两个理由都已经站不住脚。
小结
理解Agent Skills,需要抓住三个层次:其一,它是扩展Agent能力的轻量开放格式,弥补大模型「只有大脑、没有手脚」的短板;其二,SKILL.md 是最小必备单元,name与description是核心元数据,而完整能力则依赖scripts、references、模板等可选组件;其三,description是写给模型看的调用依据,其重要性贯穿整个大模型开发领域。至于Skills与Multi-Agent架构的对比、渐进式披露(progressive disclosure)等进阶话题,则是在夯实这些基础概念之后值得进一步展开的方向。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。