Agent Skills教程:渐进式披露机制与自定义实战

Agent Skills 以文件夹和渐进式披露机制让 Agent 按需掌握技能,描述精准是关键。
本文系统梳理了 Agent Skills 的核心概念与实践要点。首先澄清 Skill 并非单个 Markdown 文件,而是包含 `SKILL.md` 及 scripts、references、assets 等子目录的文件夹,其中名称和描述是必备元数据。其次深入解析渐进式披露机制:Agent 先读取描述判断是否调用,再按需加载脚本与资源,实现分层上下文管理。文章还指出 description 的详细程度直接决定任务匹配成功率,并强调子目录需在 `SKILL.md` 中明确指向。最后给出学习路径:优先阅读官方 Best Practices 和 description 优化指南,从最小 Skill 文件夹开始实践,逐步体会披露机制。
Agent Skills教程:渐进式披露机制与自定义实战
当所有人都在谈论 Agent 时,一个更具体的问题浮出水面:如何让 Agent 真正掌握一项技能,而不是每次都从零提示?B站上一期关于 Agent Skills 的教程给出了系统性的答案。这期视频从概念原理讲到代码实战,核心围绕一个常被误解的机制——渐进式披露。本文在梳理其内容的基础上,结合官方文档的要点,为你还原 Agent Skills 的完整图景。
Agent Skills 到底是什么
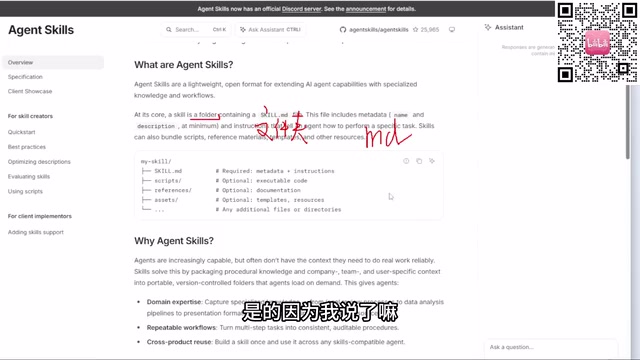
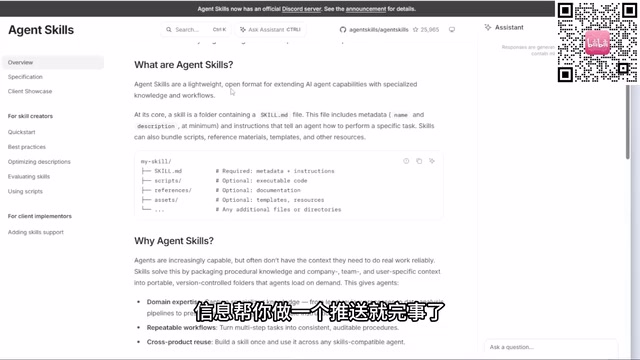
据视频作者的讲解,很多学习者会把 Skills 直接等同于一个 Markdown 文件,这是一个需要首先纠正的误区。官方文档明确指出,一个 Skill 本质上是一个文件夹,而不是单个 MD 文件。这个文件夹中必须包含一个名为 SKILL.md 的文件,文件名不可更改。
这个 SKILL.md 中至少要包含两项元数据:名称(name)和描述(description)。原因在于,大模型本身并不知道当前环境中存在哪些 Skills,它需要名称来识别能力的存在,需要描述来判断这项能力能解决什么问题。视频中特别强调,很多人在使用 Skills 时遇到任务匹配不上的情况,根源往往在于 description 写得不够详细。
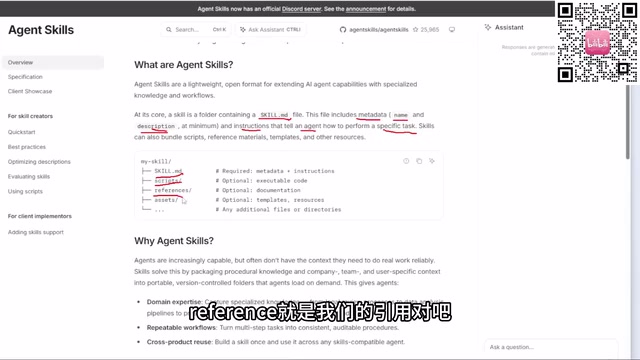
除了 SKILL.md,一个完整的 Skill 文件夹还可以包含 scripts(可执行脚本,如 Batch 或 Python 脚本)、references(说明文档)、assets(模板、资源、数据样例、样式等)。如果目录下还有其他文件夹,需要在 SKILL.md 中明确指向,告诉 Agent 在处理什么任务时调用哪个文件夹下的哪个文件,否则它无法做出判断——这一点是很多初学者容易忽略的。
SKILL.md 中的名称(name)和描述(description)并非普通注释,而是 Agent 进行工具调用的元数据入口。大模型在运行时通常无法直接感知文件系统,需要通过系统提示或工具列表获知可用技能。名称提供唯一标识,描述则充当“能力说明书”,帮助模型判断当前用户请求是否与某项技能匹配。官方文档建议 description 应包含技能的功能范围、适用场景和触发条件,甚至可列举典型用户意图。描述越具体,模型在意图识别阶段的准确率越高。反之,若描述仅写“处理文档”之类宽泛表述,模型很难在众多技能中做出正确选择,导致技能闲置或误调用。
渐进式披露:Skills 的核心机制
视频将渐进式披露列为 Agent Skills 的第三个核心议题。理解这个机制,是理解 Skills 为何采用文件夹结构而非单文件的关键。
简单来说,渐进式披露意味着 Agent 不会一次性加载 Skill 的全部内容。它先读取 SKILL.md 中的名称和描述,判断当前任务是否需要调用该 Skill;确认需要后,再按需加载脚本、参考资料或资源文件。这种分层加载的方式,让 Agent 在拥有大量 Skills 的情况下依然能保持高效的上下文管理,而不必把所有技能的细节都塞进一次对话里。
这也解释了为什么 Skill 的目录结构需要清晰、描述需要精确:披露是渐进的,但每一步的判断都依赖上一层信息的准确性。description 写得模糊,Agent 在第一步就可能做出错误判断,后续的脚本和资源自然无从加载。
渐进式披露(Progressive Disclosure)借鉴自人机交互与信息架构设计,其核心思想是:仅在用户需要时呈现必要信息,避免认知过载。在 Agent 场景中,这一原则被迁移到上下文管理上。大模型的上下文窗口有限,若一次性加载所有技能细节,不仅浪费 token,还可能干扰模型对当前任务的注意力。Agent Skills 通过分层结构实现这一点:第一层是 SKILL.md 中的名称与描述,体量极小,用于快速筛选;第二层是按需加载的脚本和参考文档;第三层是更深层的资源文件。这种设计让 Agent 能在持有大量技能时仍保持轻量上下文,类似人类专家先凭经验判断“该用哪套工具”,再深入细节。
如何自定义 Skills 列表与工具
视频的第四部分聚焦于自定义 Skills 列表和电动 Skills 工具。虽然原始内容对这一环节的展开较为简略,但结合官方文档的指引,可以梳理出几条实用路径。
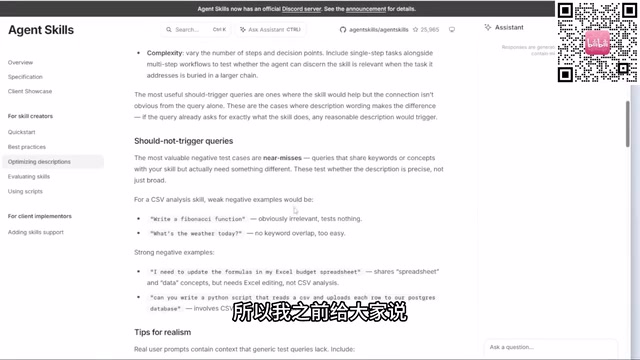
官方文档中有两个部分值得优先阅读:一是 Best Practices(最佳实践),其中罗列了使用 Skills 时的推荐方式,可以直接迁移到生产或学习环境中;二是关于如何优化 description 的编写原则,这部分对提升 Skills 的匹配成功率尤为关键。
视频作者还分享了一个获取技术资讯的方法:给自己常用的 Agent 设置定时任务,让它在每天固定时间推送大模型或 AI 相关的信息。这种方式比被动等待自媒体消化后的二手信息更及时,也更接近原始信源。他同时建议,学习新技术时应优先浏览官方网站,因为自媒体和视频内容往往是别人消化后的转述,表述未必准确。语言方面,浏览器翻译工具已经足够应对英文文档的阅读需求。
项目实战与学习路径
视频的第五部分是一个 Skills 项目实战,但原始素材中对实战环节的具体代码和步骤记录有限,无法在本文中完整还原。从已有的信息来看,实战环节建立在前面四个部分的理解之上:先明确 Skill 的文件夹结构,再设计好 SKILL.md 中的名称与描述,然后按需组织 scripts、references 和 assets,最后通过渐进式披露机制让 Agent 在合适的时机调用。
对于想要上手的读者,一个务实的路径是:打开官方文档首页,通读 Skills 的基本定义;然后重点阅读 Best Practices 和 description 优化指南;接着在自己的 Agent 环境中创建一个最小的 Skill 文件夹,从单一的 SKILL.md 开始,逐步加入脚本和资源,观察 Agent 的匹配行为。这个过程本身就是对渐进式披露机制的直观体验。
常见误区与关键提醒
综合视频内容,有几个误区值得单独列出。把 Skills 当成单个 MD 文件是最普遍的一个,这会限制脚本、资源和参考文档的利用,让 Skill 的能力大打折扣。description 写得过于简略是第二个高频问题,直接导致任务匹配失败。忽略目录指向则是第三个问题——当 Skill 文件夹中存在多个子目录时,不在 SKILL.md 中明确指向,Agent 就无法自主判断该调用哪一个。
Agent Skills 的设计哲学并不复杂:用轻量的开放式格式,把专业知识和工作流打包成 Agent 可以按需取用的技能包。真正决定它好不好用的,是描述是否精准、结构是否清晰、披露路径是否顺畅。把这三点做到位,Skills 才能真正扩展 Agent 的能力边界,而不是变成一个躺在目录里无人调用的文件夹。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。