Agent核心原理拆解:控制端、感知端、行动端三大模块详解

大模型会产生幻觉、缺乏实时信息、无法完成复杂计算——这些"人工智障"时刻让人头疼。Agent(智能体)架构正是为了解决这些问题而生。它并不神秘,本质上就是大模型 + 外部工具 + 执行流程。本文将系统拆解Agent的核心原理、常见架构和实战应用。
Agent的本质:大模型的「插件系统」
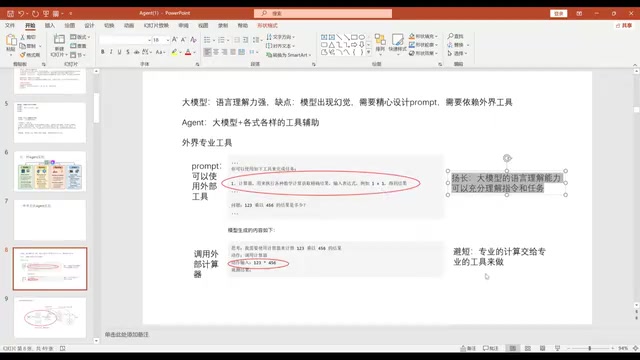
如果把大模型比作电池,那Agent就是一辆完整的电动车。大模型本身具备强大的语言理解能力,但存在三个致命短板:
- 幻觉问题:生成看似合理但实际虚假的内容
- 知识滞后:无法获取实时信息,比如今天的天气、最新的新闻
- 计算无能:面对复杂数学运算(如微积分)力不从心
大模型的幻觉(Hallucination)源于其生成机制——Transformer架构基于概率预测下一个token,而非从可验证的知识库中检索事实。模型在训练过程中学习的是语言模式的统计规律,而非建立逻辑推理链条。当模型遇到训练数据中覆盖不足的领域时,它会基于已学习的语言模式"编造"看似合理的内容。这也是为什么幻觉问题在专业领域(如医学、法律)尤为严重——这些领域的训练数据相对稀缺,但模型仍会自信地给出回答。
Agent的核心思路就是扬长避短——利用大模型强大的语言理解能力来「指挥」外部工具完成专业任务。大模型负责理解意图和规划步骤,具体执行交给计算器、搜索引擎、API接口等外部工具。
Agent三大核心模块:控制端、感知端、行动端
一个完整的Agent架构可以拆分为三大模块,分别对应大模型的「大脑」「耳目」和「手脚」。
控制端——Agent的大脑
控制端是Agent的核心,承担五项关键能力:
- 自然语言处理:理解用户意图,这是大模型的基本功
- 外部知识获取:通过RAG等方式补充大模型不具备的知识,比如公司规章制度、实时新闻
- 记忆系统:包括短期记忆(多轮对话上下文)和长期记忆(历史交互信息)
- 推理与规划:将复杂任务拆解为子任务。例如"特朗普时期阿里巴巴的CTO是谁"这个问题,需要先确定特朗普任期时间,再查询对应时期的阿里CTO
- 迁移与泛化:能够在不同场景下灵活应对,做到"见人说人话"
其中,RAG(Retrieval-Augmented Generation,检索增强生成)是2020年由Facebook AI Research提出的技术范式。其核心思想是在大模型生成回答之前,先从外部知识库中检索相关文档片段,将检索结果作为上下文注入到提示词中,从而让模型基于真实数据生成回答。这种方式有效缓解了幻觉问题和知识滞后问题,因为知识库可以随时更新,而无需重新训练模型。RAG的关键环节包括:文档切片、向量化(Embedding)、相似度检索和上下文拼接。
感知端——Agent的耳朵和眼睛
感知端负责接收多模态输入:文本、图片、语音等。本质上是多模态技术的应用——将图片转为编码、语音转为文本,最终与语言大模型进行交互。
多模态技术的核心挑战在于如何将不同模态的信息映射到统一的语义空间。以视觉-语言模型为例,通常使用Vision Transformer(ViT)将图像切分为patch并编码为向量序列,再通过跨模态对齐模块(如Q-Former、线性投影层)将视觉特征映射到语言模型的嵌入空间。语音模态则通过ASR(自动语音识别)模型如Whisper将音频转为文本,或通过音频编码器直接提取声学特征。这种多模态融合使Agent能够处理现实世界中多样化的输入形式。
行动端——Agent的手和脚
行动端是Agent的执行层。最基础的是文本输出,进阶则包括:调用计算器完成数学运算、调用天气API获取实时信息、调用图像生成模型创作图片、调用语音模型进行播报等。
Agent实战:四大经典架构解析
AutoGPT:提示词工程的极致
AutoGPT的本质是一套精心设计的提示词工程框架。它会在输入中包含:任务目标、约束条件、可用工具(如Google搜索、浏览器)、可用资源以及输出格式规范。大模型根据这些完整的上下文信息来理解并执行任务。
提示词工程(Prompt Engineering)远不止简单的文本拼接。在Agent场景中,它涉及系统提示词(System Prompt)的结构化设计,包括角色定义、能力边界声明、工具描述(通常采用JSON Schema格式)、输出格式约束等。高质量的提示词需要考虑模型的注意力分配机制——Transformer的自注意力在处理超长上下文时存在"中间遗忘"现象(Lost in the Middle),因此关键信息的位置编排至关重要。此外,Few-shot示例的选择和排列顺序也会显著影响模型表现。
但AutoGPT有两个明显局限:一是模型门槛高,小参数模型难以理解如此复杂的提示词,通常需要百亿级以上参数的模型;二是迁移性差,在GPT上调好的提示词换到LLaMA上可能完全失效,每个模型都需要配套调整。
BabyAGI:任务分解与递归执行
BabyAGI的核心思想是将复杂任务递归分解为子任务,然后逐一执行。

以"我想泡茶应该怎么操作"为例:大模型首先将任务分解为三步——烧开水、买茶叶放杯子、倒开水。然后对"烧开水"这个子任务再次调用大模型,得到更细的步骤:把凉水放进水壶、接通电源。如此递归,直到每个子任务都足够简单可以直接执行。
这种方式的核心难点在于流程设计——如何合理地拆解任务、如何将所有子任务的结果汇总为最终答案。
HuggingGPT:多模型协作的Agent方案
HuggingGPT展示了一种更复杂的Agent模式——任务分解 + 模型选择 + 多模型协作。
例如输入一张图片并要求"生成一个小女孩读书的图片,体态与原图一致",系统会:
- 调用体态控制模型提取原图姿态
- 调用姿态到图像生成模型生成目标图片
- 调用目标检测模型框选生成结果
- 调用图像描述模型转为文本
- 调用语音模型进行播报
这种架构能解决单一模型无法端到端处理的复杂任务,但链路过长是其最大风险——任何一个环节出错,后续都会受影响。目前这类方案仍处于Demo阶段,解决的是"有无"问题,距离生产级稳定性还有距离。
LlamaIndex:基于RAG的知识外挂系统
LlamaIndex专注于辅助模型记忆,是RAG(检索增强生成)的典型实现。它将外部知识以不同数据结构存储,并提供多种检索方式:

- 关键词检索:精确匹配,搜索"哈马斯"只能找到包含该关键词的文档
- 向量检索:语义匹配,搜索"哈马斯"还能关联到"巴勒斯坦""以色列"等相关内容
- 树形检索:按层级结构组织知识,如"中东局势→巴以冲突→哈马斯",搜索时可以获取整个分支的上下文
- 知识图谱:通过实体关系进行多跳检索,关联性更强
向量检索的核心是将文本通过Embedding模型(如OpenAI的text-embedding-ada-002、BGE等)转化为高维向量(通常768或1536维),然后通过余弦相似度或欧氏距离计算语义相近程度。与传统关键词检索依赖精确字符匹配不同,向量检索捕捉的是语义层面的相似性。为了在海量向量中实现高效检索,通常使用近似最近邻(ANN)算法,如HNSW(分层可导航小世界图)、IVF(倒排文件索引)等,配合向量数据库(如Milvus、Pinecone、Weaviate)实现毫秒级检索。
知识图谱(Knowledge Graph)以三元组(实体-关系-实体)的形式存储结构化知识,如(哈马斯, 位于, 加沙地带)、(加沙地带, 属于, 巴勒斯坦)。多跳检索指的是沿着实体关系链进行多步推理——从"哈马斯"出发,经过"加沙地带"到达"巴勒斯坦",再关联到"以色列"。这种结构化的知识表示使得Agent能够进行逻辑推理,而非仅依赖语义相似度。典型的知识图谱构建工具包括Neo4j、Apache Jena等,而将知识图谱与大模型结合(GraphRAG)是当前研究热点。
这在企业垂直场景中尤为重要——比如搭建公司内部的制度问答系统,将规章制度文档向量化存储,员工提问时通过检索获取相关内容,再由大模型生成准确回答。
思维链(CoT):让大模型学会「分步思考」
思维链是Agent中至关重要的推理策略,核心理念是不要指望大模型一步到位,而是引导它分步推理。
思维链(Chain-of-Thought)由Google Brain团队在2022年提出,其理论基础源于认知科学中的"工作记忆"概念。人类解决复杂问题时会将中间步骤外化(如在纸上列算式),从而减轻工作记忆负担。类似地,让大模型显式输出中间推理步骤,相当于为模型提供了"草稿纸"——每个中间token都成为后续推理的条件输入,有效扩展了模型的推理深度。研究表明,CoT的效果与模型规模正相关,通常在100B参数以上的模型中才能稳定涌现。
标准CoT:展示推理过程
以数学题为例:"Roger有5个网球,又买了2盒每盒3个的网球,一共多少个?"如果只给大模型一个示例答案,它可能算错。但如果在示例中展示计算过程(5 + 2×3 = 11),大模型就能学会推理步骤,正确回答类似问题。
CoT-SC:自洽性投票提升准确率
利用大模型输出的随机性,对同一问题多次调用(或调用不同模型),然后对结果进行投票,选择出现最多的答案作为最终结果,有效提升准确率。
ToT(思维树):搜索、评估与回溯

ToT是最复杂的推理架构,具备搜索、评估、回溯能力。以24点游戏为例:给定四个数字,大模型先尝试合并其中两个数,生成多个候选方案;然后让大模型评估每个方案凑成24点的可能性,淘汰不可行的分支;最终沿着最优路径递归求解。这本质上就是让大模型进行树形搜索和剪枝。
ToT本质上将经典的搜索算法引入了大模型推理过程。其搜索策略借鉴了广度优先搜索(BFS)和深度优先搜索(DFS),而评估与剪枝则类似于Alpha-Beta剪枝或蒙特卡洛树搜索(MCTS)——后者正是AlphaGo的核心算法。在ToT中,大模型同时扮演"生成器"(产生候选方案)和"评估器"(判断方案可行性)两个角色,通过自我博弈式的搜索找到最优解。这种方法的代价是计算开销显著增加,单次推理可能需要数十次模型调用。
Agent的局限与未来展望
尽管Agent架构前景广阔,但当前仍存在五个核心挑战:
- 强依赖大模型能力:电池不行,电动车再好也白搭
- 链路过长易出错:串联结构中任何一环失败都会导致整体失败
- 多次调用效率低:反复调用大模型带来延迟和成本问题
- 迁移能力弱:在GPT上调好的提示词换到其他模型可能失效
- 高度依赖提示词设计水平:Agent的效果上限取决于提示词工程师的能力
但从长远来看,单纯堆大模型参数存在能力上限,端到端虽然理想但难以解决所有复杂问题。Agent这种"分而治之"的架构将成为大模型落地的主流形态——未来所有大模型产品,最终都会以Agent的形式呈现。
相关推荐
AI编程代理持久记忆方案:逆向解析Understand Anything插件
逆向解析Understand Anything插件:它如何为Claude Code、Codex、Cursor等AI编程代理构建本地持久知识库,通过代码地图、业务逻辑连接与增量更新实现项目级记忆,而非依赖更大的上下文窗口。
Cursor、Claude Code、Qwen Code 1.0 三大AI编程Agent横评
对比 Cursor、Claude Code 与 Qwen Code 1.0 三款 AI 编程 Agent 的差异:Qwen Code 开源且无需 Node.js,Claude Code 覆盖终端与 IDE,Cursor 支持多模型并接入 Slack 与 GitHub 评审。从开源、模型绑定和工作流入口三个维度给出选型思路。
AI Agent开发者必知的5个免费GitHub仓库
探索AI Agent开发者必知的5个免费GitHub仓库,涵盖Agent项目模板、代码生成与Claude等大模型集成工具,帮助你快速搭建和优化AI智能体,降低开发门槛。