AI Agent 5种致命翻车场景:安全架构避坑实战指南

AI Agent在工程落地中的五种典型失败模式及解决方案
文章剖析了基于ReAct架构的AI Agent在实际应用中的五种致命缺陷:无限循环(缺乏退出条件)、工具幻觉(编造不存在的API参数)、上下文爆炸(长任务导致失忆)、错误级联(一步错步步错)和权限失控(执行危险操作)。针对每种问题,文章分别介绍了Cloud Code和Codex等产品的工程解决方案,包括硬限制循环次数、JSON Schema严格约束工具参数、自动上下文压缩、Git检查点回退以及错误分级处理等策略。
为什么你的AI Agent总在翻车
ReAct架构曾是2022年最火的Agent框架,核心理念是"思考→行动→观察"的循环。ReAct(Reasoning + Acting)由Google Research在2022年论文中提出,将大语言模型的推理链(Chain-of-Thought)与外部工具调用结合,让模型在每一步既能"想"又能"做"。这个设计在学术Benchmark上表现亮眼,迅速成为LangChain、AutoGPT等早期Agent框架的底层范式。思路没问题,但它有一个致命缺陷:没有退出条件。原始论文的实验场景都是短任务、有限步骤,研究者默认任务会自然终止——但工程落地时,这个假设直接崩塌。Agent不知道什么时候该停下来换个思路。
这就像给一辆没有刹车的跑车加马力——越快越危险。
来看5个社区中真实发生过的翻车案例:
- 有人用LangChain搭了客服Agent,结果循环调用同一个API 47次,账单飙到200美元
- AutoGPT编造了一个叫
WeatherForecast的API,调了8次全返回404,但仍不停止 - 一个代码重构Agent跑了30分钟,上下文堆到200K Token后开始重复已完成的步骤
- Agent在第三步用错文件路径,后面5步全在错误路径上叠加修改,项目直接编译不过
- Agent执行了
sudo rm -rf,把生产数据库给删了
最讽刺的是,每个翻车的Agent在Demo时都跑得好好的。
第一种死法:无限循环——Agent困在旋转门里出不来
想象你走进一扇旋转门,推不动就换个方向推,还是推不动就再换,永远在门里转圈。因为门需要从外面拉,而不是从里面推。
Agent调用一个API反复失败,每次换个参数重试,但根因不是参数——是API根本不存在。Agent不知道自己不知道,所以一直绕。这背后有一个认知科学概念叫"元认知盲区"(Metacognitive Blindspot):系统无法感知自身的知识边界。大语言模型在训练时优化的是"给出答案"而非"承认不知道",这使得它天然倾向于持续尝试而非主动放弃。问题的本质是:Agent架构没有最大尝试次数这个退出条件。
Cloud Code的解法: 粗暴但有效。max_turns硬限制循环次数,max_budget限制花费上限。Plan模式更聪明——只允许只读工具,Agent先探索、规划、列步骤,你确认后才执行。先看路线再上路,比边开边看安全得多。
第二种死法:工具幻觉——Agent编造不存在的API
你给实习生一本电话簿让他联系客户,他不会自己编一个不存在的号码打过去——但Agent会。
Agent看了工具描述,觉得应该有个参数叫format,就编了一个format=gsom传进去。API返回400错误,Agent换个值再试,又陷入死循环。这种现象本质上是大语言模型"幻觉"(Hallucination)在工具调用场景下的具体表现。LLM在预训练阶段学习了大量API文档和代码,形成了对"API应该长什么样"的统计直觉。当实际工具描述模糊时,模型会用这种统计直觉"补全"不存在的参数——就像它会补全句子一样自然,却同样不可靠。根因是Tool Schema太松散,没说清哪些参数是合法的。Schema越松,幻觉越狠。
Codex的解法: 用JSON Schema严格定义工具参数。JSON Schema是一种基于JSON格式的声明式规范标准(RFC草案),最初用于API文档和数据验证,现已成为OpenAI Function Calling、Anthropic Tool Use等主流Agent工具调用协议的底层约束语言。required字段必须填,enum限制可选值,type限制数据类型。Agent连编造的机会都没有,就像Excel的单元格验证——你填不进文字到数字列。
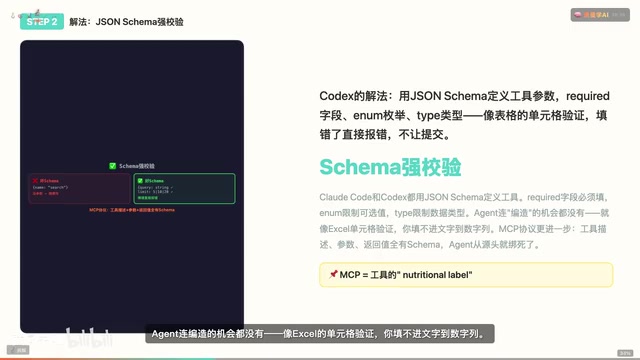
Cloud Code和Codex都用这套方案,MCP(Model Context Protocol)协议更进一步:由Anthropic于2024年底开源的MCP是一套标准化的Agent工具接入协议,类似于Agent世界的"USB接口"——工具描述、参数、返回值全有Schema,且工具服务器与Agent客户端完全解耦。Agent从源头就被约束住了。
第三种死法:上下文爆炸——长任务跑到Agent失忆
你的桌子上堆了几百份文件,最后找不到刚放的那张——不是丢了,是被淹没了。
Agent跑长任务,每一步都往上下文里塞内容。跑到第20步,上下文已经200K Token,模型开始失忆:忘了任务目标,重复已完成的步骤,甚至开始胡言乱语。这不是Bug,这是Transformer架构的物理限制。Transformer的注意力机制(Self-Attention)在计算时需要对上下文中所有Token两两计算相关性,复杂度是O(n²)。更关键的是,研究发现LLM存在"Lost in the Middle"现象——当关键信息被大量无关内容包围时,模型对中间位置信息的提取能力显著下降,即使技术上"看到了"也可能"忽略了"。上下文越大,不一定记忆越好,可能越混乱。
Cloud Code的解法:自动压缩。 上下文快满时,自动把旧对话摘要成一段话,保留最近的关键决策。就像助理帮你把几百页会议纪要压缩成一页要点。SDK在上下文逼近窗口上限时自动触发Compact。
OpenAI用另一种思路——分层上下文:全局记忆、任务记忆、工具记忆分开存储,每层有独立的容量和淘汰策略。这种设计借鉴了操作系统的内存层次结构(寄存器→缓存→内存→磁盘),不同重要性的信息存在不同"速度"的记忆层,按需调取。压缩不是丢弃,是提炼。
第四种死法:错误级联——Agent一步错步步错
导航走错一个路口,让你前方掉头,你掉头又走错了,越纠偏越偏。因为每次纠偏都基于当前错误位置重新规划。
Agent在第三步用错了文件路径,第四步基于错误路径做了修改,第五步测试失败,第六步修复了"正确的代码"来适配错误的路径。每一步都在前一步的错误上叠加,最终把整个项目搞崩。这在复杂系统理论中被称为"错误传播"(Error Propagation)或"级联失效"(Cascading Failure)——单点错误通过系统内部的依赖链被放大,最终导致全局崩溃。核心问题:Agent没有回退到检查点的能力。

Cloud Code把错误分成三类: 可重试、可回退、不可恢复——像医院分诊,轻伤挂门诊,重伤进急救,病危送ICU。529服务器过载就指数退避重试;输出被截断就提高上限重试;上下文太长就先压缩再重试;模型直接报错就换备用模型。指数退避(Exponential Backoff)是分布式系统中处理瞬时故障的经典策略,每次重试等待时间翻倍,避免在服务器过载时雪上加霜。
Codex的做法更直接: 用Git自动做检查点。每步操作前自动Commit,出问题直接git reset。这个设计极其务实——Git本身就是一个经过数十年工程验证的版本控制系统,其DAG(有向无环图)数据结构天然支持任意历史状态的回溯。代码就是最好的检查点。
第五种死法:权限失控——Agent删了不该删的文件
你给实习生公司公章,他可能会在正确的地方盖章,也可能盖在错误的合同上。不是他坏,是他没有"这个能不能盖
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。