AgentFaultBench:工具故障恢复能力如何被重新定义

AgentFaultBench 用状态验证评估智能体工具故障恢复,发现恢复建议未必有益。
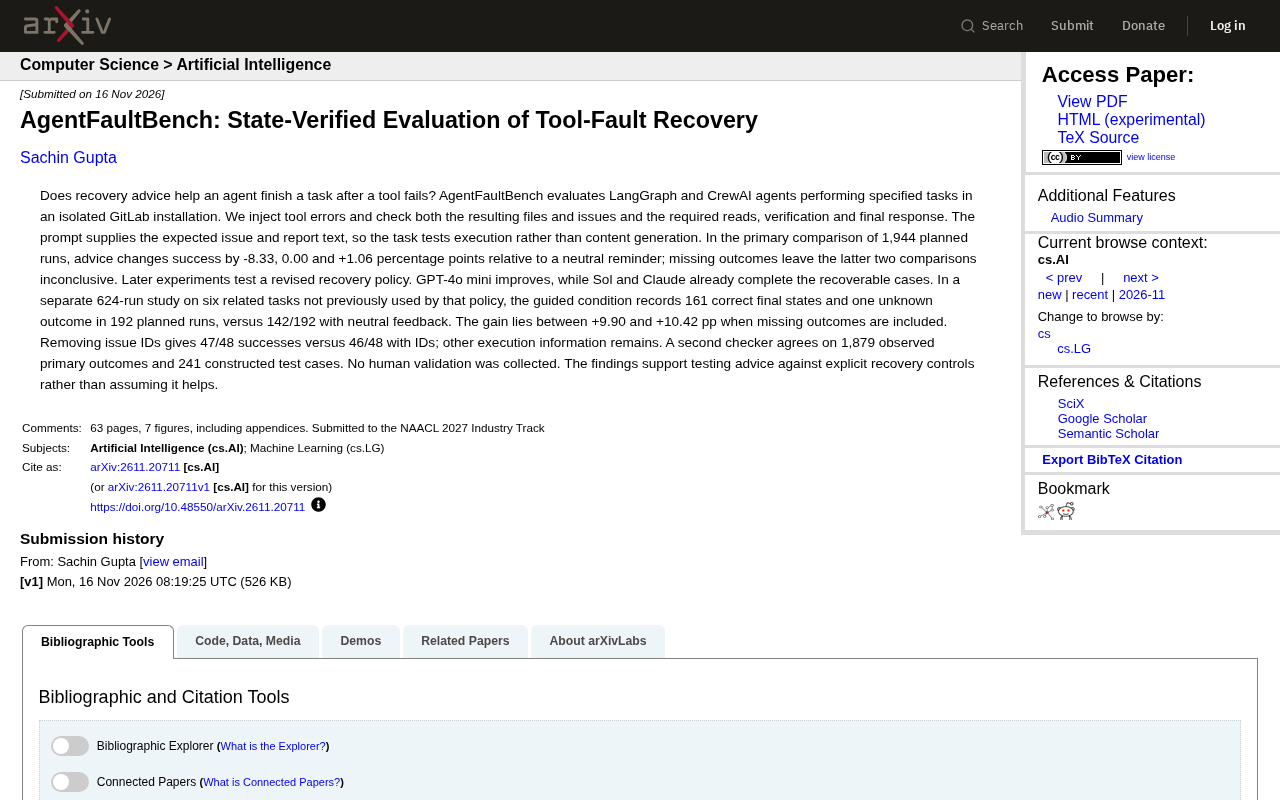
AgentFaultBench 是一个基于状态验证的智能体评估框架,在隔离的 GitLab 环境中向 LangGraph 和 CrewAI 智能体注入工具错误,检查文件修改、issue 记录及必需步骤是否完成,而非仅看最终输出。核心发现是恢复建议并不总是有帮助:与中性提醒相比,成功率变化为 -8.33、0.00 和 +1.06 个百分点,部分比较因缺失结果无法定论。修订策略下 GPT-4o mini 有改进,而 Sol 和 Claude 已能自行处理可恢复案例,提示建议价值取决于模型能力基线。第二个检查器与主结果一致,但研究缺少人工验证,方法上仍有局限。
工具调用失败后,智能体能否真的完成任务?AgentFaultBench 给出了一个可验证的答案。它不再依赖主观判断,而是通过状态检查来评估 LangGraph 和 CrewAI 智能体在 GitLab 隔离环境中的故障恢复表现。这项研究来自 rss 源,核心结论指向一个反直觉的事实:恢复建议并不总是有帮助,甚至在某些情况下会降低成功率。
为什么需要状态验证的评估
传统智能体评估往往只看最终输出,但工具故障恢复涉及中间状态:文件是否被正确修改、问题是否被记录、必要的读取和验证步骤是否执行。AgentFaultBench 的设计正是为了捕捉这些细节。每个任务都提供预期的 issue 和报告文本,因此测试的是执行能力而非内容生成能力。这种设计让评估更贴近真实开发场景——在 CI/CD 流程中,一个工具报错可能导致整个流水线停滞,而智能体需要在不依赖人工干预的情况下恢复。
据原始研究描述,实验在隔离的 GitLab 安装中进行,注入工具错误后检查结果文件、issue 以及必需的读取、验证和最终响应。这种多维度检查比单一的成功/失败标签更能反映智能体的实际鲁棒性。
LangGraph 和 CrewAI 是当前两个主流的智能体编排框架,但设计理念不同。LangGraph 将智能体工作流建模为状态图,节点代表操作、边代表条件跳转,天然支持循环和中断恢复,适合需要精细控制流程的场景。CrewAI 则采用角色协作范式,多个智能体扮演不同角色(如研究员、写手)通过任务委派协同工作,更强调高层任务分解。AgentFaultBench 同时评估两者,是因为框架的恢复机制差异可能直接影响故障处理表现:LangGraph 的状态机结构便于插入检查点和重试逻辑,而 CrewAI 的协作流程中错误传播路径更复杂。理解这一背景有助于解读评估结果——恢复建议的效果可能因框架的底层恢复能力而异。
恢复建议的真实效果:数据说话
在主要比较中,研究计划了 1,944 次运行。与中性提醒相比,恢复建议带来的成功率变化分别为 -8.33、0.00 和 +1.06 个百分点。后两项比较因缺失结果而无法得出结论。这组数据直接挑战了“提供恢复建议总能提升表现”的假设。
后续实验测试了修订后的恢复策略。GPT-4o mini 表现出改进,而 Sol 和 Claude 已经能够完成可恢复的案例。在另一项针对六个相关任务的 624 次运行研究中,引导条件在 192 次计划运行中记录了 161 次正确的最终状态和一次未知结果,而中性反馈为 142/192。当包含缺失结果时,增益介于 +9.90 到 +10.42 个百分点之间。
你可能没注意到,移除 issue ID 后,成功率为 47/48,而保留 ID 时为 46/48,其他执行信息保持不变。这表明某些元数据对恢复过程的影响有限,但执行信息本身仍然关键。
百分点(percentage point)是衡量两个百分比之间绝对差异的单位,不同于百分比变化。例如成功率从 50% 提升到 55%,是上升了 5 个百分点,但相对增幅为 10%。文中 -8.33、0.00、+1.06 个百分点指的是恢复建议组与中性提醒组的成功率之差,负值表示恢复建议反而降低了成功率。在样本量有限时,几个百分点的差异可能不具统计显著性,这也是文中部分比较“无法得出结论”的原因之一。理解这一单位有助于避免将微小波动误读为实质性效果。
多源验证与分歧
研究使用第二个检查器对 1,879 个观察到的初级结果和 241 个构造测试用例进行了验证,两者结果一致。这增强了评估的可靠性。然而,研究也明确承认没有收集人工验证数据,这是方法上的一个局限。
在恢复建议的效果上,不同模型表现出差异:GPT-4o mini 受益于修订策略,而 Sol 和 Claude 本身已能处理可恢复案例,这提示恢复建议的价值可能取决于模型的能力基线。对于能力较强的模型,额外的建议可能成为干扰;对于能力较弱的模型,适当的引导则可能带来提升。
第二个检查器(secondary checker)是独立于主评估流程的验证机制,通常由不同的模型或规则集实现,用于复核主检查器的判定结果。在智能体评估中,单一检查器可能因模型偏差或规则漏洞产生系统性误判,交叉验证能暴露此类问题。文中第二个检查器复核了 1,879 个初级结果和 241 个构造测试用例,两者一致,说明主检查器的判定具有可重复性。但需注意,两个检查器一致并不等同于判定绝对正确——若两者共享相同的评估逻辑或训练数据偏差,一致性可能只是假象。这也是研究承认缺少人工验证这一局限的原因:人工标注能提供独立于自动化检查器的 ground truth。
对智能体开发的启示
AgentFaultBench 的核心贡献在于提供了一种可复现的评估框架,而不是简单地宣称某种方法有效。它强调应该用明确的恢复控制来测试建议,而不是假设建议有益。对于开发者而言,这意味着在构建工具故障恢复机制时,需要针对具体模型和任务类型进行实证测试,而非盲目添加恢复提示。
从更广的视角看,这项研究呼应了 AI 工程化中的一个趋势:评估正从“看起来能工作”转向“可验证的状态正确”。在隔离环境中注入故障、检查中间状态、用第二个检查器交叉验证——这些做法为智能体评估树立了新的严谨标准。
尽管缺少人工验证,但 AgentFaultBench 的方法论和初步数据已经为后续研究提供了坚实基础。未来的工作可以在此基础上加入人工评估,并探索更多模型和任务类型的恢复策略。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。