Agent落地卡在评测:Snorkel AI拆解有效基准的六条法则
Agent能力增长快于评测能力,评测鸿沟成企业采用核心障碍。
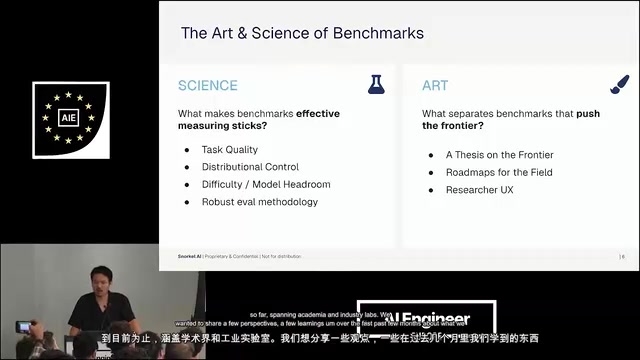
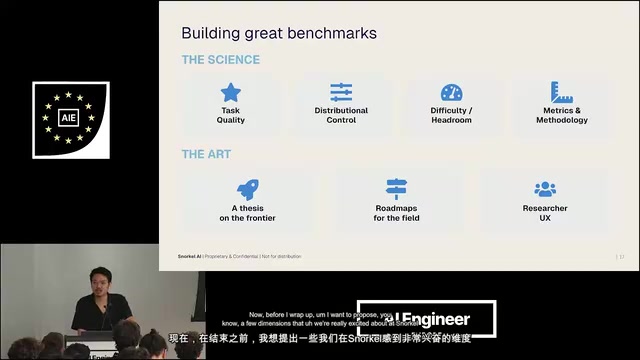
Snorkel AI 联合创始人 Vincent 指出,Agent 能力持续提升,但金融、保险、医疗等高风险行业企业普遍犹豫,核心原因不是模型能力不足,而是**测量 Agent 实际表现的能力落后于能力进步速度**,形成「评测鸿沟」。他从科学侧总结有效基准的四个要素:严谨的对抗性任务验证(以 GPQA 为范例)、分类学驱动的分布控制(对抗长尾失衡)、保持不饱和的模型余量(如 ARC-AGI)、超越准确率的多维评测(如 tau-bench)。又从艺术侧提炼伟大基准的三个特征:对领域走向下注(Terminal-bench 押注 CLI)、催生新研究路线(SWE-bench 家族)、重视研究者使用体验(HELM、Harbor)。最后给出 Snorkel 看好的下一代基准三方向:环境复杂度、自主时长、输出复杂度与不确定性表达。Snorkel 已投入 300 万美元资助开放基准,审阅超 120 份申请。
为什么Agent能力在涨,企业却不敢用?
Snorkel AI 联合创始人、研究研究员 Vincent 在一场技术分享中抛出了一个行业观察:Agent 的能力曲线在持续爬升,编程场景的"体感"改善尤为明显,但当他与金融、保险、医疗等高风险行业的企业交流时,对方普遍表现出犹豫。问题不在模型能力本身,而在于我们测量 Agent 实际表现的能力,落后于能力本身的进步速度。
这个"评测鸿沟"正在成为 Agent 落地的真实瓶颈。Snorkel 的定位是前沿 AI 数据实验室,联合创始人在斯坦福、华盛顿大学、威斯康星大学设有实验室,同时拥有面向企业的部署工程师团队。这种学术前沿与企业实战的双重接触面,让他们对评测问题有一手体感。
Vincent 透露,Snorkel 已投入 300 万美元用于开放基准资助计划,目前已审阅超过 120 份来自学术界和工业实验室的申请。他试图从这些实践中提炼出两套方法论:科学侧——如何造出有效的测量尺;艺术侧——什么样的基准能真正塑造领域走向。
科学侧:有效基准的四个基础要素
任务质量:不只是"出题",而是严谨的对抗性验证
单个任务的质量是基准的地基。Vincent 强调三个标准:任务需代表真实世界复杂度、指令结构良好、答案可验证且经领域专家确认。他以 GPQA 为范例——这个捕捉研究生与专业级知识的基准至今仍出现在模型卡上,但 Vincent 认为其最被低估的贡献藏在附录里:一套对抗性质量控制机制。
具体做法是引入原作者、审稿人、裁决者的多角色协议,并允许修订;同时设计了基于专家意见一致性的激励性报酬机制。这套流程借鉴了学术同行评审的思路,解决了前沿知识任务"单个专家也难以判断好坏"的难题。
GPQA(Google-Proof Q&A)是2023年发布的专家级问答基准,题目由物理学、生物学、化学领域的博士级专家撰写,设计目标是「即使借助搜索引擎也难以作答」。它包含约448道多选题,每题附有专家撰写的详细解析。GPQA-Diamond 是其经过质量筛选后的高难度子集,常被前沿模型报告引用。该基准的独特价值在于:它示范了如何用多轮专家评审与一致性投票来保证题目质量——每道题至少经过三位领域专家的独立验证与交叉质疑,这也是 Vincent 将其视为「对抗性质量控制」范本的原因。
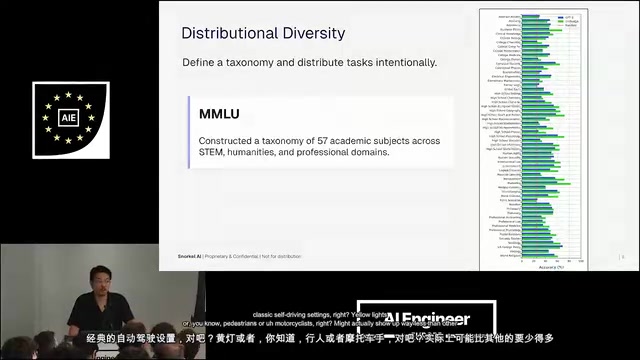
MMLU(Massive Multitask Language Understanding)于2020年提出,包含57个学科、约1.5万道多选题,覆盖STEM、人文、社会科学与专业领域(如法律、医学)。它是第一个系统性衡量模型「广度知识」的基准,长期作为模型能力的通用标尺。其57学科分类学成为后续基准设计的参照模板,这也是 Vincent 强调「分类学是基准生命力来源」的实证依据。不过,随着前沿模型在 MMLU 上接近饱和,其区分度已显著下降。
分布多样性:用分类学对抗"长尾失衡"
有意义的基准需要为领域定义清晰的分类学,并有意识地分配任务。Vincent 举了自动驾驶的经典例子:黄灯、行人、摩托车手等场景在真实数据中出现频率远低于其重要性,属于"罕见但关键"的失败模式。基准设计者必须主动刻画并覆盖这些长尾。
MMLU 的 57 个学科与专业领域分类学,被视为其长期生命力的来源之一。
难度与模型余量:基准必须"不饱和"
好的基准应持续暴露模型能力软肋,稳定区分前沿模型的位置。ARC-AGI 是 Vincent 最爱的案例:ARC-AGI 2 在很长一段时间内未被饱和,而推理能力推进期出现的性能跃升,与模型真实能力的跃升高度相关。ARC-AGI 3 发布时,前沿模型在全部任务上得分低于 1%,而每个任务对人类都可解——这种"人类能做、模型不能"的余量设计,使其成为模型发布时最受期待的评测之一。
ARC-AGI(Abstraction and Reasoning Corpus for Artificial General Intelligence)由 François Chollet 于2019年提出,含有一系列需从少量示例中归纳抽象规则的网格变换谜题。其设计哲学是「每个任务对人类可解,但对机器学习困难」——人类通常几分钟内可完成,而系统需具备组合泛化能力。ARC-AGI 2 在推理模型(如 o系列)出现前长期未被饱和;ARC-AGI 3 引入交互式环境,进一步测试动态规划与探索能力。
「饱和」是指前沿模型在基准上的得分接近或达到人类上限,导致基准失去区分度的状态。一个饱和的基准无法再暴露模型软肋,也无法为模型发布提供有意义的信号。因此,健康基准应刻意保留「人类能做、模型不能」的能力余量,并通过分档难度设计,让不同代际模型都能被稳定区分。
评测方法论:准确率之外的真实维度
稳健的评测需超越准确率,捕捉成本、延迟、推理轨迹质量、工具使用等真实维度,并将这些信号作为奖励或监督信号。Vincent 以 tau-bench 为例:它评估多轮 Agent 的任务完成度,设计了巧妙的用户模拟器,同时衡量策略约束遵循度——一个订对了航班但违反舱位规则的模型,依然判定为失败。
tau-bench(Tool-Agent-User Benchmark)是 Sierra AI 提出的多轮 Agent 评测基准,聚焦工具调用与用户交互场景(如航空订票、零售客服)。其核心设计是用户模拟器:由 LLM 扮演用户进行多轮对话,让 Agent 在动态交互中完成任务。评测不仅看任务是否完成,还通过策略约束遵循度(policy compliance)判定——例如 Agent 订对了航班但违反舱位规则,即判定为失败。这体现了 Vincent 强调的「多维信号」思路:Agent 的成功不止是结果正确,还包括过程合规、工具使用得当与交互自然。
艺术侧:伟大基准的三个差异化特征
有论点:对领域走向下注
最雄心勃勃的基准本质上是对世界走向的声明。Terminal-bench 押注 CLI 不仅是编程 Agent 的接口,更是通用计算机使用的核心抽象。从当前 Claude、Codex 等团队在 CLI 之上构建企业级通用能力来看,这个早期赌注被证明相当正确且有影响力。
能铺路:催生新研究路线
好基准会产出新路线图,激发新的研究攻击方向。SWE-bench 用一个简单思路——利用 PR 复用现有编程能力——衍生出 SWE-bench Lite、Verified 等家族,持续影响编码 Agent 的思考方式,且尚有大量创新空间,比如 vibe coding 等新抽象层如何被评测。
重视研究者体验:被低估的采用杠杆
Vincent 认为这是"严重被低估"的维度。最敏锐的基准构建者会投入精力让模型和 Agent 易于在基准上运行、让社区易于贡献新任务,并让基准信号可复用于 RL 或后训练。斯坦福 CRFM 的 HELM 率先开创了标准化模块化评测框架,Terminal-bench 2.0 则配套发布了 Harbor——一个事实上的 Agent 评测基础设施。
SWE-bench 是2023年提出的软件工程基准,让模型在真实 GitHub 仓库中根据 issue 描述生成补丁并通过测试验证。其关键创新在于复用现有编程能力:直接从开源项目的 PR 与测试用例构建任务,大幅降低标注成本。后续衍生出 SWE-bench Lite(精简子集)、SWE-bench Verified(经人工验证的高质量子集)等家族,成为编码 Agent 评测的事实标准,并持续催生新的研究路线。
HELM(Holistic Evaluation of Language Models)是斯坦福 CRFM 发起的标准化评测框架,强调模块化、可复现与多维度(准确率、鲁棒性、公平性、效率等)报告。它首次将「评测基础设施」本身作为研究对象,推动了评测从一次性跑分到可持续工程化平台的转变,这正是 Vincent 所说「研究者体验是采用杠杆」的先行范例。
Snorkel 看好的三个新方向
Vincent 给出了面向下一代基准的三条轴线:
环境复杂度。真实代码库包含组织特定策略、Slack 上下文、截图、分散的 CI、掌握隐性偏好的人类评审者、并行贡献者——当前基准只捕捉了其中一小部分。这是 Agent 今天失败的高发地带。
自主时长。Agent 在可靠性崩溃前能运行多久?以客服 Agent 为例,几周前传递的上下文可能丢失、产品规格可能变更、组织重组可能中途改变优先级。长时程、持续学习型设定下的状态变化,需要新的基准来表征。
输出复杂度与信号细腻度。战略建议、复杂报告这类产出的"好"是主观且难以验证的,需要捕捉组织上下文与人类判断。Vincent 特别提到对"可信输出"的兴趣——Agent 能否表达自身不确定性、主动停下或请求更多信息,以及纯文本之外的交互形态。
值得关注的结构性信号
这场分享的价值不止于一份清单。它揭示了一个常被忽略的因果链:基准不只是回望进步的快照,而是定义进步、设定能力目标的坐标。当一个领域的能力增长快于测量能力时,商业采用的滞后几乎是必然的——企业不是不相信模型,而是无法证明模型在其具体场景中可靠。
对构建者而言,这意味着评测能力正在从"附带工作"升级为核心竞争力。对研究者而言,Snorkel 仍在开放的基准资助计划中征集项目,其公开邮箱为 benchmarks.snorkel.ai,这或许是当前少数直接为基准创新提供资金支持的渠道之一。
相关推荐

WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。

Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。

提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。