Agent评估框架深度解析:自建还是采用现成工具?
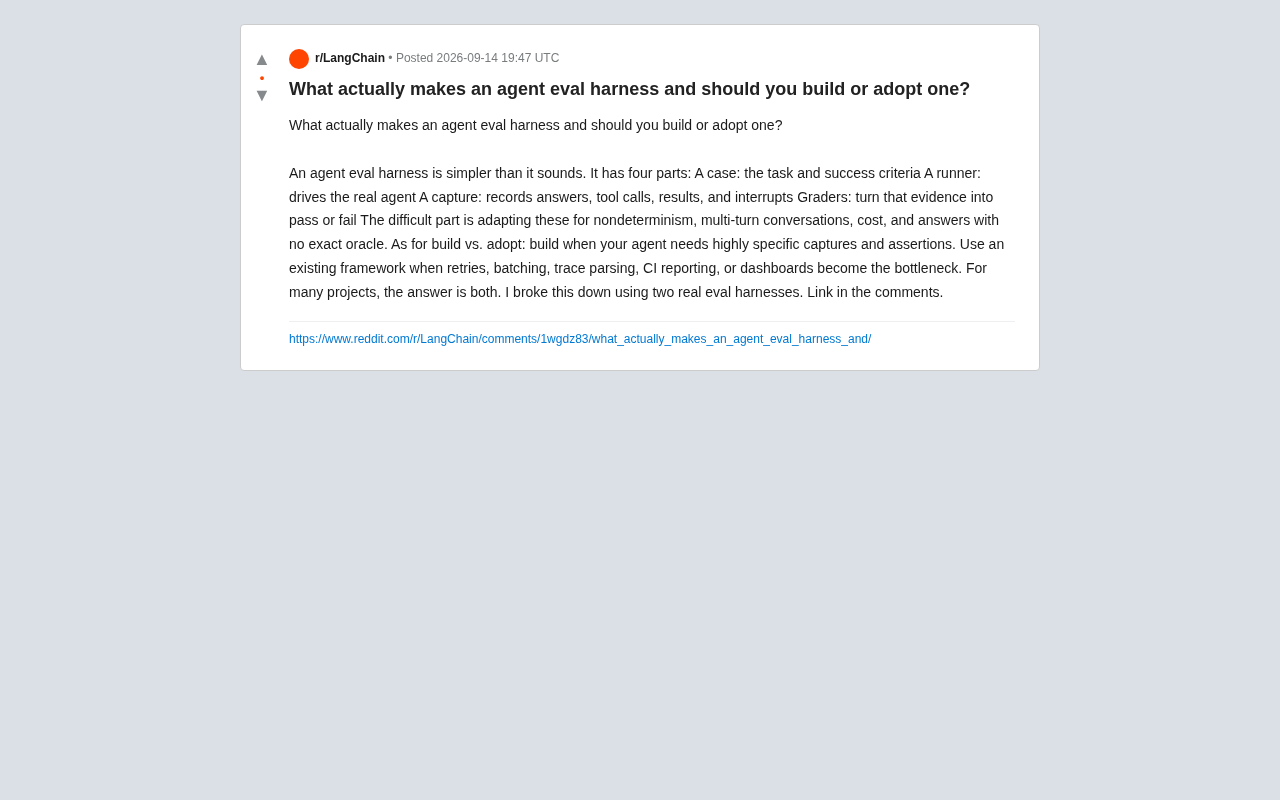
拆解Agent评估框架的四个核心组件,并给出自建与采用成熟框架的务实决策标准。
本文基于一位Reddit开发者的分享,系统梳理了AI Agent评估框架(eval harness)的构成与建设思路。一个完整的评估框架由四个组件构成:定义任务与成功标准的测试用例(Case)、驱动真实Agent运行的执行器(Runner)、记录完整行为轨迹的捕获层(Capture),以及将执行证据转化为通过/失败判定的评分器(Graders)。真正的工程难点在于适配大语言模型的非确定性、多轮对话的复杂性、规模化后的成本压力,以及开放式任务缺乏精确标准答案的问题。在自建与采用现成框架的决策上,作者建议以是否需要高度定制化的捕获与断言逻辑为核心判断依据,并指出对多数项目而言,混合策略——用成熟框架承接通用工程能力、自建核心评估逻辑——是最优解。
什么是Agent评估框架
随着AI Agent(智能体)在生产环境中的应用逐渐增多,如何系统性地评估Agent的表现成了绕不开的工程问题。一位Reddit开发者分享了对Agent评估框架(eval harness)的拆解,指出这类系统其实比听起来要简单得多——它本质上由四个核心组件构成。
评估框架的价值在于,它把「这个Agent到底靠不靠谱」这个模糊的问题,转化为可重复、可量化的测试流程。对于任何打算把Agent部署到真实业务中的团队来说,一套可靠的评估机制是从原型走向生产的必经之路。
评估框架的四个核心组件
根据原帖的拆解,一个完整的Agent评估框架包含以下四个部分:
Case(测试用例)
定义任务本身以及成功标准。这是整个评估的起点——你需要明确告诉系统「什么算成功」。对于确定性任务,成功标准可能是精确匹配某个答案;但对于开放式任务,标准的定义本身就是一门学问。
Runner(执行器)
负责驱动真实的Agent运行。执行器要真正调用被测试的Agent,而不是模拟其行为,这样才能捕捉到Agent在实际运行中的表现。
Capture(捕获层)
记录Agent的完整行为轨迹,包括最终答案、工具调用(tool calls)、执行结果,以及中断(interrupts)等关键事件。这一层是后续评判的证据基础——没有完整的记录,就无法准确判断Agent的行为是否符合预期。
Graders(评分器)
把捕获到的证据转化为「通过」或「失败」的判定。评分器是连接原始执行数据与最终评估结论的桥梁,其设计直接决定了评估结果的可信度。
真正的难点在哪里
框架的四个组件听起来清晰明了,但原作者指出,真正棘手的地方在于如何让这套机制适配Agent的现实复杂性:
非确定性(Nondeterminism):大语言模型驱动的Agent每次运行的输出可能不同,同样的输入未必得到同样的结果。这意味着单次测试的成败不足以说明问题,评估框架需要考虑多次运行、统计通过率等手段。
多轮对话(Multi-turn conversations):Agent往往不是一问一答,而是需要在多轮交互中逐步完成任务。如何评估一段对话流程的整体质量,比评估单个回答要复杂得多。
成本(Cost):每次运行Agent都会产生实际的API调用开销。当评估用例规模变大、需要多次重试时,成本会迅速累积,这要求框架在覆盖率和经济性之间做出权衡。
缺乏精确标准答案(No exact oracle):许多任务没有唯一正确答案。这类场景下,评分器往往需要借助另一个模型来做评判(LLM-as-judge),或者依赖更宽松的语义匹配规则,而这本身又引入了新的不确定性。
LLM-as-judge(模型作为评判者) 是当前处理「无精确标准答案」场景的主流方案:用一个独立的语言模型(通常是能力更强的模型)来阅读Agent的输出并打分或给出通过/失败判定。这种方式的优势在于能处理自然语言层面的语义质量,而不依赖硬编码规则;但它同时引入了评判模型自身的偏差、提示词敏感性和额外成本。为了缓解这些问题,工程实践中通常会采用多个评判模型取均值、提供评分标准(rubric)而非让模型自由发挥、以及定期用人工标注校准评判模型的准确率等手段。理解这一机制的局限性,有助于团队在设计评分器时对评估结论保持合理的置信度预期。
自建还是采用现成框架
面对「build vs. adopt」这个经典的工程决策,原作者给出了相当务实的判断标准:
倾向自建的场景:当你的Agent需要高度定制化的捕获逻辑和断言(assertions)时,自建更合适。比如你需要记录某些特殊的内部状态,或者对工具调用的顺序、参数有非常具体的校验要求,现成框架可能难以覆盖这些细节。
倾向采用现成框架的场景:当重试(retries)、批处理(batching)、轨迹解析(trace parsing)、CI报告集成、可视化仪表盘这些工程能力成为瓶颈时,采用成熟框架能省下大量重复造轮子的时间。这些功能本身与你的业务逻辑无关,却又是规模化评估不可或缺的基础设施。
值得参考的是,作者认为对许多项目而言,答案往往是「两者兼有」——用现成框架处理通用的执行调度与报告能力,同时自建针对性的捕获与评分逻辑。这种混合策略既避免了重复劳动,又保留了对关键评估环节的控制力。
目前生态中已有若干值得关注的开源或商业评估框架,例如专注于LLM应用评估的 LangSmith(LangChain生态)、Braintrust、Promptfoo 以及 RAGAS(主要面向RAG场景)。这些框架通常已内置轨迹记录、批量运行、CI/CD集成和可视化报告等通用能力,能显著降低基础设施的搭建成本。选型时需要重点考察:框架对自定义评分器的扩展性、对工具调用轨迹的解析粒度、以及是否支持异步/并行执行以控制运行成本。对于已有可观测性(observability)基础设施的团队,也可以考虑在现有追踪系统(如 OpenTelemetry)之上叠加评估层,避免引入额外的数据孤岛。
对AI工程团队的启示
这套拆解的价值在于,它把一个看似庞杂的话题拆成了可操作的模块。对于正在构建Agent应用的团队来说,与其纠结于「要不要上评估框架」,不如先从四个组件的视角审视自己的需求:哪些是通用能力可以外包给框架,哪些是核心断言必须自己掌控。
随着Agent应用从实验走向生产,评估将不再是可选项,而是保障可靠性的核心工程实践。理解评估框架的构成与建设路径,是每一个AI工程师都应当补上的一课。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。