AgentReach:让AI智能体免付费API访问社交平台的开源能力层
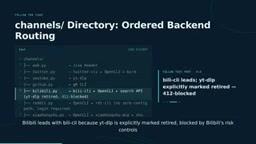
AgentReach是一个开源能力层,统一管理AI智能体接入多个社交平台时的工具选择、健康检查与路由。
AgentReach 是一个开源项目,专门解决 AI 智能体接入多社交平台时面临的碎片化工程问题。它将自己定位为"能力层"而非"包装器":安装阶段负责工具选择、健康检查和路由决策,并将结果写入 skill.md 文件;运行阶段智能体直接调用上游工具,中间不存在数据通路。各平台访问门槛差异显著——Web、YouTube、RSS 无需凭证,Twitter 单条推文可匿名读取,而 Reddit 则完全封堵了匿名路径。Doctor 命令提供实时后端探测与分层修复建议。文档明确承认 Twitter、小红书等 cookie 平台存在封号风险,Bilibili 某后端已因平台风控升级而失效。这类工具能为多平台智能体开发节省大量重复工程,但生产环境部署前必须充分评估合规与账号安全风险。
为什么社交平台成了AI智能体的高墙
每一个社交平台对自动化访问都设置了不同的工程壁垒:有的收取昂贵的API调用费,有的基于IP进行封锁,有的则要求强制登录会话。对于希望读取、搜索或发布内容的AI智能体来说,这意味着每接入一个新平台都要重新处理一套认证、路由和容错逻辑。
AgentReach 是一个开源项目,试图把这些分散的壁垒抽象成统一的一层。它的定位很明确——不是绕过付费API的"破解工具",而是一个负责工具选择、健康检查与路由的能力层(capability layer)。它解决的是"该用哪条路径、这条路径现在是否可用"的问题,而不是替你去违规抓取数据。
能力层,而非包装器(Wrapper)
AgentReach 反复强调自己是"capability layer"而非"wrapper"。这个区别在架构上很关键。
一个典型的 wrapper 会拦截智能体与上游工具之间的调用,在数据传输过程中重新格式化内容——它始终处在数据通路上。AgentReach 不这么做。安装完成后,你的智能体直接调用底层工具,数据通路上没有任何中间进程。
那么 AgentReach 负责什么?它掌管四件事:工具选择、安装、健康检查和路由。路由通过写入智能体 skills 目录的 skill.md 实现——安装时它会告诉智能体针对每个平台应该调用哪条命令。每个平台对应一个有序的后端列表(ordered backend list),系统逐个尝试候选后端,第一个完全可用的就成为激活路径。
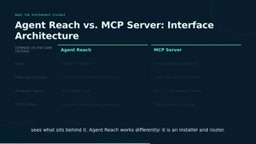
这与标准的 MCP server 形成对比。MCP server 暴露一个统一的协议端点,智能体调用这个单一接口,永远看不到背后是什么。AgentReach 则是一个安装器加路由器:它挑选上游工具、安装、做健康检查、写 skill.md,之后智能体直接调用上游工具,中间没有包装层。
MCP(Model Context Protocol)是由 Anthropic 推动的一套开放协议,旨在标准化 AI 模型与外部工具、数据源之间的交互方式。MCP server 作为中间层,将各种功能封装成统一的协议端点,模型通过单一接口调用,无需关心底层实现细节。这种架构的优点是抽象彻底、接口稳定,但代价是每次调用都要经过中间层,且中间层本身可能成为性能瓶颈或单点故障。skill.md 是写入智能体工作目录的描述文件,作用类似于"能力说明书"——它告诉智能体在面对特定任务时应调用哪条具体命令。AgentReach 在安装阶段将路由决策写入该文件,之后智能体依据它直接调用上游工具,整个运行期间 AgentReach 本身不参与数据通路,这是其区别于 MCP server 架构的关键所在。
各平台的访问门槛各不相同
AgentReach 的核心价值在于它如实梳理了每个平台的访问现状,而这些现状差异极大。划分它们的关键,是是否存在匿名访问路径。
无需登录的平台
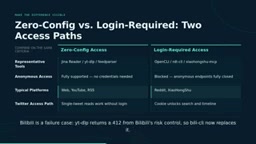
Web、YouTube、RSS 这类来源不需要任何凭证即可访问。GitHub 的公开仓库当前可读、可搜索。Twitter 的单条推文读取也无需登录——但搜索和时间线则需要导出的 cookie。
需要凭证的平台
Reddit 的约束更硬:不存在零配置路径。匿名端点被完全封锁,无论走哪条路都需要登录会话,而官方API还需要人工审批。
对于 Reddit、Facebook、Instagram,AgentReach 通过浏览器扩展连接到你已经在运行的 Chrome 进程,复用你已打开的会话——不提取凭证,cookie 也不会离开浏览器。Twitter 则走另一条路:你用 Cookie Editor 从 x.com 手动导出 cookie,保存在本地并设置仅所有者可访问。
浏览器扩展连接已有 Chrome 进程的方式,在技术上依赖浏览器的 Native Messaging 或 DevTools Protocol 等机制,允许外部进程与浏览器中的扩展通信,从而复用浏览器已建立的登录会话。这种方法的核心安全假设是:凭证(cookie)始终留在浏览器进程内,不被提取到磁盘或传输至第三方。Cookie Editor 导出的方式则相反——cookie 以文件形式落盘,因此 AgentReach 要求将其权限设为仅所有者可读(chmod 600),以降低本地文件被其他进程读取的风险。两种方案对应不同的威胁模型:前者规避了凭证离开浏览器的风险,但要求扩展常驻;后者操作更简单,但需要用户自行管理文件安全。
健康检查:Doctor 命令做的是实时探测
运行 AgentReach Doctor 不只是检查命令文件是否存在,而是对每个后端进行实时探测(live probes)。
输出会分层展示:第一层列出当前就能用的能力,比如 GitHub 公开仓库可读可搜、Twitter 推文无凭证可读;同时它会明确告诉你某个 cookie 能解锁什么功能(如搜索和发帖),让你清楚配置后能获得什么。损坏的后端出现在较低的层级,并附带固定的"处方"——告诉你需要提供什么、放在哪里。这种带诊断建议的分层反馈,对实际部署很友好。
部署前必须知道的四条限制
AgentReach 的文档明确列出了四条上线前需要权衡的限制,这也是它"如实呈现壁垒"态度的体现。
- Twitter 与小红书存在明确封号风险。基于 cookie 的脚本化调用可能触发平台检测,README 明确警告这类操作可能导致账号被封。
- Reddit 无零配置路径。匿名端点全被封,官方API要人工审批。
- 后端会随平台风控失效。例如 Bilibili 的某个后端在 2026 年 6 月被验证封锁,已由新的后端替代。
- 部分后端停止维护。有一个小红书相关后端自 2026 年 3 月起停止上游维护,新项目不应依赖它。
这些限制也揭示了一个现实:社交平台访问是持续对抗的动态过程,风控规则随时在变,AgentReach 的路由列表因此需要不断更新。
平台风控对自动化访问的对抗机制通常包含多个维度:请求频率与行为模式检测、设备指纹与 User-Agent 校验、IP 声誉评分,以及 cookie 使用模式的异常分析(例如同一 cookie 在多个 IP 或非常规时区下被使用)。基于 cookie 的脚本化调用之所以风险较高,是因为它的请求特征往往不同于正常浏览器行为——无鼠标移动事件、页面加载模式异常、接口调用节奏机械。Bilibili 后端在 2026 年 6 月被封锁的案例说明,平台可以随时升级风控策略,使原本可用的访问路径失效。这也是 AgentReach 采用有序后端列表而非单一后端的根本原因——当一条路径失效时,系统可以切换到下一个候选,整个路由列表需要持续跟进平台变化才能保持可用性。
该如何看待这类工具
AgentReach 把"访问哪个平台、走哪条路、现在是否可用"这件繁琐的事做成了可维护的一层,对需要多平台信息接入的智能体开发者确实能省下大量重复工程。它的克制也值得肯定——明确区分了无需登录的安全路径(Web、YouTube、RSS)与携带封号风险的 cookie 路径(Twitter、Reddit、小红书)。
但需要清醒认识到:cookie 平台的封号风险是真实且由文档承认的,用于生产环境前应充分评估合规与账号安全。AgentReach 本身只负责选择、安装、健康检查与路由,不负责读取行为本身——真正的风险,仍落在调用上游工具的那一端。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。