Agent执行到一半失败,已改动的数据怎么办?

Agent跨系统多步执行部分失败时,需用幂等重试与反向补偿(Saga)协同应对不可回滚的副作用。
文章从Reddit开发者遇到的真实场景出发:Agent依次创建GitHub issue、发送Slack消息、写入Notion,第三步因数据库ID拼写错误失败,但前两步已对外部世界产生可见影响。作者指出问题的根源在于Agent的多步操作横跨多个有状态系统,缺少分布式事务协调,且副作用一旦可见便难以收回。文章梳理了手动清理、幂等重试、接受不一致三种常见策略的局限,并介绍AgentRein采用的反向撤销思路——本质是Saga模式在Agent工具链上的落地,按逆序执行补偿动作。作者强调补偿有明确边界:支付、PR合并、release删除等操作不可撤销,Slack撤销是替换内容而非删除。最后给出工程启示:设计阶段区分可逆与不可逆步骤,不可逆操作后置或加确认,补偿不等于无痕,工具替代不了架构层面的责任划分。
当Agent执行到第三步崩溃,前两步已经改了真实数据
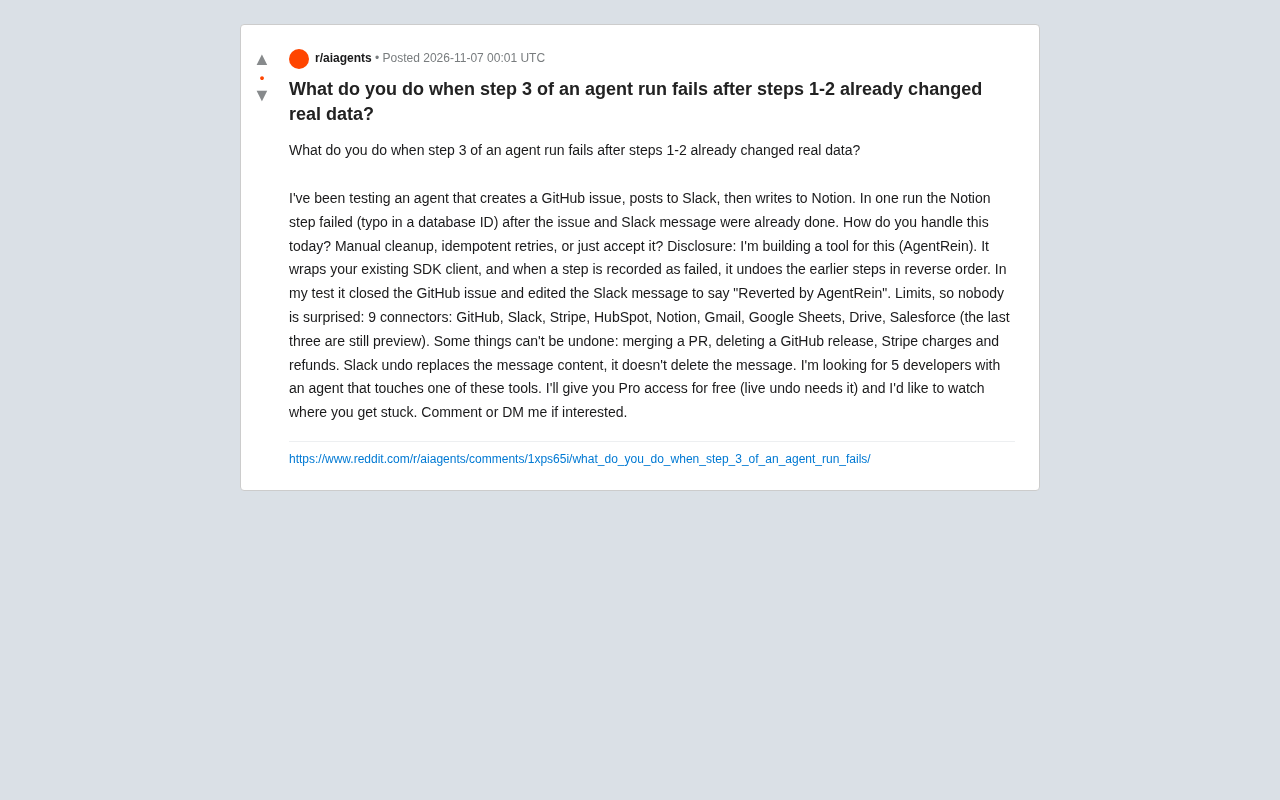
这是每个把Agent接入生产环境的开发者迟早会撞上的问题。Reddit上一位开发者描述了他的测试场景:一个Agent依次执行三个动作——创建GitHub issue、发送Slack消息、写入Notion数据库。某次运行中,Notion这一步因为数据库ID拼写错误而失败,但此时GitHub issue已经创建、Slack消息已经发出。这两步操作已经对外部世界产生了真实影响。
他抛出的问题很直接:你今天是手动清理、做幂等重试,还是干脆接受这种不一致?
为什么这个问题比看起来更难
单步失败本身不新鲜,新鲜的是Agent的多步操作横跨多个有状态系统,而这些系统之间没有事务协调。传统后端可以用数据库事务回滚,但GitHub、Slack、Notion这些外部服务各自独立,没有分布式事务协议帮你兜底。
更麻烦的是副作用已经"可见":issue可能已经被同事看到,Slack消息可能已经触发了讨论。即便技术上能撤销,时间窗口内的信息扩散也无法收回。
分布式事务与两阶段提交(2PC) 是传统后端应对跨系统一致性的经典协议:协调者先询问所有参与者能否提交,全部同意后再统一提交,任一失败则全体回滚。但2PC要求参与者实现准备/提交接口并持有锁,而GitHub、Slack、Notion这类SaaS服务并不暴露此类接口,也无法让外部系统长时间持锁。因此Agent工具链无法照搬2PC,只能退而求其次采用最终一致性:允许中间状态短暂存在,再通过补偿或对账收敛。理解这一点,就能明白为什么"回滚"在Agent场景里往往表现为"反向操作"而非"事务撤销"。
当前常见的三种应对策略
从社区讨论和工程实践看,大致有三条路线。
手动清理
最直接但也最不可扩展。小规模、偶发失败时可以人工关闭issue、编辑Slack消息、清理Notion条目。问题是Agent的价值恰恰在于自动化,一旦失败率高,人工补偿成本会吃掉自动化的收益。
幂等重试
让每一步操作具备幂等性,重试不会产生重复副作用。这是很多团队的首选,但它只解决"重试不重复"的问题,解决不了"第三步本身就不可恢复"的情况——比如Notion数据库ID写错,重试多少次都会失败,前两步的副作用依然悬在那里。
幂等性(idempotency) 指同一操作执行一次与执行多次对系统状态的影响相同。在HTTP语义中,GET、PUT、DELETE被定义为幂等,POST则不是。工程上常见的实现方式包括:客户端生成唯一的幂等键(idempotency key) 随请求发送,服务端记录已处理的键并直接返回首次结果;或使用去重表在写入前检查业务唯一标识。对于Agent调用外部API,多数SaaS提供方支持在请求头中携带幂等键(如Stripe的Idempotency-Key),但GitHub issue创建、Slack消息发送等接口默认不保证幂等,需要Agent侧自行维护"是否已执行"的状态记录,否则重试就会产生重复副作用。
接受不一致
部分团队选择记录日志、定期对账,接受短时间内的状态漂移。这种做法在副作用影响小、可以事后修正的场景下可行,但对涉及支付、客户可见内容的操作风险较高。
一个反向补偿的思路
发帖人本人正在构建名为AgentRein的工具,思路是反向撤销(undo):包装现有的SDK客户端,当某一步被记录为失败时,按相反顺序撤销之前已完成的步骤。在他的测试中,Notion失败后,工具关闭了已创建的GitHub issue,并把Slack消息编辑为"Reverted by AgentRein"。
这个思路本质上是Saga模式在Agent工具链上的落地——每一步配一个补偿动作,失败时逆序执行补偿。
明确的能力边界
发帖人自己列出了限制,这点值得肯定,因为补偿机制的边界决定了它能否被信任:
- 覆盖9个连接器:GitHub、Slack、Stripe、HubSpot、Notion、Gmail、Google Sheets、Drive、Salesforce(后三个仍在预览阶段)
- 不可撤销的操作:合并PR、删除GitHub release、Stripe的扣款与退款
- Slack的撤销是替换消息内容,而不是删除消息
这些限制说明了一个关键事实:并非所有副作用都能被补偿。支付类操作、不可逆的发布动作,一旦执行就没有回头路。
Saga模式最早由Hector Garcia-Molina和Kenneth Salem在1987年提出,用于解决长事务(long-lived transaction)无法持锁的问题。其核心是把一个长事务拆成若干本地事务T1…Tn,每个Ti配一个补偿动作Ci;若Tk失败,则逆序执行C(k-1)…C1。Saga有两种实现风格:编排式(choreography) 由各服务监听事件自行触发补偿,协同式(orchestration) 由中心协调器按状态机驱动。AgentRein这类包装SDK的工具更接近协同式——它需要记录每一步的执行状态与补偿动作,才能在失败时确定逆序撤销的范围。Saga保证的是语义上的补偿而非原子性,因此补偿动作本身也可能失败,需要设计重试与人工介入的升级路径。
对Agent工程实践的启示
把"可补偿性"作为步骤设计的一部分
在设计Agent工作流时,应该提前区分哪些步骤可逆、哪些不可逆。可逆步骤可以放心前置,不可逆步骤(支付、发布、删除)应该尽量后置,或者在执行前增加确认环节。这样即使后续步骤失败,需要补偿的范围也更小。
补偿不等于无痕
Slack消息被编辑成"已撤销"而不是删除,这个细节很有意味。在协作场景中,留下撤销痕迹有时比彻底消失更符合审计和沟通需求。团队需要决定:补偿的目标是恢复状态,还是恢复状态并保留可追溯的记录。
工具之外的架构责任
反向撤销工具能降低补偿的工程量,但它替代不了架构层面的思考。哪些操作允许自动补偿、补偿失败时如何升级处理、如何对账发现残留副作用,这些仍然需要团队自己定义。发帖人寻找5位开发者免费试用并观察卡点的做法,也侧面说明这类工具的实际适用边界还在摸索中。
小结
Agent多步执行中的部分失败,本质上是分布式系统一致性问题在AI工作流中的重现。幂等重试解决重复副作用,反向补偿解决已发生的副作用,两者互补而非替代。真正需要提前想清楚的是:你的工作流里,哪些步骤一旦执行就收不回来。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today