AI Agent 的 Done 陷阱:六种完成状态与信任危机

Agent 的"Done"掩盖了六种完成状态,读回验证与原始请求对比是可信的关键。
文章指出,大多数 AI Agent 用一个"Done"回应所有操作,却掩盖了从"意图"到"有效果"六个截然不同的层级。工具调用返回 200 只是第 3 步"被接受",却被当作第 6 步"有效果"对外宣称,这正是"它说它发了邮件"类问题的根源。作者提出两个核心修复手段:一是读回验证,Agent 必须从被修改的真实系统中重新读取结果后才能宣布完成,这一步成本极低却能捕获大多数静默失败;二是正确性检查,必须将结果与用户的原始请求对比,而非 Agent 自己的计划,否则选错目标时验证会通过但结果依然错误。第 6 步受外部世界制约无法强制达成,Agent 能做的只是像 WhatsApp 勾号那样诚实地表达自己停在哪一步。
一个词掩盖了六种真相
WhatsApp 用三种勾号解决了"消息到哪了"这个沟通难题:一个灰勾表示已发送,两个灰勾表示已送达,两个蓝勾表示已读。没人需要解释,没人需要追问——状态本身就在说话。
再看大多数 AI Agent。你让它发邮件、更新 CRM 记录、预约时段,它只回你一个词:"Done"(完成了)。这一个词,实际上掩盖了六种截然不同的状态。开发者 devprathap 在其博客中系统性地拆解了这个问题的根源,引发了 Reddit 上的深入讨论。
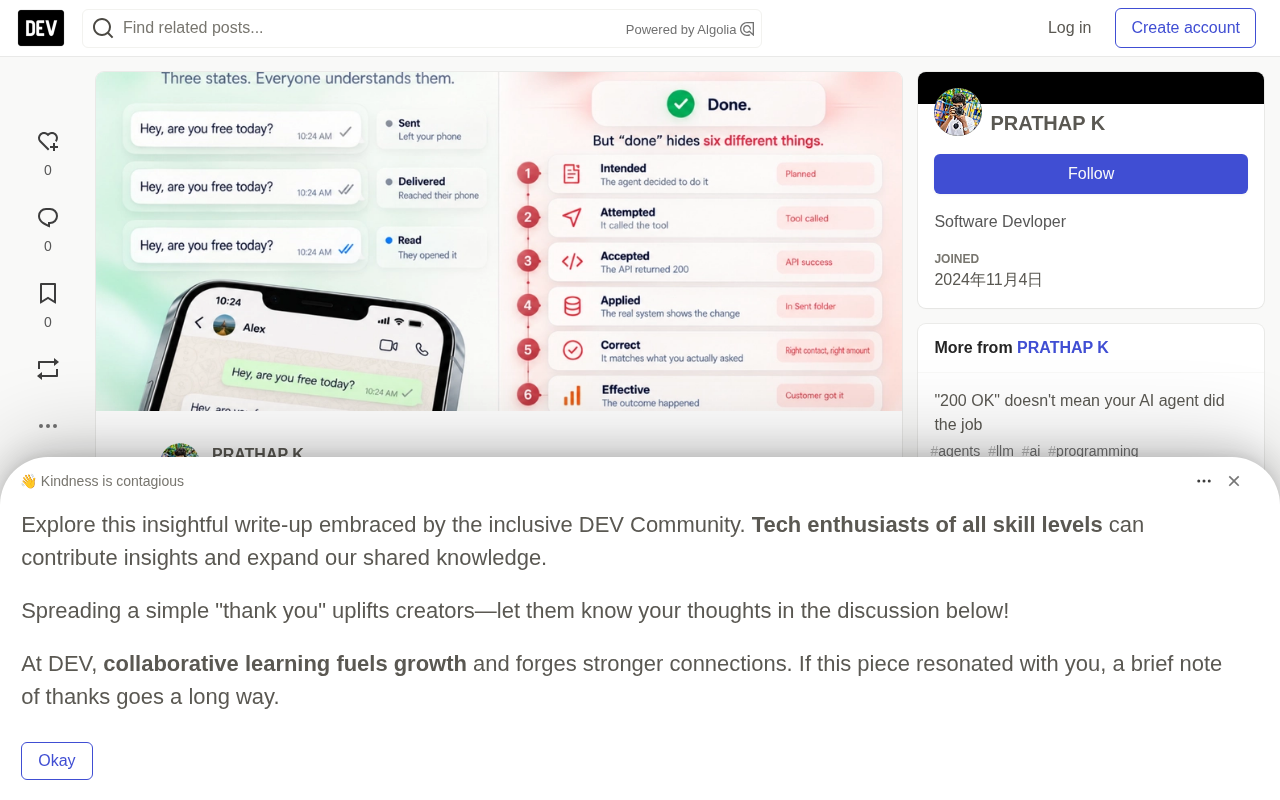
完成状态的六级阶梯
当 Agent 说它"做了某件事"时,它可能处于以下六个层级中的任意一级:
- Intended(意图):Agent 决定要做这件事,但现实世界中什么还没发生。
- Attempted(尝试):它调用了工具,请求离开了你的系统。
- Accepted(被接受):API 返回了 200,对方系统收到了请求。
- Applied(已生效):真实系统中可以看到变化——邮件在已发送文件夹里,数据库里有了这条记录,日历上出现了事件。
- Correct(正确):变化与用户实际要求的一致——对的人、对的金额、对的对话线程。
- Effective(有效果):结果真实发生了——客户收到了邮件,付款清算成功,人确实出席了。
问题的核心在于:大多数 Agent 报告的是第 3 步,却对外宣称是第 6 步。所有"它说它发了邮件"的故事,都源自这个鸿沟。
这六个层级借用了分布式系统与事务处理领域的经典概念。在数据库事务中,ACID 特性里的持久性(Durability)强调写入必须落盘才算真正完成;而在消息队列(如 Kafka、RabbitMQ)中,"至少一次"、"恰好一次"等投递语义同样在区分"已发送"与"已被消费处理"。网络协议层面,TCP 的三次握手确认的是"对方收到了我的包",而非"对方应用程序处理了我的请求"。Agent 所面临的困境本质相同:工具调用返回的 200 相当于 TCP 的 ACK,它只证明通信链路层面的成功,不证明业务语义层面的成功。理解这一区分,是把 Agent 从"看起来能用"推向"可以信赖"的关键认知前提。
为什么第 3 步看起来像终点
构建 Agent 时,工具调用是你代码能看到的最后一步。函数返回了,状态码是 200,响应里有个 id,trace 上显示一个绿色节点。从 Agent 内部来看,故事到这里就结束了。
但 200 只意味着对方系统接受了请求,它并不保证:邮件真的离开了发件箱、工作流规则没有在一秒后覆盖你的 CRM 值、日历没有静默丢掉一个无法匹配的参会者、消息发给了你真正想发的人。
作者此前在第一篇文章中提出过"200 OK 不是 Agent 完成工作的证明",Reddit 上的讨论进一步拓展了这个思路——最终形成了现在这个六层框架。
这里的 200 指 HTTP 状态码 200 OK,是 REST API 最常见的成功响应。但 HTTP 规范定义的成功只表示服务器理解并接受了请求,并不承诺业务逻辑一定被正确执行。实践中,许多系统即使用 200 返回,也可能在响应体中携带业务错误码(如微信、支付宝开放平台常见的 errcode 字段)。更隐蔽的是异步处理:请求被接受后进入队列,后续处理可能失败或被规则覆盖,而最初的 200 早已返回。此外,分布式系统中的"最终一致性"意味着写入后立即读取可能得到旧值,这也是作者建议"短暂延迟后再读回"的原因。因此,把 200 当作完成信号,在工程上是一种常见的乐观假设,也是 Agent 幻觉的重要来源之一。
每一级需要什么证据
这个阶梯最有用的地方在于:每个层级需要不同类型的证据。如果你说不出证据是什么,你就不在那个层级。
| 层级 | 证明方式 |
|---|---|
| Intended | trace 中的计划或工具选择 |
| Attempted | 日志中的出站请求 |
| Accepted | API 返回的状态码和 id |
| Applied | 从真实系统重新读取的结果,而非 Agent 记忆 |
| Correct | 将读取结果与原始请求对比 |
| Effective | 来自外部世界的信号:已送达、已付款、已回复 |
第 1 到 3 步成本很低,从日志中就能免费获得。第 4 步则是价值最大的地方——它只需要多一次读取操作,却能捕获大多数静默失败。
读回验证:从真实系统确认结果
作者遵循的核心规则是:Agent 只有在从被修改的系统中读回结果之后,才被允许说"完成"。
具体实践包括:发送了邮件?检查已发送文件夹或服务商的消息状态,而不是发送调用返回的 id。更新了记录?短暂延迟后重新获取该记录——工作流规则最喜欢在一秒后运行。预约了会议?读取事件并检查参会者列表。
作者分享了一个日常场景:一天有 18 条 WhatsApp 跟进消息要发出,每一条都在聊天界面中确认了勾号状态(已发送或已送达)后,才被标记为完成。这很无聊,但这正是关键——无聊的检查才能让 Agent 值得信任到可以放手不管。
读回验证(read-after-write verification)在工程上对应"写后读一致性"检查,是分布式系统调试和幂等性设计中的常用手段。它的核心思想是:不要信任写入调用的返回值,而要重新查询权威数据源。在实际实现中,需要注意几个细节:一是最终一致性系统可能需要重试读取或加入短暂延迟;二是读回应命中"真实系统"而非 Agent 的短期记忆或缓存,否则等于自我确认;三是对于有副作用的操作(发邮件、扣款),读回本身也可能触发限流或额外成本,需要权衡频率。理想的做法是把读回封装为工具调用的标准后置步骤,让 Agent 在声明完成前自动执行一次确认查询,从而把"盲目自信"转化为"可验证的断言"。
第 5 步最隐蔽:正确性不等于计划一致性
这个洞察来自 Reddit 上的一条评论,它改变了作者的构建方式。
读回验证是将系统状态与 Agent 计划要做的事情对比。如果 Agent 从 CRM 中选错了人,邮件发给了错误的对象,读回结果与计划匹配,这个操作就会被标记为已验证。
一切通过,一切错误。
所以第二层检查需要将结果与原始请求对比,而非 Agent 的计划:这是用户指定的人吗?这是用户要求的金额吗?这是他们在讨论的对话线程吗?
对于任何涉及发送、支付或删除的操作,作者建议两层检查都要有。代价是几行代码,跳过代价则是一封给错误客户的道歉邮件。
第 6 步本质上不在你的控制范围内
你无法强迫别人阅读消息或支付账单。Agent 无法承诺第 6 步一定实现。
但它可以诚实地表达自己停在了哪里。这才是真正的修复方案:不再把六种状态压缩成一个词。
Agent 应该说它真正知道的事情:"邮件 API 已接受"(第 3 步)、"已在你的已发送文件夹中"(第 4 步)、"已发送给 Acme 公司的 Dana,就是你提到的那位"(第 5 步)、"已送达"或"已付款"(当 webhook 确认时,第 6 步)。
这正是 WhatsApp 用勾号做的事——它从不声称知道超过它实际知道的东西。
Webhook 是外部系统主动向你的服务推送事件通知的机制,例如邮件服务商在邮件真正送达或退信时回调、支付网关在款项清算完成时回调。它与主动轮询(polling)互补:轮询受限于频率和成本,Webhook 则能在事件发生时实时通知。对于 Agent 而言,Webhook 是获取第 6 步证据的关键通道——只有外部世界主动回报,Agent 才能从"已接受"升级到"已送达"或"已付款"。工程上需要处理 Webhook 的签名校验、重放攻击防护、投递失败重试等问题,并为其设计幂等的事件处理逻辑,避免同一条通知被重复消费导致状态错乱。
构建 Agent 时的检查清单
如果你正在构建执行真实操作的 Agent,以下是值得追问的几个问题:
- 我的 Agent 今天实际停在哪一步?
- 对于每次写入操作,是否都有从真实系统的读回验证?
- 对于涉及发送、支付或删除的操作,结果是否与原始请求做了对比?
- 用户看到的状态用的是诚实的词,还是只有一个"done"?
- 当读回验证失败时,Agent 是停下来如实报告,还是盲目重试并冒着重复执行的风险?
这些都不需要新框架,只需要 Agent 在正确的词那里停下来。信任不是来自声称完成,而是来自准确表达自己走到了哪一步。
相关推荐

Gemini 4 Argon API实战:思考等级、后台模式一次讲透
Free Code Camp 出品的 Gemini 4 Argon API 速成教程:从申请密钥、发送首次请求,到用思考等级控制推理成本、用 previous_interaction_id 实现多轮对话,再到后台模式一句话生成打砖块游戏,附 Google 工程师对模型能力的解读。

强化学习通关《抡大锤》:63%进度背后的分布式训练策略
开发者用深度强化学习挑战《抡大锤》,智能体从底部攀爬至63%进度,卡在铁砧部分。项目开源,采用分治训练和CPU训练策略,寻求社区协作突破瓶颈。

AAAI 2027二审放榜在即:社区热议评审公平与投稿生态
AAAI 2027第二阶段评审结果即将公布,Reddit社区热议评审一致性与流程透明度。本文梳理放榜前的社区情绪、顶会评审的结构性矛盾,以及作者应对二审结果的务实策略。