AI Agent 的核心原理:一个 Loop 讲透 Codex 与 Claude Code

剥开所有商业 Coding Agent 的外壳,核心只是「调用模型→执行工具→结果回传」的约20行循环。
文章通过一个极简实验揭示了 Codex、Claude Code 等主流 Coding Agent 的共同骨架:一个带出口的循环(Loop)。实验用故意写错的购物车计算函数作为靶子,让 Agent 自主完成「跑测试→发现错误→读代码→修复→再验证」的闭环。核心机制只有四步:把消息发给模型、模型返回 Tool Call、宿主程序执行工具、把结果追加回对话。文章同时指出两个关键工程细节:工具报错必须转成文字交还模型而非让程序崩溃,以及模型没有记忆、每轮都要重发全部历史导致 Token 费用累积。在此基础上,文章梳理了真实 Agent 在 Loop 外围加固的 Harness 层,包括上下文压缩、防失控的轮数上限、以及支持用户实时干预的人机协作钩子,指出商业产品之间的差异本质上只存在于这层 Harness,Loop 本身始终不变。
为什么说 Agent 本质就是一个循环
当我们谈论 Codex、Claude Code、DeepSeek广告 Harness 这些 Coding Agent 时,它们看起来智能到能自己读代码、改 Bug、跑测试。但剥开外壳,核心逻辑简单到只需约 20 行 JavaScript 就能复现——它就是一个 Loop(循环)。
B 站 UP 主 Steven 在这期内容里做了个极简实验:在网页里跑一个迷你 Agent,任务是「跑测试,如果出错就自己修好」。整个过程揭示了所有主流 Agent 共享的同一套机制:调用模型 → 执行模型要求的工具 → 把结果交还给模型 → 再循环,直到模型不再需要工具为止。
这个认知很关键。很多人把 Agent 想象成某种黑魔法,但它真正的骨架是一个带出口的 For 循环。理解了这一点,再看那些商业 Agent 的复杂配置,就能分清哪些是核心、哪些是外围加固。
实验设计:一个故意写错的购物车
示例程序只有两个文件。price.js 里有个 total 函数负责计算购物车总价,price.test.js 负责验证结果对不对。
购物车里有三件 10 块的、两件 5 块的,正确总价应该是 10×3 + 5×2 = 40。但 total 被故意写错了——它只把 10 和 5 相加,算出了 15,完全漏掉了数量。测试断言期望 40,实际得到 15,于是抛出 Error。
修复其实只需改一行:在累加时先把价格乘以数量。这个 Bug 简单到人类一眼能看出,但重点不在于难度,而在于观察 Agent 如何一步步自主完成「发现问题 → 定位 → 修复 → 验证」的闭环。
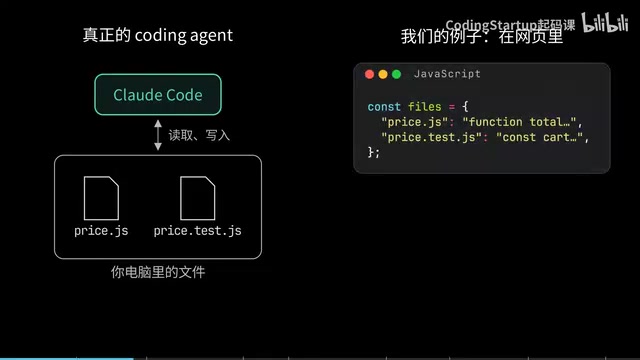
为了避免网页里读写真实文件带来的配置复杂度,实验把两个文件的内容当作字符串放进一个 JavaScript Object。读文件就是取回字符串,写文件就是替换字符串。对模型而言这毫无区别——它只能看到工具的名字和返回的文字,根本不知道背后是真实文件还是一个内存对象。
Loop 的最小实现:四个工具加一个循环
模型可以请求的动作只有四个,全是普通的 JavaScript 函数:列出文件名、读一个文件、替换一个文件内容、跑测试。这四个函数通过 tools 描述介绍给模型——每个工具有名字、一句简短描述和所需参数。
模型看不到函数本身,也无法自己执行任何东西,它只能「请」我们代为执行。
Loop 本身的逻辑极其精炼:
messages一开始有两条:System Message(「你负责修代码」)和用户任务;- 每一轮把全部 messages 发给模型,再把回复 push 进去;
- 如果回复里没有 Tool Calls,说明模型做完了,返回它的文字;
- 如果有 Tool Calls,逐个执行,把结果作为 Tool Message push 回去,然后循环再转一圈。
实际运行时,模型第一轮先列文件,第二、三轮分别读两个文件,第四轮才去跑测试——「先看清楚代码再检查」的顺序相当合理。
这里的 tools 描述机制在 OpenAI 的 API 规范中称为 Function Calling(或 Tool Use),是现代 LLM 与外部世界交互的标准接口。开发者在调用模型时,把每个工具的名称、用途描述和参数 Schema(JSON Schema 格式)一并传入;模型不执行任何代码,而是在回复中输出一段结构化的 JSON,声明它想调用哪个函数、传什么参数。这段 JSON 就是所谓的 Tool Call。程序读取 Tool Call、真正执行对应函数、再把结果包装成 Tool Message 追加到对话,才完成一次完整的「模型请求 → 宿主执行 → 结果返回」的数据流动。这个设计的关键在于:模型永远只负责推理「应该做什么」,从不直接触碰任何系统资源,所有副作用都由宿主程序代为执行并可审计。Anthropic 的 Claude、Google 的 Gemini 以及大多数主流模型都采用了相同的接口约定,这也是为什么文章中描述的 Loop 结构可以跨模型复用。
一个致命细节:错误必须变成文字
第一版代码有个坑。测试失败时 runTests 会抛出 Error,而循环没有 Catch 它,Error 直接跳出 Loop,Agent 停在第四轮什么都改不了。
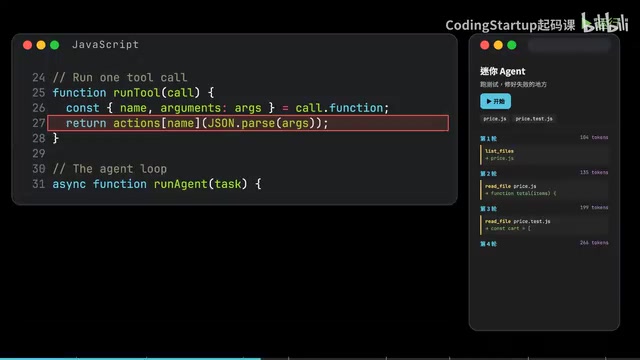
这里藏着 Agent 工程的一条铁律:对 Agent 来说,测试失败也是有用的信息。所以工具必须 Catch 所有 Error,把它变成文字返回给模型。如果模型请求一个不存在的工具,同样变成一句 Error 信息。
真实世界的 Agent 都这么做。Pi 会把找不到的工具、错误的参数、执行时抛出的异常,全部转成一个标明为 Error 的 Tool Result;Hermes Agent 收到错误的工具名时,还会回复有效工具的列表让模型自己改正。错误不该让程序崩溃,而该成为模型下一步决策的输入。
打开黑盒:模型每一轮到底看到了什么
用修好的版本逐轮观察会发现:第一轮模型回复里一个字都没有,只有两个 Tool Call(List Files 和 Run Tests);第二轮它知道测试失败了,于是要求读两个文件;第三轮发出一个 Write File,把 123 个字符的新内容整块替换;第四轮再跑测试,10×3 + 5×2 = 40 通过;第五轮没有 Tool Call,只有文字,Loop 返回答案。
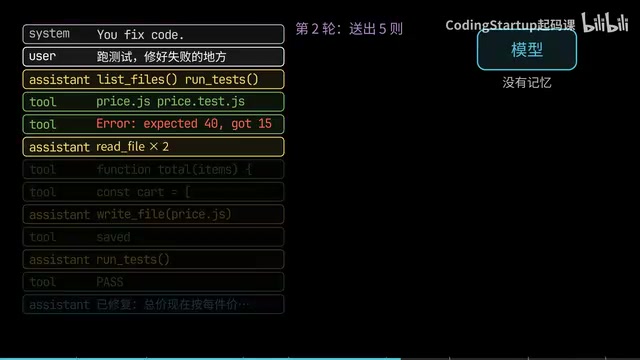
同一个任务跑五次,分别用了 7、6、5、7、5 轮,顺序每次都不同,但五次都写出了同样正确的那行代码。顺序完全由模型自己每轮看完结果后决定——我们的代码没有指定任何步骤。
一个容易被忽略的事实是:模型本身没有记忆。每一轮 Loop 都要从第一条 message 开始,把整个数组重新发一次。实验里第一轮发了 104 个 Token,到第五轮就是 490 个——之前说过的内容每一轮都要重新计费一次。
Harness:Loop 之外的那层加固
迷你 Loop 讲清了核心,但真正的 Coding Agent 还在外面裹了一层 Harness,专门处理工程现实。
上下文压缩是最关键的一环。真实 Agent 会读整个文件、执行输出很长的命令,Context Window 很快就满。Pi 的做法是单个文件或命令输出最多保留 2000 行或 50KB;当对话接近模型上限(约 16384 Token)时,保留最近约 2 万 Token,更早的内容换成一段由模型写的摘要。DeepSeek Harness 则多调一次模型专门写摘要,Hermes Agent 用到某个比例就开始压缩。Loop 本身没变,变的只是每次发出去的内容。
出口与防失控同样重要。Loop 只有一个天然出口——模型不再要求用工具。但模型有时会卡住,不停调用同一个工具,每一轮都是一次要花钱的请求。所以要加 Max Turns 上限:实验里设成 2 时,Agent 读完文件就被强行停下,Bug 还在。真实 Agent 的上限大得多——Hermes Agent 配置里是 500 轮。DeepSeek Harness 还有个更温和的机制:当模型用完全相同的参数重复调用时,在第 3、5、8 次加一句提醒「看看上一个结果,换个方法或者结束」,但不会强制阻止。
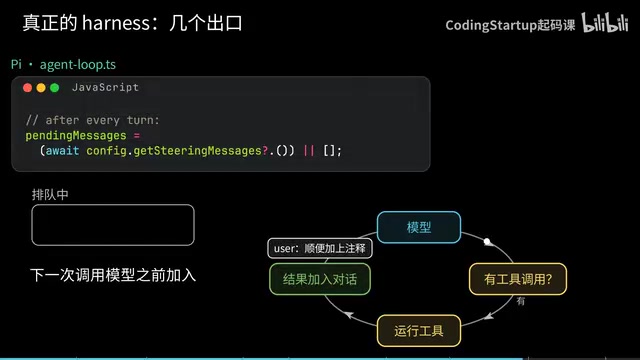
人机协作也发生在 Loop 的缝隙里。Pi 每一轮之后会检查你有没有新消息,你中途打的字会排队,在下次调用模型前被加进 messages,让你实时干预方向。它还有一个 BeforeToolCall 的 Hook,可以在工具执行前返回 Block——这正是「是否允许执行这个命令」权限提示的位置,你拒绝后模型会读到原因并尝试别的办法。
Context Window(上下文窗口)是指模型单次调用时能「看到」的最大 Token 数量。Token 是模型处理文本的基本单位,中文大约 1.5-2 个字对应一个 Token,英文约 4 个字符一个 Token。不同模型的上下文上限差异显著:早期 GPT-3.5 只有 4K Token,GPT-4o 和 Claude 3.5 Sonnet 可达 128K,部分模型甚至达到 1M Token。对 Coding Agent 而言,光是一个中型代码仓库的文件内容、加上多轮工具调用的历史记录,就能轻松超出 128K 的限制。更重要的是,即便模型支持超长上下文,随着输入变长,推理速度会显著下降,费用也线性增长——因为 API 按 Token 计费,且每一轮都要重发全部历史。这正是上下文压缩在 Harness 设计中如此关键的根本原因:它不只是工程优化,而是 Agent 能否持续运行的生存保障。
核心要点回顾
抛开所有工程细节,Agent 的本质可以浓缩成几句话:
- 一个 Agent 就是一个 Loop:调用模型、执行工具、把结果加入对话,重复直到它回答你;
- 工具出错要变成文字交还给模型,不要让程序停掉;
- 模型没有记忆,每轮都看到全部历史,所以 Harness 必须截短和压缩;
- 每个 Loop 都要有出口:没有工具调用、轮数上限、或你点了停止。
Hermes Agent 甚至在外面加了跨 Session 的记忆和定时自动执行的任务,但打开任何一个,核心逻辑依然是这个 Loop。想亲手验证的话,可以试着加第五个工具(比如删除文件),看模型什么时候会用它。
相关推荐

Orca多Agent编排实战:Claude与Codex并行协作指南
Orca是Stable AI开源的免费Agent工作台,支持Claude Code、Codex、Kimi等34个agent并行运行。本文介绍其Git worktree隔离机制、多模型编排分工方案(强模型拆解+便宜模型编码)、手机远程管理功能及实操上手步骤,帮助你高效管理多个AI编程助手。

思维链不止属于AI:人类如何用CoT提升思考质量
思维链(Chain of Thought)不只是大模型的提示词技巧。本文从Hacker News讨论出发,分析CoT为何对人类思考同样有效,拆解可操作的迁移方法,并指出人类CoT与机器CoT的关键差异。
Cloudflare联手OpenAI:用AI打通漏洞发现与防御闭环
Cloudflare联手OpenAI:用AI打通漏洞发现与防御闭环
Cloudflare 使用 OpenAI Daybreak 调查安全漏洞并生成可评审的修复方案,开发者同时借助 Codex 提升编码效率与代码质量,探索漏洞发现到防御响应的一体化路径。