AI Agent 护栏四层防御:从输入到运行时

AI Agent 护栏应分输入、工具行动、输出、运行时四层防御,安全逻辑须嵌入执行路径。
文章主张 AI Agent 的安全不靠更聪明的模型,而靠分层围堵。鉴于提示注入被 OWASP 列为首要风险且无万无一失的防御,目标是把爆炸半径控制在有限范围。护栏分为四层:输入层在推理前做 schema 校验、越狱与间接注入筛查并尽早清除 PII,遵循失败即关闭;工具与行动层杠杆率最高,强调最小权限、工具风险分级、审批绑定精确动作与幂等键、限制循环;输出层强制 schema、做接地性检查与范围控制;运行时层提供脱敏审计日志、成本与调用监控以及可一键触发的终止开关。结论是安全必须活在执行路径里,托管服务处理通用风险,业务逻辑风险须由自有代码承担。
AI Agent 护栏四层防御:从输入到运行时
你的 AI Agent 需要的不是更聪明的模型,而是有效的围堵。这是 Agentic Affairs 一篇关于 Agent 护栏(guardrails)文章的核心主张。OWASP 在 LLM 应用 Top 10 中将提示注入列为首要风险,并明确指出目前尚不清楚是否存在万无一失的防御手段。正因如此,目标不是建造一堵完美的墙,而是构建分层防御:当某层被突破时,爆炸半径被控制在有限范围内,人类则精准地出现在关键决策点上。
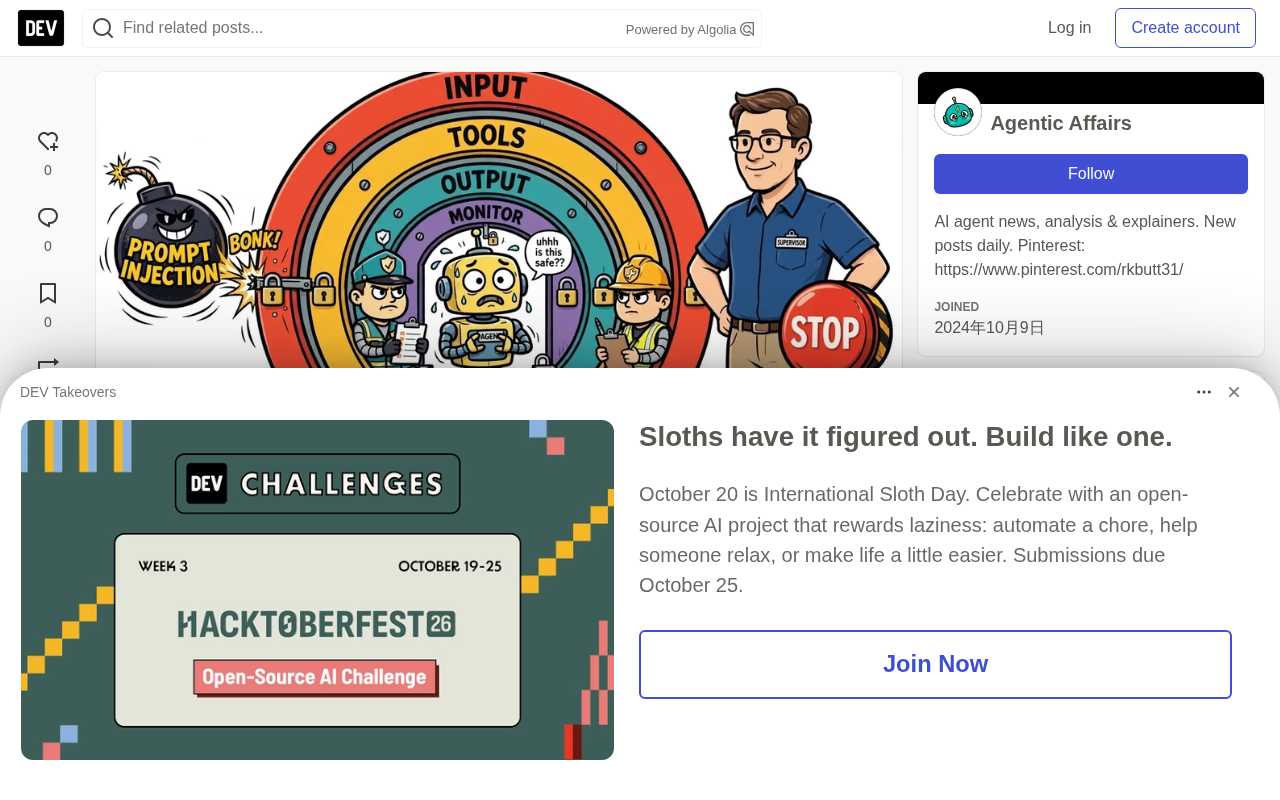
这篇文章将护栏拆解为输入、工具与行动、输出、运行时四个层次,强调安全逻辑必须嵌入执行路径,而非依赖提示词。下面逐层展开。
第一层:输入护栏——把毒药挡在门外
输入护栏的核心任务是在推理发生之前完成校验与清洗。这包括依据 schema 验证结构、设置长度上限、维护允许清单(allowlist)。同时,需要筛查越狱尝试,以及隐藏在 Agent 所阅读文档中的间接注入——关键在于这道关卡位于推理之前,而不是之后。若在模型已经处理了恶意输入之后再拦截,损失可能已经发生。
另一项常被忽视的措施是尽早清除 PII(个人身份信息)。模型从未接收到的数据不可能泄露,这是最可靠的数据保护方式。所有检查应遵循“失败即关闭”(fail closed)原则:检查失败或超时,受保护的操作就不执行。宁可中断流程,也不放行不确定性。
间接提示注入指的是攻击者不直接与 Agent 对话,而是把恶意指令藏在 Agent 会读取的外部数据中——网页、PDF、邮件、工单、代码注释、甚至工具返回的结果。当 Agent 为了完成任务而检索这些内容时,恶意文本会作为“上下文”被模型当成指令执行。这类注入之所以危险,是因为它绕过了面向用户输入的过滤,且来源往往看似可信。防御的关键在于:把检索到的内容当作不可信数据而非指令、在拼接进提示前做隔离与标记,并对由外部内容触发的工具调用施加更严格的审批。
第二层:工具与行动护栏——限制 Agent 能做什么
作者认为这是杠杆率最高的一层:一条策略即可约束所有不可逆操作。具体实践包括:
- 最小权限:保持工具列表尽可能小。如果列表膨胀,就拆分 Agent,而不是赋予单个 Agent 过多能力。
- 为每个工具评定风险等级(低/中/高)。退款、删除、支付、对外发送消息等高风险操作,一律设置审批关卡。
- 将审批绑定到精确动作:审批必须针对这笔订单、这个金额、这个幂等键。一旦状态变化,需要重新获取审批。泛化的“允许操作”不是有效的护栏。
- 限制循环:对每个任务的步数、token、成本和耗时设置硬性上限,防止 Agent 陷入无限循环或成本失控。
这一层的设计哲学是:安全不能寄望于模型“自觉”,而应由代码强制执行。
**幂等键(idempotency key)**是让同一操作重复执行也只产生一次效果的唯一标识。在 Agent 场景中,它有两个作用:其一,防止因重试、循环或并发导致的重复退款、重复下单;其二,让审批与具体动作绑定——审批针对的是“这笔订单 + 这个金额 + 这个幂等键”,一旦参数或状态变化,旧审批自动失效,必须重新获取。没有幂等键,审批就退化为一次性的口头许可,无法约束后续真正执行的那次调用。
第三层:输出护栏——落地之前先验证
输出护栏确保 Agent 的产出在影响外部世界之前经过检验。首先是强制 schema,让格式错误的输出明确失败(fail loudly),而不是静默通过。其次是接地性检查(grounding checks):将输出中的声称与实际检索到的来源进行比对,防止模型编造事实。
此外还需要进行内容审核与范围控制。作者举了一个例子:一个客服 Agent 回答了远超其职责范围的问题,即使答案本身无害,也暴露出范围限定(scoping)的失败。输出护栏不仅关乎内容安全,也关乎 Agent 是否在做它该做的事。
**接地性检查(grounding checks)**用于验证模型输出是否有可追溯的依据。常见做法包括:要求输出附带引用来源,并核对这些来源确实存在于本次检索结果中;对关键字段(金额、日期、政策条款)与原始数据做一致性比对;对无法在来源中找到支撑的声称标记为未经验证或直接拒绝。它对付的是模型“一本正经地编造”——幻觉在客服、金融、医疗等场景中可能直接转化为错误决策,因此接地性检查是输出落地前的最后一道事实关卡。
第四层:运行时护栏——盯着循环
运行时护栏关注 Agent 执行过程中的可观测性与紧急控制。审计日志需要脱敏处理——原始日志本身可能成为你试图防止的数据泄露源。监控指标应覆盖延迟、错误率、工具调用模式和每任务成本,这些信号能及早暴露异常行为。
最关键的或许是终止开关(kill switch):一种由人类操作的、快速停止 Agent 的方式。作者强调,它必须是一个按钮,而不是一张工单——在事故发生时,走流程审批意味着错过止损窗口。
**终止开关(kill switch)**是运行时护栏的最后手段,其设计要点在于“快”和“独立”:它应当能在不依赖 Agent 自身逻辑的情况下切断执行,例如通过特性开关(feature flag)直接禁用某类工具调用、吊销凭证或暂停任务队列。有效实现通常要求开关由人直接触发、有明确的责任人、并经过演练,确保在压力下真的可用。与工单式流程相比,终止开关的价值在于把止损时间从小时级压缩到秒级。
核心结论:安全活在执行路径里
文章最后给出了一个清晰的判断标准:安全存在于执行路径中——审批绑定、状态版本检查、幂等键——而不是在提示词里。一个模型可以靠话术绕过的策略,不配称为护栏。
在工具选型上,作者区分了两类风险:托管服务(如 Bedrock Guardrails、Azure AI Content Safety)擅长处理毒性、注入等通用风险;而业务逻辑风险——退款限额、审批工作流、终止开关——必须由你自己的代码来承担。这一分工判断对正在构建生产级 Agent 的团队具有直接的参考价值。
完整实现指南(包括高风险退款工具调用的端到端策略流程,以及 Bedrock 与 Azure 的对比)发布在 Agentic Affairs 上。
相关推荐

吴恩达联手Anthropic:Claude Code保姆级实战教程全解析
吴恩达与Anthropic合作推出Claude Code短课程,系统讲解清晰上下文、并行会话、MCP服务器等最佳实践,并通过RAG聊天机器人、Jupyter数据分析、Figma转前端三个实战项目,带你从零掌握这款高自主性编程助手。

入门Agent只推荐三个:ZeroStack、Claude Code与DeepSeek Harness
B站UP主推荐三款入门Agent:ZeroStack适合轻量设备,Claude Code生态完善,DeepSeek Harness易于集成插件。本文梳理各工具适用场景与实用技巧。

AI Agent如何操控你的电脑?Hermes三层工具链全解析
B站UP主小悠拆解Hermes操作电脑的三层工具链:出厂自带的Terminal、文件修改与代码执行底座,按需开启的联网搜索、视觉分析、语音合成与浏览器桌面控制,以及通过CLI和MCP自由扩展的外部生态,并解答SSH连上却操作不了的常见困惑。