AI Agent vs LLM:Cursor和Claude Code如何真正工作

编码Agent通过模型、上下文、工具和反馈循环执行真实操作,但结果仍需开发者验证。
文章以Spring Boot注册API的无效邮箱处理为例,拆解了LLM与编码Agent的本质区别:LLM只生成代码建议,而Agent通过授权工具执行文件编辑和测试命令。Agent由模型解读任务、上下文提供相关代码、工具执行真实操作和反馈指导下一步四个构建块组成,其运行依赖工具调用边界和权限控制。在大型代码库中,Agent通过搜索和符号查找构建聚焦上下文,选择质量决定效果。找到相关文件后,Agent提出最小补丁并运行测试,但工具执行成功不等于软件正确,开发者必须审查diff、运行聚焦测试并确认行为。给Agent仓库访问权是信任决策,应遵循最小权限原则,对风险操作保留人工审批。Cursor和Claude Code底层模式相似,选择工具应比较权限、上下文质量和测试集成,而非仅看模型名称。
AI模型能为你建议代码,但AI Agent可以直接修改文件并运行测试。两者之间的实际差异在哪里?本文通过Spring Boot Bug修复实例,拆解Cursor和Claude Code这类编码代理如何理解仓库、发起工具调用以及验证结果。
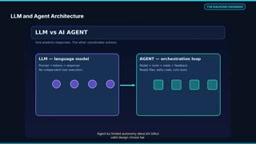
LLM和Agent在编码请求上的本质区别
面对一个编码请求,LLM和Agent的行为差异显著。LLM根据提示和可用上下文生成有用的文本或代码建议,但不会自动更改仓库。Agent则执行授权工具,将模型的决策与允许的文件操作和测试命令连接起来。然而,工具执行成功并不等于软件行为正确,最终仍需开发者验证结果。
以Spring Boot注册API的无效邮箱处理为例。普通聊天响应可以建议使用@Email注解和有效邮箱格式,但你需要自行检查项目。编码Agent若拥有已批准的工具,则能识别相关DTO、控制器和测试,并提出补丁。这并不意味着Agent不会犯错,而是说工作流变得更可操作。
编码Agent的四大构建块
一个编码Agent由四个部分协同工作:
- 模型解读任务:理解用户请求并提议下一步,但不能盲目将输出当作事实执行。
- 上下文提供相关代码:相关源文件、项目约定和失败测试构成决策基础。
- 工具执行真实操作:读取文件、搜索、应用补丁或运行测试都在运行时执行。
- 反馈指导下一步:根据实际输出,Agent可以修正自己的方法。
这一架构中的关键区别在于:生成答案和执行实际操作是分离的步骤。Agent并非拥有神奇智能的独立实体,通常是模型加上周边编排的组合。给予Agent有限自主权是完全合理的设计选择。
Agent循环与工具调用的边界
Agent循环可以简单理解为:解读任务→选择动作→执行工具→获得观察结果。如果测试失败,Agent可将错误作为新上下文;若输出满意,工作流可停止。真实系统中,最大步数、超时和审批关口控制着这个循环。Agent的速度不如其每一步是否基于证据重要。
当模型发出读取文件的结构化工具请求时,实际文件并不会在模型内部打开。宿主应用或Agent运行时会检查权限并执行操作,然后将文件内容或错误信息作为结果返回给模型上下文。登录、权限检查和安全执行在这一边界至关重要。
工具调用(Tool Calling / Function Calling) 是大模型与外部系统交互的核心机制。模型并不直接执行代码,而是输出结构化的 JSON 描述它想调用的工具名称和参数,例如 {"name": "read_file", "arguments": {"path": "src/main/java/..."}}。宿主应用解析该请求后,才会真正执行文件读取、搜索或运行测试,并将结果作为新的消息回传给模型。这种设计把“决策”和“执行”解耦,使得权限检查、审计日志和人工审批可以插入到执行之前,是编码 Agent 安全性的基础。
大型代码库中的上下文选择
在大型Java仓库中,模型不会自动记住所有类。搜索、符号查找和相关文件检索共同构建聚焦上下文。对于注册验证Bug,控制器、请求DTO、全局异常处理器和现有测试将是有用文件。无关配置和数百个文件同时涌入会使上下文变得嘈杂。选择质量至关重要。
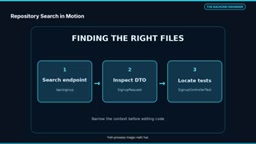
这一过程并非魔法。Agent必须检查搜索结果,决定下一个相关文件。修复注册Bug前,Agent需要识别团队特定的位置:搜索注册端点以定位路由和控制器方法,检查请求DTO中邮箱字段的注解和验证路径,定位现有测试以理解项目测试模式并添加相关回归用例。
安全的最小代码变更与验证
找到相关文件后,下一个挑战是安全的最小代码变更。开发者的任务是拒绝无效邮箱并返回清晰的客户端错误。Agent会先检查代码,然后提出最小补丁并在允许的环境中应用。但必须查看diff:现有端点契约是否改变?验证依赖是否可用?业务逻辑是否被意外影响?文件被修改不是完成的证明。
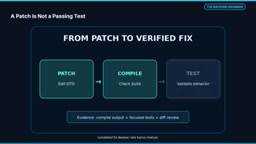
在示例中,注册请求记录的邮箱字段带有@NotBlank和@Email注解,控制器参数上的@Valid注解触发请求验证。但这不是可直接用于生产的补丁,需要根据现有应用检查验证依赖、导入、异常响应和集成测试。
补丁应用后,依次编译和运行聚焦测试。如果编译失败,精确的错误日志成为下一步输入;如果测试失败,调查相关断言和变更行为。绿色测试是 helpful 信号,但不保证完全正确。开发者应审查最终diff、边缘情况和安全影响。生产代码接受前需完成四项快速检查:编译应用以检测语法和依赖问题;运行聚焦测试执行针对变更行为的回归用例;审查最终diff检查意外修改、安全问题和API契约变更;确认预期行为与实际要求匹配。
@Valid 与 Bean Validation 是 Spring Boot 中声明式校验的关键组合。@Valid 加在控制器方法参数上,会触发对请求体的级联校验;而 @NotBlank、@Email 等约束注解声明在 DTO 字段上,由 Hibernate Validator 等实现执行。校验失败时,Spring 会抛出 MethodArgumentNotValidException,默认返回 400 状态码,并可通过 @ControllerAdvice 自定义错误响应结构。理解这条链路有助于判断 Agent 的补丁是否真正接入项目的异常处理约定,而非仅仅添加了注解。
权限控制与安全边界
给Agent仓库访问权是一个信任决策。从只读探索开始更安全。文件权限、shell命令和包安装应保持受控权限。仓库文件或网页中可能包含恶意指令,因此不要将工具输出视为可信系统指令。不要暴露机密和生产凭证,不可逆操作必须保留人工审批。
安全编码工作流的一些边界不可协商:使用最小权限;共享文件和命令的访问需谨慎;风险操作、部署、破坏性命令和机密访问必须经人工审核;将工具输出视为未经验证的内容,不让仓库注释或外部文本成为更高优先级的指令。
Cursor与Claude Code的共性模式
Cursor和Claude Code是编码Agent工作流的示例。界面和可用集成可能不同,但底层模式相似:任务、上下文、模型决策、授权工具执行和反馈。
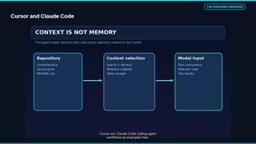
选择工具时不要只比较模型名称。权限、上下文质量、diff审查、测试集成和团队工作流是更有用的比较点。具体产品功能会随时间变化。
并非每个编码问题都需要完整的Agent工作流。多步骤任务、基于代码的搜索、重复重构和测试调查适合受控自动化。解释和简单概念澄清可能不需要仓库访问,聊天模型足矣。人类保持问责,关键决策和最终软件质量的归属权在开发者手中。根据任务复杂度和所需人工审查的权衡,决定是否启动Agent是实际差异所在。
核心要点
LLM生成响应,模型产生文本和代码建议,但不会自行执行文件操作。仓库上下文引导决策,相关文件和失败测试使Agent的下一步更好。工具执行真实动作,Agent运行时在受控权限内运行文件编辑和测试命令。开发者验证结果,测试、diff审查和人工判断决定最终质量。AI Agent不只是建议代码,它们通过工具采取行动,但最终验证仍是开发者的责任。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。