AI Agent安全层实战:Cerbere AG寻求早期测试者

独立开发者推出AI Agent安全控制层Cerbere AG,免费招募早期用户以验证产品价值与商业路径
随着AI Agent逐步进入生产环境,其自主访问数据、调用API、发送邮件等能力带来的安全隐患日益突出。来自金沙萨的独立开发者为此构建了Cerbere AG——一套包含SDK、运行时、仪表盘、检测系统和公开基准测试的AI Agent安全控制层。目前开发者正免费招募5至10名已部署或接近部署真实Agent的早期合作伙伴,核心诉求是用产品使用权换取真实工作负载下的诚实反馈,并探索用户的付费意愿。文章同时指出,安全层产品的价值必须在真实攻击面与业务场景中才能被验证,而独立开发者在这一专业赛道面临的最大挑战是冷启动阶段的信任建立与分发难题。
当AI Agent开始自主行动,谁来守护安全边界?
随着AI Agent从概念走向生产环境,一个被长期忽视的问题正浮出水面:当智能体能够访问数据、调用API、使用MCP协议、发送邮件甚至自主执行决策时,如何确保它们的行为处于可控、可审计的范围内?
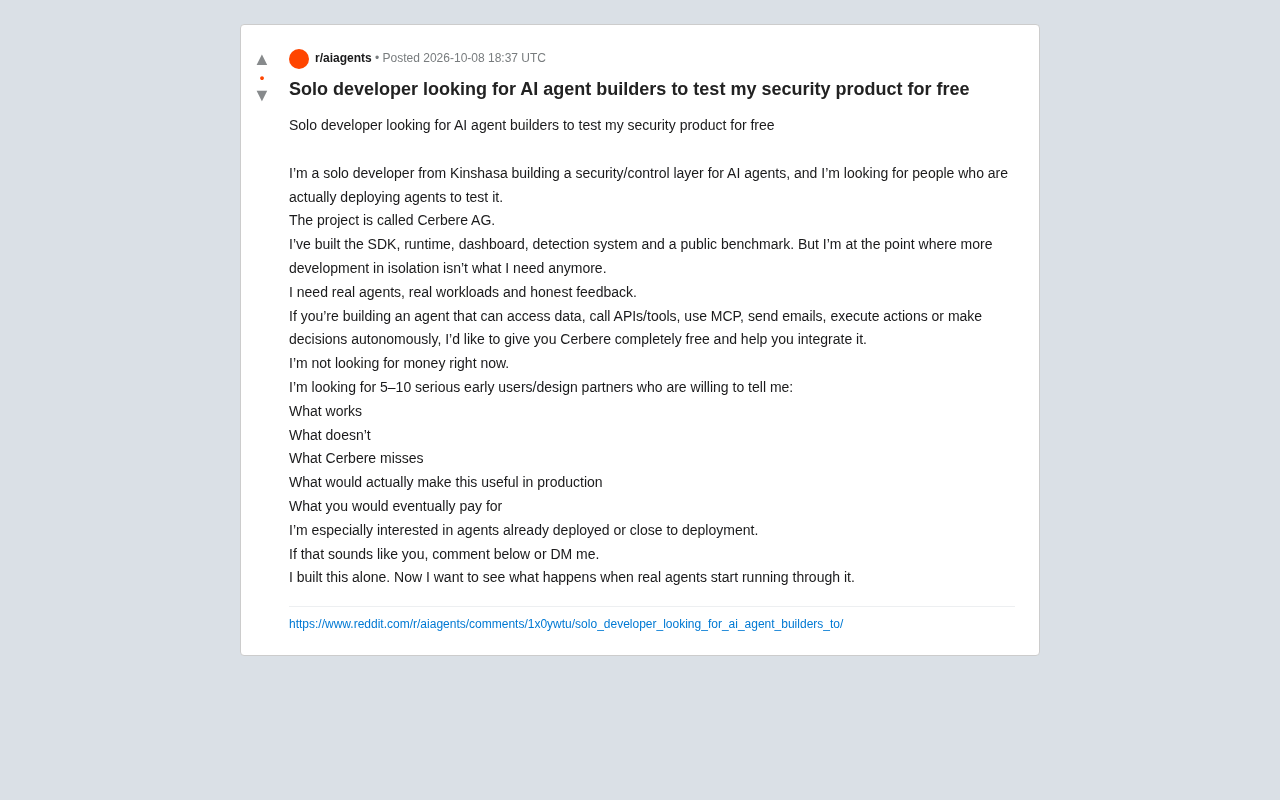
来自金沙萨(Kinshasa)的独立开发者正在尝试回答这个问题。他开发了一款名为 Cerbere AG 的产品——定位为AI Agent的"安全与控制层"(security/control layer),并公开招募5到10名认真的早期用户与设计合作伙伴,免费试用其完整工具链。
Cerbere AG 到底是什么
从开发者的自述来看,Cerbere AG 并非一个概念原型,而是已经具备相对完整形态的产品栈。据其描述,项目已经构建了以下几个核心组件:
- SDK:供开发者将安全控制能力集成到自己的Agent中;
- Runtime(运行时):在Agent执行动作时进行实时监控与干预;
- Dashboard(仪表盘):提供可视化的行为观测界面;
- Detection system(检测系统):识别Agent异常或高风险行为;
- Public benchmark(公开基准测试):用于衡量安全层的有效性。
这套组合拳覆盖了从集成、运行、监控到评估的完整闭环。对于一个独立开发者而言,能在隔离环境中把这些模块全部搭建出来,说明其对Agent安全问题有相对系统的思考,而不仅是停留在想法层面。
**安全控制层(Security/Control Layer)**是近年来随着AI Agent落地而出现的新型中间件概念,其核心思想类似于传统软件架构中的API网关或防火墙:在Agent的执行路径上插入一个可观测、可拦截的代理层,而非修改Agent本身的逻辑。这类产品通常以SDK或Runtime Proxy的形式存在,能够捕获Agent发出的每一个工具调用、API请求或数据操作,在动作真正执行之前进行规则校验、风险评分或人工审批。与传统应用安全不同,AI Agent的行为具有高度不确定性——LLM每次推理的决策路径难以提前穷举,这使得基于规则的白名单策略往往不够用,检测系统还需要具备语义理解和异常基线建模能力。Cerbere AG所描述的组件组合,正是对这一挑战的系统性回应。
为什么他需要"真实的Agent"
这位开发者坦言,自己已经走到了一个瓶颈:在隔离环境中继续开发已经不是他现在最需要的东西。 他真正需要的是真实的Agent、真实的工作负载,以及诚实的反馈。
这是一个值得所有工具型产品开发者共鸣的阶段性困境。安全类产品尤其如此——其价值只有在面对真实攻击面、真实调用链路和真实业务场景时才能被验证。一个在"玩具Agent"上跑得完美的检测系统,可能在生产环境中漏洞百出。
他明确列出了希望从早期用户那里得到的五类反馈:
- 什么功能有效(What works)
- 什么功能无效(What doesn't)
- Cerbere 遗漏了什么(What it misses)
- 什么能让它在生产环境中真正有用
- 用户最终愿意为什么付费
最后一条尤其关键——它透露出开发者并非纯粹做开源公益,而是在为商业化探路。当前的免费策略,本质上是用产品使用权换取真实场景数据和付费意愿验证。
他想要什么样的合作者
开发者特别强调,目标用户是"已经部署或接近部署的Agent"的构建者。换句话说,他不需要停留在Demo阶段的实验项目,而是希望接触那些已经让Agent接触真实数据、调用真实工具、承担真实后果的团队。
具体来说,如果你正在构建一个具备以下任一能力的Agent,就属于他的理想测试对象:
- 能访问数据
- 能调用 API 或工具
- 使用 MCP(Model Context Protocol)
- 能发送邮件
- 能执行动作或自主做出决策
这份清单恰好勾勒出当下"高风险Agent"的典型特征。一个只会聊天的Agent几乎不需要安全层,但一个能自己发邮件、改数据、调用外部服务的Agent,一旦失控,后果可能相当严重。Cerbere 瞄准的正是这块正在快速扩大的风险地带。
**MCP(Model Context Protocol)**是由Anthropic于2024年底提出并推动的开放协议,旨在标准化LLM与外部工具、数据源之间的交互方式。在此之前,各家AI应用对工具调用的实现各自为政,缺乏互操作性。MCP定义了一套统一的客户端-服务器架构:LLM作为客户端,通过MCP协议向各类"MCP Server"发起工具调用请求,后者可以是本地文件系统、数据库、浏览器控制器乃至企业内部系统。这使得Agent的能力边界得以大幅扩展,同时也显著增加了攻击面——任何MCP Server都可能成为注入恶意指令或泄露敏感数据的入口。Cerbere AG将MCP明确列入目标场景,说明其检测系统需要能够解析和审计符合MCP协议格式的调用内容,而不仅仅是通用的HTTP流量监控。
独立开发者的现实样本
抛开产品本身,这则招募帖也是一个颇具代表性的独立开发者样本。
开发者反复强调"我独自构建了这一切"(I built this alone),并直言"现在不是在找钱"(I'm not looking for money right now),而是想看看"当真实的Agent开始跑在它上面时会发生什么"。这种心态在早期技术创业者中并不罕见:先验证价值,再谈变现。
对于AI安全这个相对专业的赛道而言,独立开发者的最大挑战往往不是技术实现,而是冷启动的信任与分发。没有名气、没有团队背书的情况下,通过社区公开招募早期合作伙伴,用免费集成支持换取真实反馈,是一条务实但艰难的路径。
对开发者的几点提醒
如果你恰好在构建生产级Agent,并对这类安全控制层感兴趣,不妨将这类早期产品纳入观察清单。但在真正接入前,有几点值得保持理性判断:
- 数据边界:安全层通常需要观测Agent的行为乃至部分调用内容,接入前应明确其数据处理方式;
- 成熟度预期:这是明确处于早期阶段的产品,稳定性和功能完整度需要你自己评估;
- 反馈价值:作为早期设计合作伙伴,你的意见可能直接影响产品走向,这既是机会也意味着投入成本。
AI Agent的安全治理仍是一片蓝海,这类来自一线独立开发者的尝试,无论最终成败,都在为这个新兴领域积累真实的经验数据。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。