AI Agent安全护栏实战:权限管控、输入输出校验与风险隔离

本文系统介绍AI Agent安全护栏的核心机制,涵盖中间件钩子、确定性防护与模型驱动防护两大策略。
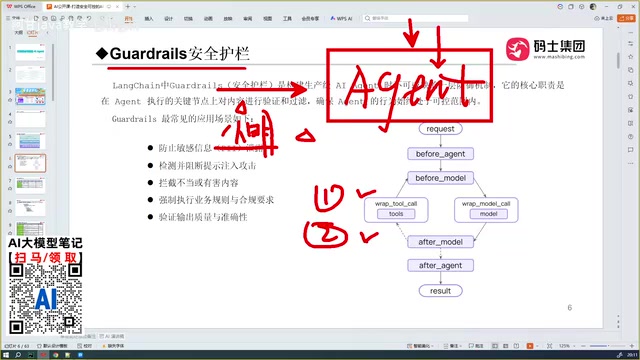
随着AI Agent接入真实业务系统,安全防护成为不可缺少的基础能力。本文围绕安全护栏(Guardrails)展开,将其防护环节拆解为输入端违规拦截、执行过程敏感信息脱敏、输出端内容检测三个层次,并说明底层依赖中间件钩子机制实现——开发者可在Agent调用前后、模型调用前后、工具调用前等多个节点插入独立的校验逻辑。防护策略分为两类:确定性防护利用正则等规则精准处理手机号、身份证等结构化敏感信息;模型驱动防护则借助大模型的语义理解能力识别隐晦的合规风险与提示词注入攻击。两者互补,共同构成Agent应用的安全基座。
AI Agent安全护栏实战:权限管控、输入输出校验与风险隔离
当AI Agent逐渐接入真实业务系统,它不再只是一个聊天工具,而是能够调用数据库、执行工具、访问敏感信息的执行体。这意味着安全问题从「锦上添花」变成了「必备防线」。本文基于码士集团的实战教程,梳理AI Agent安全护栏(Guardrails)的核心机制、实现原理与两类防护策略。
什么是安全护栏(Guardrails)
Guardrails直译为「护栏」「栅栏」,在AI Agent场景中指的是一套贯穿对话全流程的安全防护机制。它要解决的核心问题可以拆成三个环节。
第一是输入端的违规拦截。用户提问中可能包含违禁词或攻击性内容,比如教程中举例的「小明」作为假设的违禁词——一旦用户输入命中,系统就可以在消息交给Agent之前进行截断处理。
第二是执行过程中的敏感信息脱敏。Agent内部往往会结合业务,通过MCP工具查询业务数据,返回结果里可能夹带用户的手机号、身份证号、银行卡号等敏感信息。这些内容需要在展示给用户之前完成脱敏或过滤。
第三是输出端的模型回复检测。即便模型本身没问题,它也可能生成逻辑不通、有误导性甚至有害的答案。护栏可以对模型输出做安全检测和处理。
主要应用场景
归纳起来,安全护栏覆盖这几类典型场景:
- 防止敏感信息泄露:拦截身份证、手机号、银行卡号等隐私数据外泄;
- 抵御提示词注入攻击:也就是常说的「投毒」,恶意用户试图通过对话污染模型上下文,护栏可以在有害内容进入模型前就将其拦截;
- 业务合规性检测:对输入输出内容做合规校验,满足业务层面的监管要求。

提示词注入攻击(Prompt Injection)是AI Agent场景中最值得关注的新型攻击面之一。攻击者通过在用户输入或外部数据源中嵌入特殊指令,试图覆盖或篡改系统预设的行为规则,例如让模型忽略安全限制、泄露系统提示词,甚至借助Agent的工具调用权限执行恶意操作。与传统SQL注入类似,受害方是信任输入内容的"执行者"——在AI Agent中就是大模型本身。由于Agent往往具备读写数据库、发送请求、调用外部API等能力,一旦注入成功,危害会远超单纯的信息泄露。护栏在"before Model"节点对输入内容进行模式扫描和语义过滤,是阻断此类攻击的关键防线。
实现原理:基于中间件的钩子机制
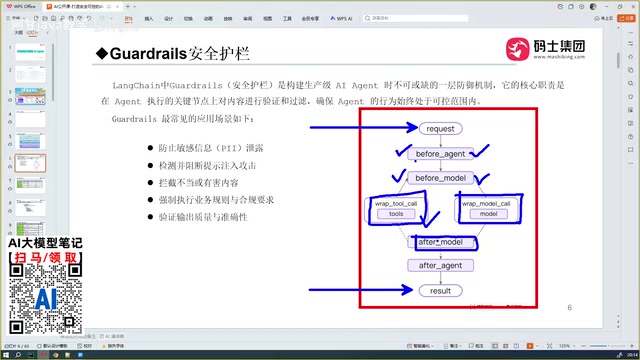
安全护栏的底层实现依赖于中间件(Middleware)。可以把中间件理解为一段能够随时插入到Agent对话流程中的执行逻辑——本质上就是钩子函数(Hook)。无论是在Agent调用前后,还是模型调用前后,都能插入不同的处理逻辑。
从用户发起request到最终返回结果,整个Agent对话流程会经过多个中间件节点:
关键中间件节点
- before Agent:Agent执行之前触发,可在此做前置业务处理;
- before Model:调用模型之前触发,用于对输入信息做处理;
- wrap Model Call:比before Model更贴近模型调用环节,可对模型调用做包裹处理;
- before Tool Call:执行工具调用之前触发;
- after Model:模型调用完成后触发,用于对模型回复内容做额外处理;
- after Agent:把最终结果交给用户之前触发的最后一道关卡。
这套钩子机制让开发者可以精细地控制对话流程的每一个环节。安全护栏正是通过在这些节点插入检测与处理逻辑,实现输入校验、执行隔离和输出脱敏。
中间件模式(Middleware Pattern)在Web框架领域已被广泛验证,Express、Django、Spring等框架均以此为核心扩展机制。其本质是将请求/响应的处理流程拆解为一条有序的责任链,每个中间件节点可以读取、修改或终止流程中的数据。迁移到AI Agent场景后,这一模式同样适用:对话请求从用户发出到最终响应,经过多个可插拔的处理节点,每个节点都可以独立开发、独立测试。这种设计的优势在于关注点分离——安全校验、日志记录、限流熔断等横切关注点无需侵入核心业务逻辑,而是以插件形式挂载到对应的钩子点上。对于团队协作开发而言,安全团队可以独立维护护栏规则,不影响Agent的功能迭代。
两类防护栏:确定性防护 vs 模型驱动防护
安全护栏按照实现方式可以分为两大类,二者互补,覆盖不同类型的风险。
确定性防护栏
确定性防护针对的是格式固定、模式明确的敏感信息,比如身份证号、手机号、银行卡号。这类信息有清晰的规则特征,可以通过正则匹配等确定性手段精准识别,然后进行脱敏、截断或额外处理。
这类防护的优点是准确、可控、性能高,但它的局限也很明显——只能处理「长得像敏感信息」的固定模式内容。

正则表达式(Regular Expression)是确定性防护栏的核心工具。以常见敏感信息为例:中国大陆手机号符合1[3-9]\d{9}的格式,身份证号符合18位数字加末位校验码的规则,银行卡号则通常满足Luhn算法校验。这些规律明确的结构,使得正则匹配在准确率和性能上都优于调用大模型判断。在实际工程中,确定性防护通常被部署为一组规则列表,可按需增删,兼顾灵活性与可维护性。值得注意的是,脱敏处理不等于完全删除——常见做法是将手机号替换为138****5678、身份证中间段替换为*,在保留可读性的同时避免隐私暴露。
模型驱动防护栏
确定性防护处理不了更隐蔽的风险。举例来说,一个大模型回复的内容读起来语句通顺、没有明显违禁词,却在隐晦地引导用户走向错误操作。这种以自然语言表达的风险,靠固定规则检测不出来。
这时就需要模型驱动的防护栏:借助模型自身的理解能力,去判断回复结果到底合规还是不合规、有没有潜在问题。它牺牲了一部分确定性和性能,换来了对复杂语义风险的识别能力。
两类防护栏并非互斥,而是配合使用:确定性防护守住结构化敏感数据的底线,模型驱动防护补足语义层面的风险识别。
小结
构建安全可控的AI Agent,核心思路是把安全能力嵌入对话全流程。通过中间件钩子机制,可以在Agent调用、模型调用、工具调用的前后各个节点插入校验逻辑;再结合确定性防护与模型驱动防护两种策略,分别应对结构化敏感信息与语义级风险。对于要接入真实业务的Agent应用,这套Guardrails体系是不可省略的安全基座。
相关推荐

MCP 实战:在 OpenAI Agents SDK 中接入外部工具
本文基于 YouTube 教程,详解如何在 OpenAI Agents SDK 中使用 MCP(模型上下文协议)接入外部工具:从构建 MCP 服务器、注册工具,到 stdio、streamable HTTP、Hosted MCP 三种连接方式,以及工具过滤的实战技巧。

深入MCP协议:AI Agent工具调用背后的性能陷阱
深入解析MCP(模型上下文协议)如何支撑AI Agent工具调用:JSON-RPC封装的性能开销、SSE多路复用的安全隔离,以及工程团队在生产环境中绕过协议直连数据库的真实权衡。

用 YAML 构建协作式 AI 智能体团队:Docker Agent 实践
Docker Agent 让你用 YAML 声明式配置构建协作式 AI 智能体团队,无需手写智能体代码。支持多智能体自动委派、MCP 工具集成,兼容 OpenAI、Anthropic、Gemini 等多种模型,配置可版本化、可共享。