AI Agent部署难题:Serverless MicroVM运行时如何破解后端困境

一文拆解AI Agent后端化的基础设施瓶颈,及MicroVM运行时的解法
随着AI Agent能力日趋成熟,将其嵌入真实产品后端的基础设施挑战正成为落地的主要障碍。本文聚焦两大核心难题:Serverless平台的硬性超时限制让动辄运行数十分钟的Agent任务无法承载,而安全执行Agent生成代码所需的Docker容器管理成本又居高不下。针对这些痛点,文章介绍了一套基于MicroVM与快照技术的Serverless Agent运行时方案,其核心思路是将每个Agent会话当作独立的托管后端Worker——HTTP请求毫秒返回,任务在隔离沙箱中持续执行。通过会话与请求解耦、分级资源回收与即时快照恢复、异步Human-in-the-Loop以及BYOK硬件隔离等架构设计,该方案试图在成本、安全与开发体验之间找到平衡,为正在产品化Agent能力的工程团队提供一个无侵入性的基础设施层。
当AI Agent遇上后端部署:一道绕不开的基础设施难题
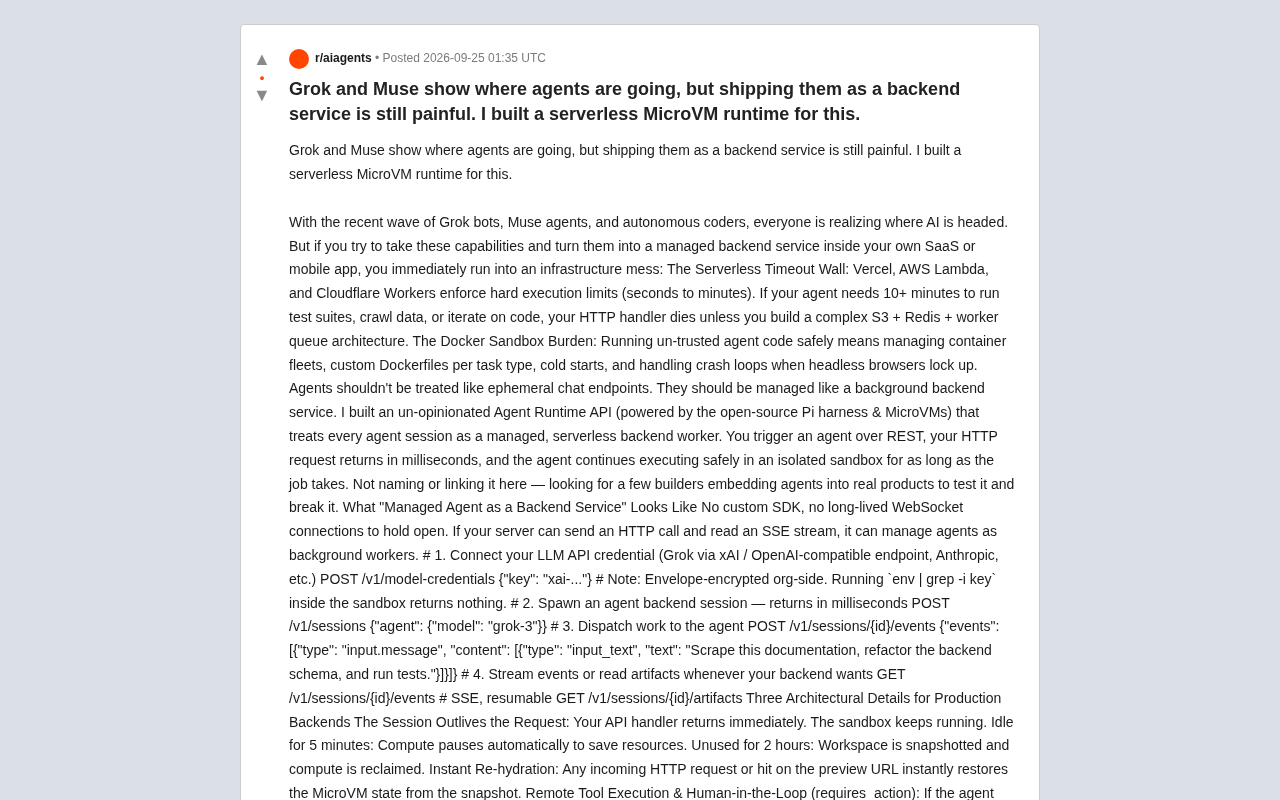
随着Grok bots、Muse agents以及各类自主编程助手的涌现,业界对AI Agent的走向已形成清晰共识。但一位Reddit开发者在其分享中指出了一个被普遍低估的现实:把这些能力真正嵌入到自己的SaaS或移动应用后端,却是一场基础设施的噩梦。
问题的核心不在于Agent本身的智能,而在于运行它们所需的执行环境与传统Web服务架构存在根本性冲突。这位开发者为此构建了一套基于MicroVM的Serverless Agent运行时,试图从架构层面解决这个痛点。
两堵挡在开发者面前的墙
Serverless超时墙
第一个障碍是执行时间限制。Vercel、AWS Lambda、Cloudflare Workers这类主流Serverless平台都强制施加了硬性执行上限,从几秒到几分钟不等。
但真实的Agent工作负载往往完全不同——一个需要跑完整测试套件、爬取数据或反复迭代代码的Agent,动辄需要10分钟以上。在这种场景下,你的HTTP handler会直接超时死亡。除非你愿意搭建一套复杂的 S3 + Redis + worker queue 架构来手动管理异步任务,否则根本无法承载。
Docker沙箱负担
第二堵墙是安全执行不可信代码的成本。要安全地运行Agent生成的代码,意味着你得管理容器集群、为不同任务类型维护定制Dockerfile、应对冷启动,还要处理无头浏览器卡死时的崩溃循环(crash loop)。
作者的观点很鲜明:Agent不应该被当作短暂的聊天端点(ephemeral chat endpoint)来对待,而应该像后台后端服务(background backend service)那样被管理。 这个视角的转变,正是其架构设计的出发点。
MicroVM(微型虚拟机)是介于传统虚拟机与容器之间的轻量级隔离技术,以AWS Firecracker为代表。它通过裁剪Linux内核、去除不必要的设备驱动,将虚拟机启动时间压缩到100毫秒以内,同时提供硬件级内存隔离——这是Docker容器无法保证的安全边界。快照(Snapshot)机制则允许将运行中的MicroVM内存状态持久化到磁盘,下次恢复时无需重走完整的操作系统启动流程,可在毫秒级直接恢复到中断前的执行现场。这两项特性结合,使得MicroVM既能以接近容器的启动速度响应突发请求,又能提供接近传统虚拟机的强隔离保证,天然契合多租户Agent运行时"每个会话互不干扰"的安全要求。
把每个Agent会话当作托管的后端Worker
作者构建的方案是一套无侵入性(un-opinionated)的Agent Runtime API,底层由开源的Pi harness与MicroVM驱动。它的核心理念是:每个Agent会话都是一个被托管的、Serverless的后端Worker。
工作流程被设计得极为轻量——不需要自定义SDK,不需要维持长连接的WebSocket。只要你的服务器能发出HTTP请求并读取SSE流,就能把Agent当作后台Worker来调度:
# 1. 接入你的LLM凭证(Grok via xAI / OpenAI兼容端点 / Anthropic等)
POST /v1/model-credentials {"key": "xai-..."}
# 凭证经过信封加密,在沙箱内执行 env | grep -i key 什么也拿不到

# 2. 启动Agent后端会话——毫秒级返回
POST /v1/sessions {"agent": {"model": "grok-3"}}

# 3. 向Agent派发任务
POST /v1/sessions/{id}/events

# 4. 随时流式读取事件或获取产物
GET /v1/sessions/{id}/events   # SSE,可恢复
GET /v1/sessions/{id}/artifacts
关键点在于第二步:你触发Agent后,HTTP请求在毫秒内返回,而Agent则在隔离沙箱中安全地继续运行,无论任务耗时多久。
三个面向生产环境的架构细节
会话生命周期独立于请求
这是整个设计的灵魂。API handler立即返回,沙箱却持续运行。资源调度上采用了分级策略:
- 闲置5分钟:计算资源自动暂停以节省成本;
- 闲置2小时:工作区被快照(snapshot),计算资源被回收;
- 即时重建:任何新的HTTP请求或对预览URL的访问,都能瞬间从快照恢复MicroVM状态。
这套机制让长时间运行的Agent既不浪费资源,又能随时唤醒,兼顾了成本与响应性。
远程工具执行与Human-in-the-Loop
当Agent需要主后端执行特权操作(如数据库写入)或请求人工审批时,会话会转入 requires_action 状态并暂停——而不必维持一个同步的HTTP长连接。你可以在几分钟甚至几小时后再作答,会话随后无缝续接。这对需要人工介入或权限校验的生产流程尤为实用。
Human-in-the-Loop(HITL,人工介入循环)是指在自动化流程中设置检查点,由人类在特定决策节点进行审核或干预后再让流程继续推进。在Agent场景下,这类检查点尤为重要——当Agent需要执行不可逆操作(如发送邮件、写入生产数据库、调用付费API)或置信度较低时,暂停等待人工确认可以有效防止自动化失控。传统同步HTTP架构下实现HITL代价极高,通常需要维持长轮询或WebSocket连接,一旦超时则整个流程中断。而会话与请求解耦的设计天然支持异步HITL:Agent挂起后释放所有计算资源,审批动作可以延迟数小时,恢复时从精确的中断点继续,这与人工审批流程的不确定时延完美匹配。
严格的BYOK与硬件隔离
方案主打零模型加价、零厂商锁定。你接入自己的Grok、Anthropic或OpenAI凭证(BYOK,Bring Your Own Key),凭证在组织侧信封加密。每个Agent运行在独立的硬件隔离MicroVM中,一个Agent崩溃绝不会波及其他会话。
BYOK(Bring Your Own Key,自带密钥)是一种安全架构模式,指用户将自己持有的API密钥或加密密钥带入第三方服务,而非使用服务商统一管理的共享凭证。信封加密(Envelope Encryption)是其常见实现方式:用数据加密密钥(DEK)加密实际凭证,再用密钥加密密钥(KEK)加密DEK,KEK由用户侧或独立KMS托管。在Agent运行时场景中,BYOK意味着即使基础设施提供商被攻破,攻击者也无法获取你的LLM API密钥;同时也意味着用量计费直接发生在你与模型厂商之间,运行时提供商无法对模型调用加价或进行流量劫持,从架构上消除了厂商锁定风险。
坦诚面对的当前限制
难得的是,作者在推介之余如实列出了现阶段的短板,而非一味夸大:
- 仅提供API:没有官方Web UI、CLI或IDE扩展,纯粹面向后端开发者设计;
- 快照约束:快照跳过 node_modules 与 .git(上限300MB),冷恢复时依赖需从lockfile重新安装;
- 仅支持BYOK:不提供全局模型目录或默认密钥。
这些限制清晰地界定了它的适用边界——它不是给终端用户玩的产品,而是给要把Agent嵌入真实产品的工程团队用的基础设施层。
一个值得关注的信号
抛开这个具体项目本身(作者目前处于寻找Alpha测试者阶段,提供免费执行额度、更高并发和一对一集成支持),它反映出一个更宏观的趋势:AI Agent的落地瓶颈正在从模型能力转向执行基础设施。
当模型已经足够聪明,能跑10分钟、20分钟完成复杂多步任务时,传统为无状态短请求设计的Serverless范式就显得力不从心。MicroVM快照、会话与请求解耦、异步Human-in-the-Loop这些设计模式,很可能会成为下一代Agent后端基础设施的标准组件。对于正在把Agent能力产品化的开发者来说,这类运行时的成熟度,或将直接决定产品能否规模化交付。
相关推荐
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。

mcp.so 实用指南:一站式发现MCP服务器扩展AI编程能力
mcp.so 是一个发现 MCP 服务器的目录平台,帮助 AI 编程开发者为智能体连接外部工具和服务。本文介绍它的功能、使用方法以及对 AI 工作流的价值。

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。