AI Agent的秘密:ReAct框架如何让LLM自主行动

AI Agent 靠 ReAct 循环——推理、行动、观察——实现自我纠错与自主完成任务。
文章解释了 Cursor、Devin、Claude Code 等 AI 编程工具为何能自主写代码、跑命令、修 Bug:核心在于 ReAct 框架,即推理(Reason)、行动(Act)、观察(Observe)三个步骤的持续循环。模型先判断下一步动作,通过工具调用在终端执行命令,再读取输出与报错并重新输入模型,触发下一轮推理,直到任务完成。文中以「创建 React 应用」为例,展示遇到 node 未安装的报错后 AI 如何自行调整方案重试。文章还指出 Agent 与传统对话式 AI 的三大差异:工具调用能力、环境反馈闭环和自主循环控制,并强调 MCP 协议作为执行层基础设施的关键作用,同时提醒长循环带来的 token 成本与误判风险。
为什么AI Agent能自己写代码、修Bug?
Cursor、Devin、Claude Code 这些工具正在重新定义编程体验:它们不只生成代码片段,还能运行终端命令、读取报错信息、自行修复问题。很多人困惑——LLM 本质上只是预测下一个 token 的模型,它凭什么能完成这一连串动作?
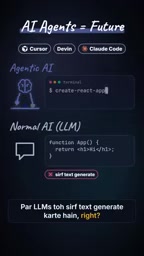
据 YouTube 科技频道的分析,答案藏在一个名为 ReAct(Reason + Act) 的框架里。普通 AI 只做一次「猜测」,而 Agentic AI 则在一个持续的循环中运转。
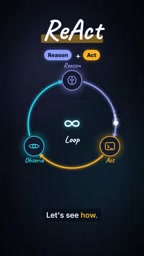
ReAct 框架:推理、行动、观察的无限循环
ReAct 的核心可以拆成三个交替进行的步骤:
- Reason(推理):根据当前目标和已知信息,判断下一步该做什么。
- Act(行动):通过工具调用(如 MCP 协议)在终端中执行具体命令。
- Observe(观察):读取执行结果,包括输出内容和错误信息。
关键在于,观察结果会重新输入给模型,触发下一轮推理。这个循环会一直持续,直到任务完成或达到终止条件。
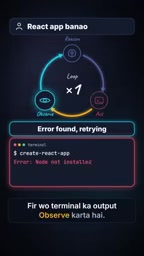
一个具体例子:搭建 React 应用
假设用户下达指令「帮我创建一个 React 应用」。第一轮推理中,AI 判断需要运行 create-react-app 命令;随后它通过 MCP 在终端执行该命令;观察阶段发现报错「node not installed」。
循环没有中断,而是回到推理环节:AI 意识到需要先安装 Node.js,于是发起新的行动。正是这种「失败→反思→重试」的机制,让普通 LLM 蜕变为能处理复杂任务的 Agent。
ReAct 最早由 Shunyu Yao 等人在 2022 年的论文《ReAct: Synergizing Reasoning and Acting in Language Models》中提出,最初用于问答与事实核查任务。其核心洞察是:让模型在生成答案前显式输出「思考」(thought),并据此决定调用哪个工具(action),再把工具返回的文本(observation)拼回上下文继续生成。与更早的「思维链」(Chain-of-Thought)只做内部推理不同,ReAct 把外部环境的真实反馈纳入推理链条,因此能纠正模型仅凭参数知识产生的臆断。今天 Cursor、Claude Code 等产品中的「工具调用循环」,本质上都是 ReAct 范式的工程化延伸。
Agent 与传统对话式 AI 的本质差异
普通对话式 AI 的交互是单次的:输入问题,输出答案。如果答案有误,需要用户自己发现并重新提问。
Agentic AI 把「纠错权」交给了模型自身。它拥有三个传统对话缺少的要素:
- 工具调用能力:能操作终端、文件系统、浏览器等外部环境
- 环境反馈闭环:每次行动的结果都会成为下一轮决策的输入
- 自主循环控制:无需人工介入即可持续迭代
这使得 Agent 可以处理多步骤、强依赖环境状态的任务,例如调试依赖冲突、运行测试并修复失败用例。
工具调用层:MCP 的角色
视频中特别提到 MCP(Model Context Protocol)作为 Agent 与终端之间的桥梁。LLM 本身没有执行能力,它只能输出文本。MCP 这类协议把模型的「意图」翻译成实际的命令调用,再把执行结果结构化地返回给模型。
这一层是 Agent 能力落地的关键基础设施。没有它,ReAct 循环中的「Act」和「Observe」都无从谈起。
MCP(Model Context Protocol)由 Anthropic 于 2024 年底提出并开源,旨在为模型与外部数据源、工具之间提供统一的接口标准。在 MCP 之前,每个 Agent 产品都要为接入文件系统、数据库或命令行单独编写适配代码,工具生态彼此割裂;MCP 用「服务器—客户端」结构把工具能力抽象成可发现、可复用的服务,模型只需按协议描述请求即可调用。它常被类比为「AI 应用的 USB-C 接口」。需要区分的是,MCP 负责「怎么连」,而函数调用(function calling)负责「怎么表达调用意图」,两者配合才能完成 ReAct 循环中的 Act 与 Observe。
局限与边界
ReAct 并非万能。循环的每一步都依赖模型对观察结果的正确解读,一旦模型误判错误原因,可能在错误的路径上反复尝试。此外,长循环会消耗大量 token,成本和延迟随之上升。对开发者而言,理解这一机制有助于更好地设计提示词和工具接口,而不是把 Agent 当成黑盒。
从工程视角看,长循环还面临上下文窗口的硬约束:每一轮的推理、命令输出和错误堆栈都会追加进对话历史,几轮之后上下文可能被填满,模型不得不丢弃早期信息或触发压缩摘要,导致对目标的记忆衰减。常见缓解手段包括把冗长日志写入文件、只在上下文中保留摘要、设置最大迭代轮数与超时,以及在关键步骤引入人工确认。这些设计决定了 Agent 在真实项目中的稳定性上限。
核心要点
- AI Agent 的秘密在于 ReAct 框架:推理、行动、观察的持续循环
- 普通 LLM 只做单次生成,Agent 通过环境反馈实现自我纠错
- MCP 等工具调用协议是 Agent 执行终端命令的基础设施
- 错误信息是循环的燃料,而非终止信号
- 理解 ReAct 有助于更有效地使用和调试 Cursor、Devin 等工具
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。