AI Agent的Tool是什么?一文看懂Claude工具调用机制

Tool是Claude被允许请求调用的外部小程序,由用户环境执行并回传文本结果,构成AI Agent从对话走向行动的桥梁。
文章拆解了Claude工具调用机制的核心:Tool是Claude被允许请求调用的小型程序,由名称、功能描述和输入参数三要素构成。关键点在于Claude从不自己执行工具——它只发出请求,由拥有该工具的宿主程序在用户电脑上执行,再将结果以文本形式返回给Claude,由其读取并决定下一步。这种“请求→执行→读取→决策”的循环,正是AI Agent多步推理能力的基础。文章强调,Claude对用户账户的所有操作都必须经过Tool这一中间层,从而形成可控、可审计、安全边界清晰的操作架构,这也是理解MCP协议、工具生态与Agent安全争论的底层逻辑。
AI Agent的Tool是什么?一文看懂Claude工具调用机制
当你使用Claude这样的AI助手时,它看起来什么都能做——查数据、写代码、分析文件。但你可能不知道,Claude本身并不直接执行任何操作。它背后有一个关键机制在运转:Tool(工具)。
这个概念是理解AI Agent(智能体)工作原理的核心。本文基于一段技术科普视频的内容,拆解Tool的定义、运行流程和它在AI Agent体系中的角色。
什么是Tool?一个精确定义
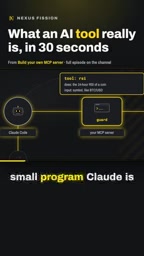
Tool是一个Claude被允许请求调用的小型程序。它有三个基本要素:
- 名称:标识这个工具的身份
- 功能描述:一句话说明它能做什么
- 输入参数:它需要接收哪些信息才能工作
这个定义的关键词是"被允许请求"。工具不是Claude自身的能力,而是外部提供给它的可调用资源。你可以把它理解为一份菜单——Claude看到菜单上有哪些选项,然后决定点什么。至于厨房怎么做菜,跟Claude无关。
Function Calling(函数调用) 是让这个定义得以落地的底层技术机制。大语言模型本身只能输出文本,无法直接触发外部程序。Function Calling 的做法是:在向模型发送请求时,同时附带一份工具清单(通常以 JSON Schema 描述每个工具的名称、用途和参数结构)。模型在生成回复时,可以选择输出一段结构化的调用指令,而非普通文本。上层程序解析这段指令,执行对应函数,再把结果作为新一轮对话内容送回模型。Claude 的 Tool 机制正是这一范式的具体实现。理解 Function Calling 有助于把握一个关键点:所谓“模型调用工具”,本质上是模型生成了一段被约定格式的文本,真正的执行永远发生在外部的宿主程序中。
Claude如何调用Tool?执行流程拆解
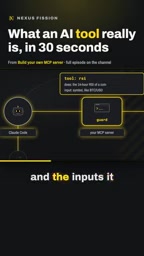
很多人误以为Claude会自己运行工具。事实恰恰相反:Claude从不自己执行任何工具。
整个流程是这样的:
- Claude判断需要某个工具,发出请求(比如"运行Bitcoin的RSI指标")
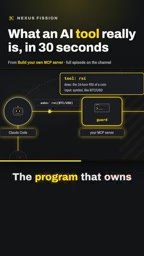
- 拥有该工具的程序在你的电脑上、用你的代码完成实际工作
- 执行结果以文本形式返回给Claude
- Claude读取返回结果,决定下一步做什么
这个设计有一个重要含义:计算发生在你的环境中,Claude只负责决策和解读。这也解释了为什么调用工具时可能消耗你的本地资源。
文中提到的“在你的电脑上、用你的代码”执行,涉及一个常被忽略的架构概念:客户端-服务器分离。Claude 模型运行在 Anthropic 的服务器上,而工具的执行环境是调用方——可能是你本地的开发机、一台云服务器,或是某个集成平台的后端。两者之间通过网络传输消息:客户端把对话历史和工具定义发给模型,模型返回调用请求,客户端执行后再把结果发回。这意味着工具的算力消耗、数据访问权限和网络开销都由客户端承担,模型服务商只负责推理。这一分离也决定了安全责任的划分:授予工具多大权限、工具能读写哪些数据,取决于客户端如何定义,而非模型本身。
结果回传与下一步决策
工具执行完毕后,返回的结果必须是Claude能读取的文本格式。这一点看似简单,实则决定了整个系统的运转逻辑。
Claude拿到文本结果后,会基于这个结果决定下一步动作——可能是继续调用另一个工具,可能是给出最终回答,也可能是修正之前的判断。这种"请求→执行→读取→决策"的循环,就是AI Agent具备多步推理能力的基础。
有意思的是,Claude对返回结果的处理能力,直接决定了Agent的任务完成质量。如果返回的数据格式混乱或信息不完整,Claude的后续决策也会受到影响。
一切操作都通过Tool完成
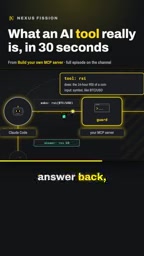
视频中有一句话值得重视:Claude对你的账户所做的每一件事,都是通过这样的工具完成的。
这句话揭示了一个安全边界。Claude不会绕过工具直接触碰你的账户、文件或系统。每个操作都必须经过工具这个中间层——而工具是你(或你使用的平台)定义和授权的。
从工程角度看,这种架构带来了几个好处:
- 可控性:你能精确知道Claude被允许做什么
- 可审计:每次工具调用都有记录可查
- 安全性:未定义工具的操作无法执行
文中提到的 MCP(Model Context Protocol,模型上下文协议) 是理解工具生态演进的关键背景。在 MCP 出现之前,每接入一个新工具,开发者往往需要针对特定平台编写适配代码,工具难以在不同应用间复用。MCP 由 Anthropic 提出并开源,它定义了一套标准化的通信规范,让工具提供方只需实现一次服务端,就能被任何支持 MCP 的客户端(如 Claude Desktop、各类 IDE 插件)调用。可以把它类比为“AI 工具的 USB-C 接口”:统一了插头形状,设备和外设才能自由组合。MCP 让工具的发现、授权和调用有了通用层,也使“Claude 能请求哪些工具”从写死的清单,变成可动态扩展的生态。
为什么这个概念重要?
理解了Tool的机制,你就能明白当前AI Agent领域很多讨论的底层逻辑。无论是MCP协议的兴起、各家平台的工具生态建设,还是Agent安全性的争论,本质上都在围绕"Claude能请求哪些工具、这些工具如何执行、结果如何回传"这三个问题展开。
Tool不只是一个技术细节,它是AI从"对话"走向"行动"的桥梁。没有工具,Claude只能生成文字;有了工具,它才能查数据、调API、操作软件——真正成为一个Agent。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。