AI Agent工程化实战:从Demo到可维护产品的完整路径

拆解Agent项目从能跑的Demo到可长期维护产品的工程化全流程与关键原则。
文章基于一套完整视频项目案例,系统梳理Agent项目工程化的关键环节。开篇强调先定义任务边界与成功标准,避免万能Agent失控;随后介绍项目规范,如agents.md说明书与密钥安全管理;架构上区分Workflow负责确定性流程、Agent负责不确定判断,并拆解agents、tools、skills等目录职责。Agent定义需写清Role、Goal、Instructions、Tools、Output Schema五要素;Tools是能力、Skills是可复用方法,二者不可混淆;Context管当前任务、Memory只保留长期有价值信息;Prompt应结构化拆分并纳入版本管理。文章特别强调Test保证代码能跑、Eval判断任务做得好不好,上线后需通过Trace和监控形成运行—记录—评估—修改的迭代闭环。
很多开发者已经能调用模型、写Prompt、挂几个Tool,做出能跑起来的Agent Demo,但一旦进入真实项目,就卡在目录怎么拆、模块怎么分、什么时候用Workflow什么时候用Agent。B站UP主在近期的一期教程中,用一套完整的视频项目案例,串起了从需求定义到部署监控的全流程。本文基于该教程的核心框架,结合工程实践视角,拆解一个Agent项目从“能跑”到“能长期维护”之间真正差的东西。
先定义任务,再设计Agent
教程开篇就强调:第一步不是写代码,而是搞清楚Agent到底要解决什么问题。很多人一开始就想做万能Agent——能搜索、能写文章、能分析数据、还能做PPT。听起来很强,但这种项目最容易失控,因为它没有清晰的任务边界。
项目开始前至少写清五件事:目标是什么、用户会給什么输入、最终输出什么、哪些事情Agent可以自己决定、什么情况才算任务成功。以AI科普视频Agent为例:用户输入选题,它先搜索资料,再核对官网文档和新闻判断可靠性,然后整理观点、生成口播稿、输出分镜。同时要加边界——自动搜索和整理可以,但发布内容、删除文件或调用会产生费用的服务,必须让用户确认。
目标一旦模糊,后面的Tool、Skill、Memory都会越加越多,最后你自己都不知道系统为什么需要它们。
项目规范:让Agent看懂你的规则
目标确定后,创建项目、配置Git和环境变量是基础。教程特别建议加一个agents.md文件,把它理解成写给AI开发者看的项目说明书:目录怎么组织、代码放在哪里、哪些文件不能乱改、新增功能后必须跑什么测试、能不能自动安装新依赖、Git提交前要检查什么。这样以后让Agent改项目时,它不需要每次都重新猜你的规则。
安全方面,API Key不要写进源码,真实密钥放进.env,同时保留.env.example让别人知道需要哪些环境变量但看不到真实Key,.env必须加入.gitignore。这一步看起来不像Agent本身,但它决定了项目以后会不会越改越乱。
架构设计:Workflow与Agent各司其职
一个准备长期维护的Agent项目,至少区分这些目录:agents、tools、skills、workflows、prompts、context、memory、tests和evals。
最容易被忽略的是Workflow和Agent的区别。Workflow管的是事情按什么顺序执行,Agent负责的是遇到不确定问题时怎么判断。在视频项目里,Research Agent负责查资料,Script Agent负责写口播,Storyboard Agent负责分镜。如果Research没找到足够可靠的来源,是继续搜索还是直接进入写稿?如果Script连续两次没通过Eval,是重新生成还是退回Research补资料?这些属于Workflow的编排逻辑。
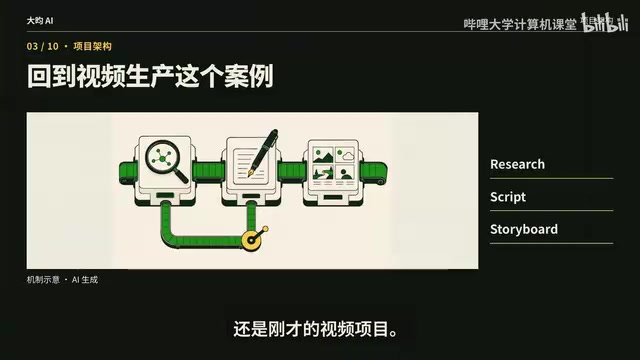
教程给出的原则很明确:确定性的流程交给Workflow,需要判断的部分再交给Agent。这样以后新增或替换某一个Agent,不会把整条任务链一起推倒重来。架构不是把目录拆得越细越专业,每个目录都应该对应真实职责,项目小时可以先简单,等任务链变复杂再独立模块。真正要避免的是所有业务逻辑堆在一个Agent文件里。
Agent定义五要素:Role、Goal、Instructions、Tools、Output Schema
定义Agent时建议写清五项:Role(角色)、Goal(目标)、Instructions(指令)、Tools(工具)、Output Schema(输出结构)。
以Research Agent为例:Role是AI技术研究员,Goal是获取可靠资料,Instructions写清楚优先官网和一手来源、遇到冲突信息要标记、不确定的信息不能当成事实,Tools可以给网页搜索、网页读取、GitHub搜索,Output Schema固定成核心结论、关键事实来源、争议信息、待确认项。
Output Schema为什么重要?因为后面通常还有Script Agent继续处理结果。如果Research Agent每次都自由输出一大段文字,有时先讲结论有时先贴链接有时把不确定信息混在正文里,下一层就很难稳定解析。很多Agent项目变稳定,不一定是因为换了更强的模型,而是因为Agent的边界更清楚、输入输出更规范。
Tools与Skills:别把能力和方法混为一谈
Tool是Agent的手和脚,搜索网页、读写文件、查询数据库、计算、调用接口都属于Tools。一个重要原则是:一个Tool尽量只做一件明确的事。不要做一个“do_everything”工具,既能搜索又能写文件还能调数据库——Agent在选择Tool时本身就要理解每个工具的用途,工具越复杂、描述越难写,调用错误的概率也越高。
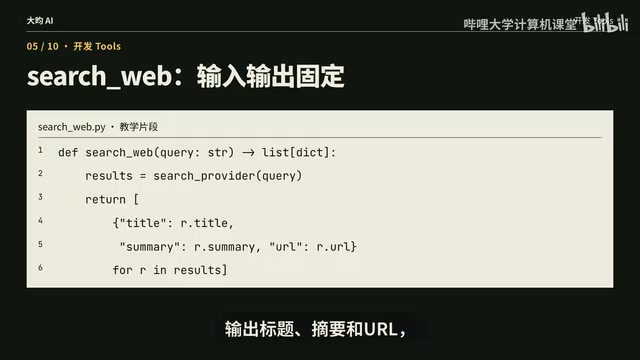
Tool最好有清楚的输入输出,比如search_web输入query,输出标题、摘要和URL,而不是返回一堆格式不稳定的自然语言。每个Tool都应该能单独测试,这样Agent出问题时可以先确认到底是Tool坏了还是Agent选错了Tool。
Skills则常被和Tools混在一起。可以直接记一句:Tool是能力,Skill是完成任务的方法。搜索网页是Tool,读取网页是Tool,保存文件也是Tool,但“调研一个新的AI产品”可以是一个Skill——它固定了一套成熟流程:先搜索,再找官方文档和GitHub,补充新闻和社区讨论,读取多个来源核对冲突信息,最后整理成研究报告。Tool解决“我能不能做这件事”,Skill解决“这件事应该怎么做得更稳定”。项目真正开始积累能力以后,积累的不应该只有越来越多的Tool,真正有复用价值的是越来越多经过验证的Skills。
Context与Memory:先解决当前任务需要知道什么
很多人一做Agent就觉得必须有长期记忆、必须上向量数据库。教程的观点是:不一定。一个Agent项目首先要解决的是这一次任务它到底需要知道什么——当前用户给的选题、Research Agent刚找到的资料、Tool返回的数据、Script Agent已经写过的版本、当前Workflow执行到哪一步,这些都属于Context。
然后再判断任务结束后哪些信息真的值得继续保留:用户长期喜欢什么文案风格、哪些选题已经做过、某个项目有哪些固定规则,这些才可能进入Memory。某一次搜索返回的临时网页、已失效的中间结果、一次性错误信息,没有必要长期保存。Context和Memory最好分开设计,项目早期用JSON、SQLite或普通文件就够了,真正出现大量跨任务检索需求以后再考虑向量数据库。不是记得越多Agent就越聪明,记住了错误的东西反而会让后面的任务越来越难纠正。
Prompt结构化管理:别把所有规则塞进一个System Prompt
真实项目里不建议把所有规则塞进一个巨大的System Prompt。可以拆成System、Task、Constraints、Examples和Output Schema:System负责角色和长期规则,Task负责当前任务,Constraints明确哪些事情不能做,Examples告诉模型什么样的结果才算好,Output Schema固定最终输出结构。
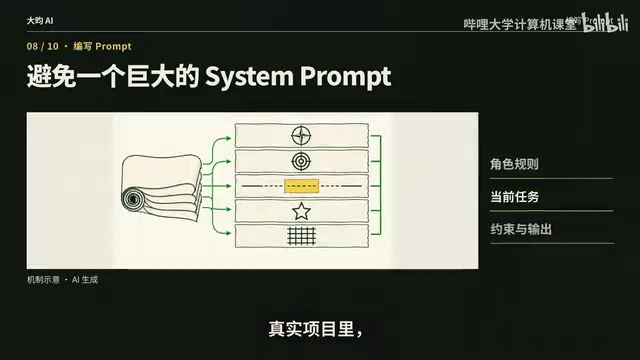
这样以后修改某一部分时才知道到底改了什么,也更容易测试是哪条规则影响了结果。比如发现Research Agent总把未经确认的信息写成事实,就应该优先修改Constraints,而不是把整个Prompt全部重写。Prompt也应该进入版本管理,因为它本质上不是聊天时随手写的一段话,而是Agent的一部分程序逻辑。
Test与Eval:代码正常不代表任务做得好
这是Agent Demo和真正项目最大的分水岭之一。传统软件会做Test:函数能不能运行、接口有没有报错、Tool能不能返回正确数据,这些当然都要测。但Agent有一个特殊问题:代码正常不代表任务做得好。
Research Agent成功生成了一篇2000字报告,没有报错,所有函数测试也通过,但里面可能引用了过时信息,甚至把推测写成了事实。从程序角度看它成功了,从业务角度看它其实失败了。所以除了Test还需要Eval:准备一批固定的真实任务,专门评估事实准确率、幻觉、Tool选择、任务完成率、输出结构、成本和速度。
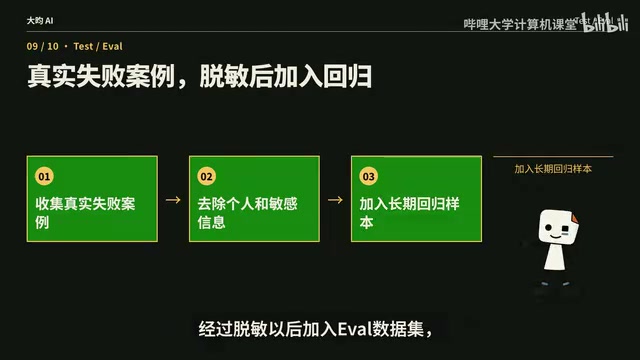
教程举例:准备50个真实选题作为固定输入,每次更换模型、修改Prompt、增加Skill以后都重新跑一遍。如果Prompt A的任务成功率是82%,Prompt B提升到91%,同时平均成本还下降了,那你才能比较确定这次修改是真的变好了。否则“我感觉它聪明了一点”没有任何工程意义。Eval测试集最好固定下来并进入版本管理,甚至可以把线上真正失败过的案例脱敏后加入Eval数据集。一句话:能不能运行看Test,做得好不好看Eval。
Eval(评估)与Test(测试)在工程语境下常被混用,但二者面向的问题不同。Test属于传统软件工程范畴,验证的是确定性逻辑——给定输入是否返回预期输出、边界条件是否处理、异常是否被捕获,结果通常是二元的通过或失败。Eval则源自模型评估实践,针对的是概率性、开放式输出,无法用简单的断言判断对错,因此需要引入评分标准(rubric)、参考答案比对或模型裁判(LLM-as-Judge)等手段,产出准确率、完成率等统计指标。在Agent项目中,Eval数据集通常是一组固定的任务输入及对应的判分规则,每次变更模型、Prompt或工具后重跑,观察指标是否提升。Eval的价值在于把“感觉变好了”转化为可比较的量化结论,但也需注意其局限:评分标准本身可能有偏差,模型裁判可能倾向于某些输出风格,因此Eval结果应结合人工抽检使用,而非完全替代人的判断。
部署与可观测性:上线不是结束,是迭代的开始
项目可以运行在本地、Docker或云环境,但上线以后还有一层非常重要:Observability(可观测性)。至少应该知道用户给了什么任务、Workflow走到了哪里、Agent做了什么选择、调用了哪个Tool、Tool的输入和返回是什么、最终输出是什么,同时记录Token、耗时、成本、错误率和任务成功率。
Agent不是传统的确定性程序,同一个任务因为模型、上下文或Tool状态不同都可能得到不一样的结果。比如用户说结果错了,你打开Trace以后发现Agent的判断其实没问题,是搜索Tool返回了一个过时网页,那你应该修Tool或数据源,而不是继续改Prompt。没有Trace Log和Eval,很容易每次出问题都去改Prompt,结果越改越乱。
Trace(调用链追踪)是可观测性的核心载体。在传统分布式系统中,Trace用于记录一次请求经过的各服务节点及耗时,用于定位性能瓶颈。而在Agent场景中,Trace记录的是更细粒度的决策过程:用户输入、Workflow的每一步流转、Agent在哪个节点做出了何种判断、调用了哪个Tool、Tool的入参与返回、最终输出,以及整个链路的Token消耗、耗时和成本。典型的Trace数据结构是树状或嵌套的Span——顶层是一次任务,子节点是各阶段和工具调用,每个Span携带时间戳、状态和元数据。有了这样的记录,排查问题时可以快速区分是模型判断失误、Tool返回了错误数据,还是Workflow编排逻辑有缺口。业界常见的实现方式包括OpenTelemetry标准及其在LLM应用中的扩展,以及各类Agent开发框架内置的Trace面板。没有Trace,Agent的失败原因几乎不可复现,迭代只能靠猜测。
一套可复用的Agent工程框架
把整个流程串起来:先定义需求和成功标准,再建立项目规范和架构;Workflow管流程,Agent管判断;Tools提供基础能力,Skills提供经过验证的方法;Context管当前任务,Memory保存真正值得长期留下的信息;Prompt约束行为,Test保证代码能运行,Eval判断Agent到底做得好不好;最后通过部署、Trace和监控持续优化。
当这一套真正建立起来以后,你的Agent才会从一个能跑起来的Demo,慢慢变成一个可维护、可扩展、可以真正交给别人使用的产品。Agent工程真正要解决的问题,不是怎么让模型调用一次工具,而是怎么让一个不确定的AI长期稳定地完成确定的业务任务。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。

Commodore 64经典赛车游戏迎来Driver AI
探索Commodore 64经典赛车游戏《Stunt Car Racer》中的Driver AI实验,了解在资源受限的8位平台上实现自动驾驶AI的技术挑战与启示。

黄仁勋若被替换,开源AI会否生变?Reddit激辩
Reddit网友激辩:如果黄仁勋被替换,英伟达会反对开源AI吗?讨论指出英伟达支持开源AI源于商业利益,需拓宽GPU客户群,而非一人决策。