AI Agent工具调用安全防护:本地运行时拦截方案Aegotrax

Aegotrax是一款开源工具,在AI Agent调用工具前拦截并校验操作合法性,以防提示注入引发不可逆危害。
随着AI Agent能够自主调用HTTP、邮件、数据库等真实工具,提示注入攻击的危险从"输出错误"升级为"执行不可逆操作"。开源项目Aegotrax将防线设在工具执行的临界点而非模型输入输出层,在每次工具调用前校验意图、数据来源与策略规则,并返回ALLOW/BLOCK裁决及审计日志。技术上,它基于FastAPI构建风险引擎,提供Python SDK装饰器接入方式,并可选接入MCP网关,支持Docker与pip部署。项目作者态度诚实,明确将其定位为启发式的本地沙盒探索工具而非企业级产品,并公开征集攻破测试。在Agent运行时安全标准化方案尚缺的当下,Aegotrax提供了一个可拆解、可验证的工程起点。
AI Agent的真正风险:工具调用那一刻
随着AI Agent的普及,一个被低估的安全隐患逐渐浮出水面:真正的破坏往往发生在Agent调用工具的那一刻——无论是发起HTTP请求、发送邮件、操作数据库还是读写文件。
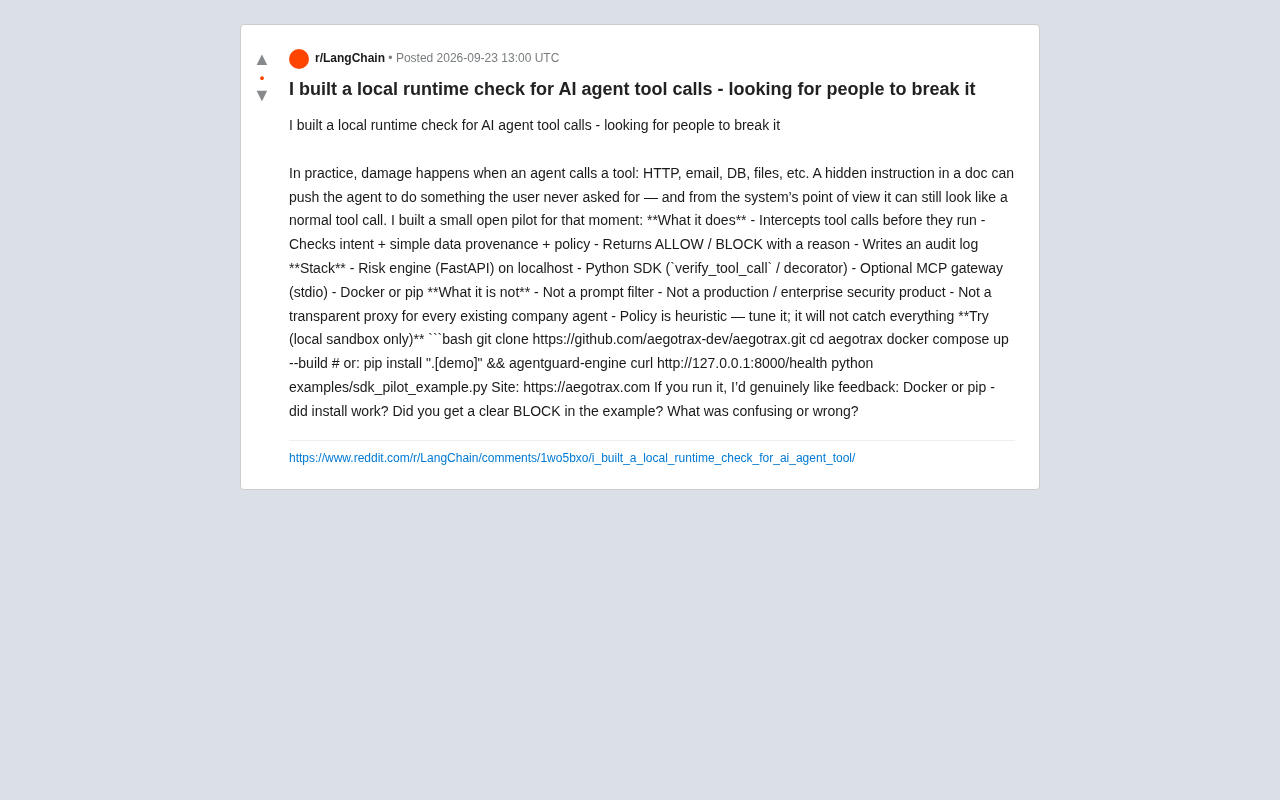
一位开发者在Reddit上分享了他的开源项目Aegotrax,直指这个问题的核心。他指出,一段藏在文档中的隐藏指令,就可能诱导Agent执行用户从未要求的操作,而从系统视角来看,这依然像是一次再普通不过的工具调用。这正是提示注入(Prompt Injection)攻击最危险的落点——它绕过了用户的意图,却披着合法操作的外衣。
提示注入(Prompt Injection) 是指攻击者将恶意指令嵌入Agent会读取的外部内容中——例如网页、文档、邮件正文或数据库返回值——从而劫持Agent的行为意图。与传统SQL注入针对数据库解析器不同,提示注入利用的是大语言模型"无法区分指令来源"的根本特性:模型同等对待系统提示、用户输入和外部数据中的文字,攻击者因此能伪造出看似合法的操作请求。当Agent具备调用真实工具的能力时,这一漏洞的危害从"输出错误信息"升级为"执行不可逆操作",危险程度质变。目前学术界和工程界尚无公认的完整解决方案,防御策略主要集中在输入净化、权限最小化和运行时拦截三个方向。
Aegotrax做了什么
与常见的提示词过滤方案不同,Aegotrax把防线设在了工具执行的临界点,而非模型的输入输出层。它的工作逻辑清晰而克制:
- 拦截工具调用:在工具真正执行之前进行截获
- 多维度校验:检查调用意图(intent)、简单的数据来源追溯(data provenance)以及策略规则(policy)
- 给出明确裁决:返回 ALLOW 或 BLOCK,并附带判断理由
- 写入审计日志:为每次决策留下可追溯的记录
这种设计的价值在于,它把安全判断从「模型是否被骗」的模糊地带,转移到了「这个操作是否该被放行」的可执行环节。即便Agent已经被恶意指令误导,最后一道工具调用的关卡仍有机会阻断危险行为。
数据来源追溯(Data Provenance) 在Agent安全场景中,指追踪某个工具调用参数"从何而来"的能力——是来自用户的直接输入、系统提示,还是Agent在执行过程中读取的某段外部文档。这一能力的意义在于:同样是"发送邮件到某地址"的调用,若收件人地址来自用户明确指定,与来自Agent刚刚抓取的一个网页内容,其风险等级截然不同。完整的数据来源追溯在工程上颇具挑战,需要在整个推理链路中维护参数的"污点标记"。Aegotrax目前实现的是"简单的"数据来源追溯,作者本人也在项目中坦承这一能力尚不完整,更多依赖策略规则和意图启发式判断来弥补。
技术栈与集成方式
Aegotrax在工程实现上保持了轻量和本地化的特点,整体运行在localhost环境中:
- 风险引擎:基于FastAPI构建
- Python SDK:提供
verify_tool_call方法及装饰器(decorator)两种接入方式 - 可选的MCP网关:通过stdio通信,适配Model Context Protocol生态
- 部署灵活:支持Docker Compose一键启动,或通过pip安装
对开发者而言,装饰器模式意味着可以用极少的改动,为现有的工具函数套上一层运行时防护,而无需重构整个Agent架构。
MCP(Model Context Protocol) 是由Anthropic主导推动的一项开放协议,旨在为AI模型与外部工具、数据源之间的交互提供标准化接口。其核心思想是将"工具能力"抽象为可发现、可调用的服务端点,让不同的Agent框架和模型提供商能够复用同一套工具生态,而无需为每个组合单独适配。MCP采用基于JSON-RPC的消息格式,支持stdio(标准输入输出)和HTTP SSE两种传输方式——前者适合本地进程间通信,后者适合网络服务场景。Aegotrax提供的可选MCP网关,意味着它可以作为一个中间代理层接入任何兼容MCP的Agent运行时,在工具调用到达真实执行端之前完成安全校验,而无需修改上游的Agent逻辑。
作者划清的边界
值得肯定的是,项目作者对Aegotrax的定位相当诚实,明确列出了它「不是什么」:
- 它不是提示词过滤器
- 它不是生产级或企业级安全产品
- 它不是能透明代理所有现有企业Agent的方案
- 它的策略是启发式的,需要自行调优,且无法覆盖所有攻击场景
这种坦诚在开源社区中尤为可贵。作者没有夸大其防护能力,而是把它定位为一个「开放试点」(open pilot),并公开征集能够攻破它的用户——这本身就是一种健康的安全验证态度。
如何本地试用
项目强调仅在本地沙盒环境中运行。开发者可以通过以下方式快速体验:
git clone https://github.com/aegotrax-dev/aegotrax.git
cd aegotrax
docker compose up --build
# 或者: pip install ".[demo]" && agentguard-engine
curl http://127.0.0.1:8000/health
python examples/sdk_pilot_example.py
作者特别希望收到几类反馈:Docker或pip的安装流程是否顺畅、示例中是否能得到清晰的BLOCK结果、以及哪些地方让人困惑或存在错误。
一点思考
随着MCP等协议推动Agent工具生态快速扩张,「Agent安全」正从理论讨论走向工程实践。Aegotrax代表了一个务实的方向:与其试图让模型永远不被欺骗,不如在每次高风险操作前加一道可审计、可解释的守门人。
当然,启发式策略的局限也很明显——它可能误伤正常调用,也可能被精心构造的攻击绕过。但对于当下缺乏标准化Agent运行时安全方案的现状而言,这类开源探索为社区提供了可以动手拆解、验证和改进的起点。
相关推荐

谷歌AMIE临床研究登上《柳叶刀》:AI问诊首次真实诊所验证
谷歌与BIDMC合作的AMIE对话式诊断AI研究登上《柳叶刀》主刊,首次在真实诊所前瞻性验证。鉴别诊断与医生吻合率达90%,75%病例帮助医生准备问诊,开创患者端AI问诊临床落地新路径。

自然语言 vs SQL:AI 驱动数据可视化的变革
探讨 AI 驱动的数据分析如何用自然语言替代传统 SQL 进行数据可视化,分析两种方式的优势、局限与融合趋势,以及对企业数据团队角色的影响。

NVIDIA Megatron Core实现位级确定性预训练解析
NVIDIA Megatron Core引入位级确定性预训练能力,让大规模模型训练在调试、验证与恢复中实现逐位可复现。本文解析位级确定性的原理、技术挑战及其对AI工程实践的意义。