AI Agent工具调用循环机制详解
AI Agent本质是工具调用循环,可靠性来自外部工程约束而非模型自觉。
文章将AI Agent还原为一个简洁的工程结构:从用户请求与预设工具清单开始,模型判断是否需要调用工具,输出结构化的tool call意图,由应用代码通过MCP转发到外部服务执行,结果回填上下文后模型再次判断,如此循环直至给出最终回复。模型自身不执行任何操作,能力边界完全由工具清单划定。针对动钱类高风险工具,循环会暂停等待人工审批,使自主性与风险等级挂钩。维持安全的两道护栏是最大步数限制与审批门,它们都不依赖模型自我克制。文章强调,Agent的智能来自模型,可靠性则来自循环之外的工程约束,工具设计、上下文管理与审批点位置是核心工程决策。
AI Agent(智能体)常被描述为“能自主完成任务的AI”,但它的核心机制其实异常简洁:一个不断重复的工具调用循环。理解这个循环,也就理解了Agent为什么能查数据库、调API、甚至发起退款——以及为什么它需要被“看住”。
循环的起点:用户请求与工具清单
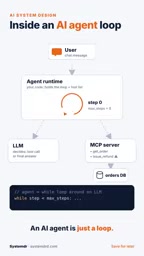
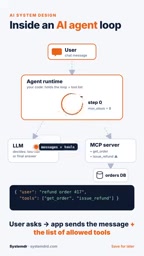
一切从一条用户消息开始。比如用户说“退款订单417”。应用并不直接把这句话丢给模型就完事,而是同时附上一份“模型被允许使用的工具列表”。这是Agent设计中的第一个关键决策:模型的能力边界由这份清单预先划定,它不能凭空发明工具。
据YouTube原视频的拆解,此时模型不会直接回答。它看到的是“可以调用哪些工具”的说明,于是优先判断是否需要动用工具来获取更多信息。这种“先行动、后作答”的倾向,正是Agent与普通聊天机器人的分水岭。
工具调用:模型出主意,代码干活
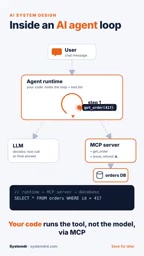
模型的第一反应是一个tool call:调用get_order工具,参数是订单ID。这里有一个常被误解的细节——模型自己并不执行任何操作。它只是输出一个结构化的调用意图,真正跑工具的是你写的代码。
代码通过MCP(Model Context Protocol)把这次调用转发到一个服务器,服务器再去读订单数据库。MCP在这里扮演的是标准化的“接线员”角色,让模型与外部系统之间的通信有章可循,而不必为每个数据源写一套私有胶水代码。
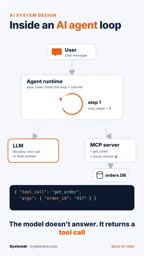
工具返回的结果会被追加到对话上下文中。模型拿到订单信息后,重新做一次判断:是再调一个工具,还是现在可以回答了。这个“判断—调用—回填—再判断”的节奏,就是循环的本体。
tool call(工具调用) 是模型输出的结构化数据,通常遵循特定格式(如 OpenAI 的 function_call 或 Anthropic 的 tool_use 块),包含工具名与 JSON 参数。它本质上是一种特殊的“文本补全”——模型并非在运行程序,而是在预测“应该调用哪个工具、传什么参数”。正因为如此,应用层必须解析这段输出、校验参数合法性,再自行执行。模型对工具的实际行为、返回值甚至是否存在都一无所知,只能依赖工具清单中的描述文字来推断用途。这也解释了为什么工具描述写得越精确,模型选错工具的概率越低;同时也意味着恶意或模糊的描述可能诱导模型发起危险调用,工具清单本身就是一个需要审慎设计的攻击面。
MCP(Model Context Protocol) 是 Anthropic 于 2024 年底提出的开放协议,用于标准化模型应用与外部数据源、工具之间的连接方式。它采用客户端—服务器架构:Agent 应用作为客户端,通过 JSON-RPC 与一个个 MCP 服务器通信,每个服务器暴露一组工具、资源或提示模板。在 Agent 循环中,MCP 的价值在于把“工具如何被发现、如何被调用、结果如何返回”抽象成统一接口,使同一个工具能被不同模型和框架复用,而不必为每个数据源重写集成代码。它常被类比为“AI 应用的 USB-C 接口”。需要注意的是,MCP 只解决连接标准化,不负责权限与审批,安全闸门仍需在应用层实现。
风险工具与审批闸门
订单信息到手后,模型决定调用issue_refund。与只读的查询不同,这个工具会真正动钱。因此循环在此处暂停,等待人工审批。批准之后退款才执行,模型再基于执行结果撰写最终回复。
这个暂停点揭示了一个务实的设计哲学:Agent的自主性应当与操作的风险等级挂钩。查询类工具可以放手让它跑,资金类、删除类、对外发送类工具则需要闸门。
human-in-the-loop(人在回路) 是 Agent 系统中把人类判断嵌入自动化流程的设计模式。在工具调用循环里,它通常实现为一个拦截层:当模型请求调用被标记为高风险的工具时,运行时暂停循环,把工具名、参数和模型意图呈现给人工,等待批准、修改或拒绝后再决定是否执行。工程上常见的做法是给工具清单中的每一项附加风险元数据(只读/写入/资金/对外通信),由策略引擎而非模型来决定哪些调用需要拦截。这种模式的关键在于审批发生在执行之前,且审批结果作为新的上下文回填给模型,使模型能基于“被拒绝”这一事实调整后续行为,而不是盲目重试。
两道护栏:步数上限与审批门
原视频点明了维持Agent安全的两道护栏。其一是最大步数限制,防止模型陷入无限调用循环——现实中模型可能反复调用同一工具而不收敛,步数上限是最后一道保险。其二是审批门,即上文所述针对高风险工具的确认机制。
这两道护栏的共同点在于:它们都不依赖模型“自觉”。Agent的可靠性来自外部约束,而非提示词里的叮嘱。把安全性寄托在模型自我克制上,是当前工程实践中常见的误区。
这个循环模型为何重要
把Agent还原为一个循环,带来了几个直接的工程启示。工具清单的设计等价于能力设计,多给一个工具就多一分风险面;上下文的管理至关重要,因为每一轮工具结果都会挤占窗口;审批点的位置决定了人机协作的分工界面。
原视频在结尾预告了续篇,主题是Agent如何跨会话记忆。这恰好是上述循环模型的下一个延伸问题:当循环结束、会话关闭,Agent积累的上下文如何留存?这将是另一个层面的设计挑战。
对开发者而言,理解这个循环的价值不在于记住步骤,而在于意识到:Agent的“智能”来自模型,但Agent的“可靠”来自循环之外的工程约束。
相关推荐
AI Agent技能全指南:用Markdown打造稳健智能体
Google开发专家详解AI Agent技能机制:用Markdown文件固化重复指令与领域约定,通过技能创建器生成、评估对比验证、持续迭代,让Claude Code等智能体在正确时机加载正确上下文,打造稳健可靠的智能体工作流。
AI逆向工程新工具REA:让Claude克隆任意App
REA(Reverse Engineer Anything)是GitHub趋势榜第一的AI逆向工程工具,能让Claude Code等编程代理拆解任意App,复现功能,但也会触发安全拦截。本文详解其能力、限制与伦理边界。
如何为AI代理提供有效上下文?从简单开始,建立单一事实源
探索如何为AI代理提供有效上下文:从简单Markdown文件起步,逐步建立中央事实源,并在规模化时引入专业厂商。了解多代理协作中的上下文管理策略。