AI Agent管控实战:MCP服务器的防护栏演示
通过MCP Proxy防护栏,从工具可见性、字段脱敏和请求限额三方面管控AI Agent调用MCP工具。
文章通过一个示例工作区演示了如何为调用MCP Tools的AI Agent配置防护栏。核心是在Agent与MCP服务器之间建立MCP Proxy Guardrail代理层,从三个维度实施控制:工具权限上,只开启必要工具且禁用工具对Agent完全不可见;数据管控上,支持字段级拒绝与掩码,如对assignee邮箱脱敏;行为强度上,可设置请求限额并采用从Warn到Block的渐进式响应。此外,每个Agent拥有独立角色、ID和可关闭的delegation能力,用于身份归因与权限收敛。三个维度共同构成纵深防御,为Agent接入生产系统提供了可复用的配置思路。
当AI Agent开始调用MCP工具时,如何确保它不会越权访问敏感数据、不会无限度地发起请求?一个产品演示给出了具体的操作路径。
演示工作区与防护栏创建
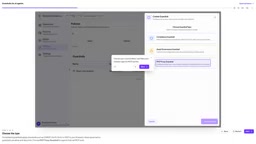
这次演示运行在一个名为Acme Demo Corp.的示例工作区中,全部使用测试数据,避免触碰真实业务信息。操作从Policies和Guardrails菜单进入,点击Guardrail即可新增一条防护规则。
对于需要调用MCP Tools的Agent,选择MCP Proxy Guardrail类型。这个类型专门针对通过MCP协议调用外部工具的Agent设计,相当于在Agent与工具之间加了一层代理层,所有工具调用都要先经过这道关卡。
MCP(Model Context Protocol)是 Anthropic 于 2024 年底提出的一种开放协议,用于标准化 AI 模型与外部工具、数据源之间的连接方式。在传统集成中,每个工具都需要自定义适配代码;MCP 则定义了一套统一的客户端—服务器交互规范,Agent 作为客户端通过 MCP 服务器发现并调用工具。正因如此,MCP Proxy Guardrail 的代理层位置很关键:它位于 Agent 与 MCP 服务器之间,能统一看到所有工具调用请求与返回数据,而不必侵入每个 MCP 服务器的实现内部。这种架构使策略可以在协议层面集中执行,也是本文防护栏能同时覆盖工具、数据与频率三个维度的技术前提。
三组控制维度:工具、数据与频率
防护栏的可配置项围绕三个核心问题展开:Agent能用什么、能看什么、能用到什么程度。
工具权限:按需开放,禁用即隐身
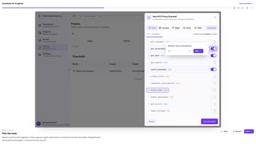
在角色设置环节,只需打开该Agent真正需要的工具开关,其余保持关闭。演示中特别强调了一个设计细节:被禁用的工具对Agent完全不可见。
这比简单的“拒绝调用”更彻底。如果Agent根本不知道某个工具存在,它就不会在推理过程中尝试绕过限制,也不会因为反复失败而浪费token或产生异常行为。这种“默认不可见”的思路,把攻击面从被动拦截前移到了主动隐藏。
列级数据管控:字段拒绝与掩码
在Columns设置中,可以针对具体字段执行脱敏。演示里的例子是否决某个字段,并对assignee的邮箱做掩码处理。这意味着即便Agent有权调用某个工具,它拿到的数据也已经过裁剪——邮箱不会以明文形式进入Agent的上下文,也就不会被写进日志、缓存或后续的推理链条中。
对于涉及客户信息、内部工单、人员数据的场景,字段级的控制粒度比整表拒绝更实用,能在保留工具可用性的同时把敏感信息隔离在外。
字段掩码(masking)与字段拒绝(denial)是两种不同强度的数据管控手段。拒绝是让该字段完全不出现在工具返回结果中,适用于绝不希望 Agent 接触的敏感字段;掩码则是保留字段结构但替换其内容,例如将邮箱替换为 u***@example.com,使 Agent 仍能识别字段存在与格式,却无法获取真实值。掩码的常见策略包括全掩码、部分掩码、哈希替换和令牌化,选择取决于下游任务是否需要保留可关联性。在 Agent 场景中,掩码尤其重要,因为模型上下文、日志与缓存都可能长期留存数据,一旦明文进入就难以彻底清除。
请求限额与渐进式响应
在Limits设置中,可以限制请求数量,并配置从Warn到Block的渐进式响应策略,最后保存生效。
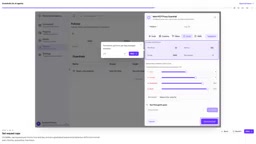
渐进式响应比一刀切的封禁更有操作性。当Agent接近阈值时先收到警告,给它调整行为的机会;继续越线才触发阻断。这种设计对生产环境里的自动化流程更友好,减少因瞬时流量波动导致的任务中断,同时保留了硬性上限作为兜底。
保存后,新防护栏立即处于活跃状态,与已有的其他防护栏并列生效。
Agent身份与委托管理
除了防护栏本身,演示还进入Settings下的Agents页面。在这里,每个Agent都被分配一个角色和一个ID,并且可以单独关闭它的delegation(委托)能力。
这一点值得注意:防护栏限制的是Agent用MCP Tools做什么,而Agent身份体系解决的是“你是谁、你能代表谁”的问题。每个Agent拥有可管理的独立身份,意味着审计日志可以精确归因到具体Agent,权限回收也有明确的落点。当多个Agent协作或存在委托链时,关闭某个Agent的委托能力就能切断一条潜在的权限扩散路径。
delegation(委托)指的是一个 Agent 在获得授权后,代替另一个主体(用户或其他 Agent)发起操作的能力。在多 Agent 协作链路中,委托可以让权限沿链条传递,例如 Agent A 委托 Agent B 调用某工具,B 实际上继承了 A 的部分权限。这种机制提升了自动化效率,但也带来权限扩散风险:一旦某个下游 Agent 被诱导或出现异常,攻击者可能借委托链获得远超预期的访问范围。因此,能够按 Agent 单独关闭 delegation,相当于在身份层面切断一条传播路径,与防护栏在行为层面的限制形成互补。
这套机制的设计逻辑
从演示可以看出,这套防护体系把控制点放在了Agent与MCP服务器之间的代理层,而不是分散在各个工具内部。集中式管控的好处是策略一致、配置统一,不用为每个工具单独写限制逻辑。
三个维度的组合也形成了纵深防御:工具可见性控制入口,字段掩码控制数据流出,请求限额控制行为强度。任何单一维度被绕过,其他维度仍然提供约束。
对正在把Agent接入生产系统的团队来说,这种“先定义身份、再划定权限、最后设好上限”的配置顺序,本身就是一个可复用的落地思路。
相关推荐

Last Week Tonight深扒:政客与白人至上主义的危险纽带
Last Week Tonight调查佐治亚州参议员候选人Mike Collins与佛罗里达州候选人Marshall Rawson,揭露他们与白人至上主义者的多重关联,以及共和党内的沉默反应。
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。