AI Agent后台任务机制:慢操作不阻塞,开发效率翻倍

通过后台线程和通知队列让AI Agent在等待慢命令时继续推理工作
文章指出AI Agent在执行耗时命令(如npm install、Docker构建)时会同步阻塞,浪费时间和上下文窗口。解决方案是借鉴现实并行模式,将慢命令放入后台守护线程执行,主线程继续推理规划,后台结果通过通知队列在下次模型调用前统一注入,从而提升Agent循环效率。
问题:Agent为什么会"发呆"
你见过厨师预热烤箱时停下手什么都不干吗?当然不会。但我们的AI Agent在等待安装依赖的时候,就是这么干的——傻等。
这是Agent开发中一个被严重低估的效率瓶颈。要理解为什么,需要先了解AI Agent的核心运行机制:一个「感知-推理-行动」的循环(ReAct Loop)。每次迭代都需要调用大语言模型进行推理,然后执行工具调用,再将结果反馈给模型。这个循环的效率直接决定了Agent完成任务的速度和成本。当循环中出现同步阻塞时,整个系统进入等待状态——不仅浪费了墙钟时间,还可能因为上下文窗口被无意义的等待状态填充而影响后续推理质量。
看看典型的时间线:Agent发出npm install命令,然后等着。五分钟过去了,模型什么都不干。构建Docker镜像也是,跑测试也是,任何超过一分钟的命令都会让整个Agent循环卡死。
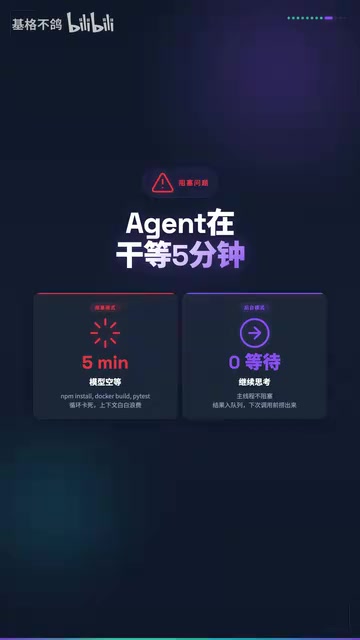
这不仅是浪费时间,更是在浪费模型宝贵的上下文窗口。主流模型的上下文窗口从32K到200K token不等,每次调用的费用与输入token数量正相关。在Agent循环中,随着对话历史的积累,每次调用的成本会线性增长。当模型在等待IO操作完成时,它的推理能力完全被闲置,而token计费却可能仍在累积——这是一笔双重损失的账。
解决方案:主线程继续思考,后台线程跑慢命令
解决思路其实很直观——借鉴现实世界的并行处理模式。厨师把东西放进烤箱后,会继续准备下一道菜的食材。Agent也应该如此:发出慢命令后,不等待,直接继续规划下一步。
并行时间线设计
想象两条平行的时间线:
- 主线程:Agent持续进行推理、规划、执行快速操作
- 后台线程:慢命令(安装依赖、构建镜像、跑测试)在后台静默执行
后台跑完了,结果进入队列。下次调用大模型之前,把队列里的结果全部捞出来,喂给模型。

核心机制:通知队列如何工作
整个方案的核心可以用三个字概括:通知队列。
在深入实现之前,有必要理解两个关键的技术选择。
为什么用守护线程(Daemon Thread)? 守护线程是操作系统和编程语言中的重要概念:当主程序退出时,守护线程会自动终止,无需显式清理。Python的threading模块通过设置daemon=True来创建守护线程,这对后台任务管理非常理想——不会因为忘记清理而导致进程僵死,Agent崩溃时后台任务也会随之终止,不留僵尸进程。
为什么用Queue而不是asyncio? 在Python中处理并发有三种主要范式:多线程(threading)、多进程(multiprocessing)和异步IO(asyncio)。对于等待子进程完成这类IO密集型任务,线程切换的开销远小于收益,多线程是合适的选择。asyncio虽然更现代,但需要整个调用链都支持async/await,改造成本极高。Python标准库的Queue内部使用锁和条件变量保证并发安全,是生产者-消费者模式的标准实现,用在这里恰到好处。
后台管理器用守护线程跑命令,结果放进通知队列。每次调用大模型之前,执行"排空
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。