AI Agent开发四阶段学习路线:从入门到实战全解析

为什么Agent开发成为大模型领域的核心?
如果你还停留在做基础RAG(检索增强生成)或简单的API调用,那么在当下的AI岗位竞争中恐怕已经落后了。RAG是2020年前后兴起的技术范式,通过在生成回答前先从外部知识库检索相关文档,解决了大语言模型「知识截止日期」和「幻觉」问题。然而RAG本质上仍是「问答管道」,缺乏主动规划和多步骤执行能力。随着GPT-4、Claude等模型推理能力大幅提升,业界逐步意识到,真正释放LLM潜力的关键在于赋予其「代理行动」的能力——这正是Agent范式崛起的技术背景。
AI岗位需求早已完成升级——只会调用大模型接口、拼接Prompt的能力已经不再稀缺,真正构成核心竞争力的,是能够独立设计和开发**智能Agent(智能体)**的能力。
所谓Agent,与普通AI应用最大的区别在于其自主性。它不是被动地接收指令、返回结果,而是能够自主规划任务、主动调用工具,并形成闭环去解决复杂问题。打个比方:普通AI应用像是一个只会回答问题的助手,而Agent则像一个能理解目标、拆解步骤、自己动手完成整个流程的员工。
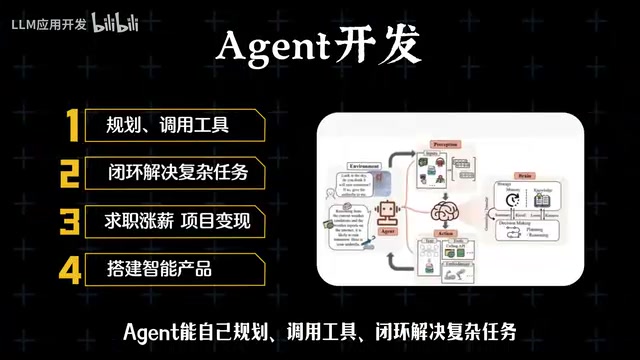
无论是求职跳槽、接项目变现,还是搭建智能产品,AI Agent开发都已成为绕不开的硬核技能。越早系统性地掌握,越能在这波技术浪潮中占据先机。下面按照完整的四阶段学习路线,逐一梳理从入门到实战落地的全过程。
第一阶段:基础入门,吃透核心概念
学习Agent开发的第一步,不是急着写代码,而是把地基打牢。这一阶段的重点在于理解Agent的本质与核心理论架构。
首先要搞清楚Agent究竟是什么,以及它由哪些核心组件构成。一个完整的AI Agent通常包含以下关键模块:
- 规划模块(Planning):负责将复杂任务拆解为可执行的子步骤。工程上通常基于LLM的指令跟随能力实现,代表方案包括Tree of Thoughts(思维树)和HuggingGPT等;
- 记忆模块(Memory):让Agent能够记住上下文、历史交互和中间结果。在工程实现上分为短期记忆(上下文窗口内的对话历史)和长期记忆(向量数据库存储的历史摘要),Mem0、Zep等工具专门解决这一问题;
- 工具调用(Tool Use):赋予Agent调用外部工具、API或函数的能力。通常依赖OpenAI Function Calling或各框架的Tool接口,让模型能结构化地调用搜索引擎、代码执行器、数据库等外部系统。
三者协同,构成Agent完整的认知-行动循环。

话说回来,还需要熟悉大语言模型(LLM)的基本工作原理,因为LLM正是驱动Agent进行推理和决策的核心大脑。只有把这些基础概念理清,后续学习原理和实战时才不会一头雾水。这一阶段看似枯燥,却是决定你能走多远的关键所在。
第二阶段:核心进阶,掌握原理与设计范式
打好基础之后,就要从「懂概念」升级到「懂原理」。这一阶段的目标是深入理解Agent的动作机制,并掌握业界经典的Agent设计范式。
最具代表性的当属 ReAct 范式。ReAct(Reasoning + Acting)由谷歌研究院于2022年提出,论文《ReAct: Synergizing Reasoning and Acting in Language Models》发表于ICLR 2023。其核心创新在于将「思维链推理」与「外部工具调用」交织进行:模型先输出 Thought(内心推理),再输出 Action(调用工具),最后接收 Observation(工具返回结果),三步循环直至任务完成。实验证明,ReAct相比纯推理或纯行动方案,在多跳问答和交互式任务上准确率提升显著,是目前LangChain、AutoGPT等主流框架的底层逻辑之一。
ReAct 将「推理(Reasoning)」和「行动(Acting)」结合起来,让Agent在执行任务时先进行思考推理,再决定下一步动作,然后根据环境反馈持续调整——形成「思考 → 行动 → 观察」的完整循环。这种范式极大提升了Agent应对复杂任务的能力。
除此之外,还有 Chain-of-Thought(思维链)、Plan-and-Execute 等经典方法论。理解这些范式的差异和适用场景,能帮助你在实际开发中选择最合适的架构。
这一阶段还会集中处理开发中的常见难点:如何设计有效的反馈循环、如何避免Agent陷入死循环、如何控制调用成本等。真正理解Agent的核心运行逻辑,才算入门Agent开发。
第三阶段:强化提升,优化Agent输出效果
当你能够搭建出可运行的Agent后,接下来要解决的是「跑得好不好」的问题。这一阶段聚焦于效果优化,涵盖三个重要方向。
强化学习
引入强化学习(Reinforcement Learning)思路,让Agent在与环境的持续交互中优化决策策略,从而在特定任务上表现得更加稳定、更加智能。
值得关注的是,将RL引入LLM Agent优化已成为学术界和工业界的热点方向。RLHF(基于人类反馈的强化学习)已被OpenAI用于GPT系列模型的对齐训练;在Agent层面,PPO、GRPO等算法被用于优化工具选择策略和多步骤决策质量。近期DeepSeek广告-R1等模型通过纯RL训练展现出显著的推理能力提升,进一步验证了RL在Agent智能化方向的潜力。对于应用开发者而言,理解RL的奖励机制设计,有助于构建能够自我改进的Agent系统。
多智能体协作
单个Agent的能力终归有限,多智能体(Multi-Agent)协作则能应对更复杂的场景。多智能体系统(MAS)在AI领域并非新概念,早在1990年代的分布式AI研究中就已出现,但结合LLM后获得了质的飞跃:每个Agent都拥有自然语言理解与生成能力,使得Agent间的通信协议从结构化消息变为自然语言对话。目前主流框架包括微软开源的AutoGen、斯坦福的MetaGPT(模拟软件公司角色分工),以及CrewAI等。工程上需要重点解决任务分配策略、消息传递机制、冲突仲裁,以及避免多Agent间形成死锁状态。
理解多个Agent如何分工配合、互相通信、协调决策,是进阶开发者的必备能力。例如:一个Agent负责规划,一个负责执行,一个负责审核校验,三者配合完成整体目标。
Prompt调优
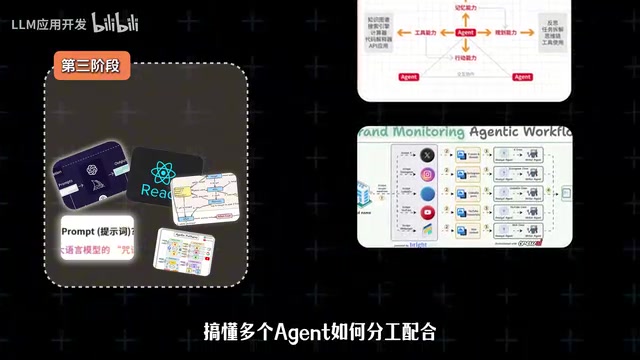
Prompt的质量直接决定Agent的输出精度。通过系统性的Prompt调优技巧,可以让Agent更准确地理解意图、更精准地输出目标结果,从而大幅提升实用性。这是一项看似简单、实则需要大量实践积累的核心软技能。
第四阶段:实战落地,对接真实业务场景
理论学得再多,最终都要落到实处。第四阶段的核心是将前面所有知识串联起来,亲手完成2至3个完整的实战项目。
推荐的实战项目方向包括:
- 智能决策助手:能够分析信息、给出建议并辅助决策;
- 自动化办公Agent:自动处理邮件、日程、文档等重复性工作;
- 多智能体协作系统:综合运用协作逻辑,构建复杂的任务处理流水线。
关键在于要完整跑通开发、调试、优化的全流程,把抽象的理论知识转化为可展示的硬成果。这些实战项目不仅能验证技术能力,也能成为简历上极具分量的加分项,直接提升求职和接项目的竞争力。
写在最后:如何看待这条学习路线
从整体来看,这条四阶段路线——基础概念 → 原理范式 → 效果优化 → 实战落地——遵循了从理论到实践的合理递进逻辑,对初学者具有较强的指导意义。
需要说明的是,「七天从小白到大神」之类的说法更多是营销话术。AI Agent开发涉及大模型原理、工程实现、系统设计等多个维度,真正的精通需要长期的项目积累与持续学习。但确实,Agent是当前大模型应用领域最值得深入投入的方向之一。与其焦虑,不如沿着清晰的路线一步步扎实推进,把每个阶段的能力真正内化,才能在AI浪潮中占据主动。
核心要点
相关推荐
用生活场景看懂竞态条件:从咖啡机到银行取款的并发难题
通过咖啡机、买牛奶、银行取款、三向环岛等生活化例子,深入浅出讲解竞态条件、死锁、活锁、幂等性与锁机制等并发编程核心概念,帮你建立对并发问题的直觉理解。
亚马逊Alexa平板上手:NanoMAT屏幕叫板iPad Pro?
亚马逊推出全新Alexa平板系列,起售价499美元,升级铝合金机身并运行完整Android。重点体验NanoMAT抗眩光屏幕,对比iPad Pro的Nano Texture屏幕,解析其是否构成威胁。
5个比问ChatGPT更好用的CSS生成器工具
介绍5个比问ChatGPT更高效的CSS生成器工具:Mesher网格渐变、Fuel的SVG纹理、Temani Afif的CSSGenerators、Easing Wizard缓动曲线和Dice Bear头像生成,快速搞定难写的CSS效果。