AI Agent权限失控?独立授权层拦截数据库变更

AI Agent执行前必须由独立授权服务决策,实现执行与授权分离。
文章探讨了AI Agent操作生产系统时的授权问题,指出工具访问权限不等于任务授权。作者使用LangGraph、SQLite和开源治理平台BHANUJ-AIGP搭建实验,核心思路是将执行与授权彻底分离:LangGraph负责工作流与工具调用,AIGP独立做出授权决策,SQLite仅存数据。实验通过Keycloak认证两个服务身份,引入委托授权机制,确保Agent运行时不能自我授权。验证表明,授权服务返回ALLOW才执行写入,DENY则停止;授权服务宕机时采用fail-closed设计阻止写入。执行证据通过causation_id关联工具调用与授权决策,但非不可篡改证明。作者最后提出工程之问:授权应放在框架内、工具边界还是独立策略服务,以及如何证明未授权动作无法绕过。
AI Agent正从回答问题走向操作生产系统:查数据库、改记录、调API、协调跨应用工作流。能力越强,一个根本问题越难回避——Agent理解了请求,就意味着有权执行吗?
一篇来自开发者社区的实验文章给出了明确的否定答案,并用LangGraph、SQLite与开源治理平台BHANUJ-AIGP搭建了一套可运行的验证方案。核心思路只有一句话:把执行与授权彻底分开。
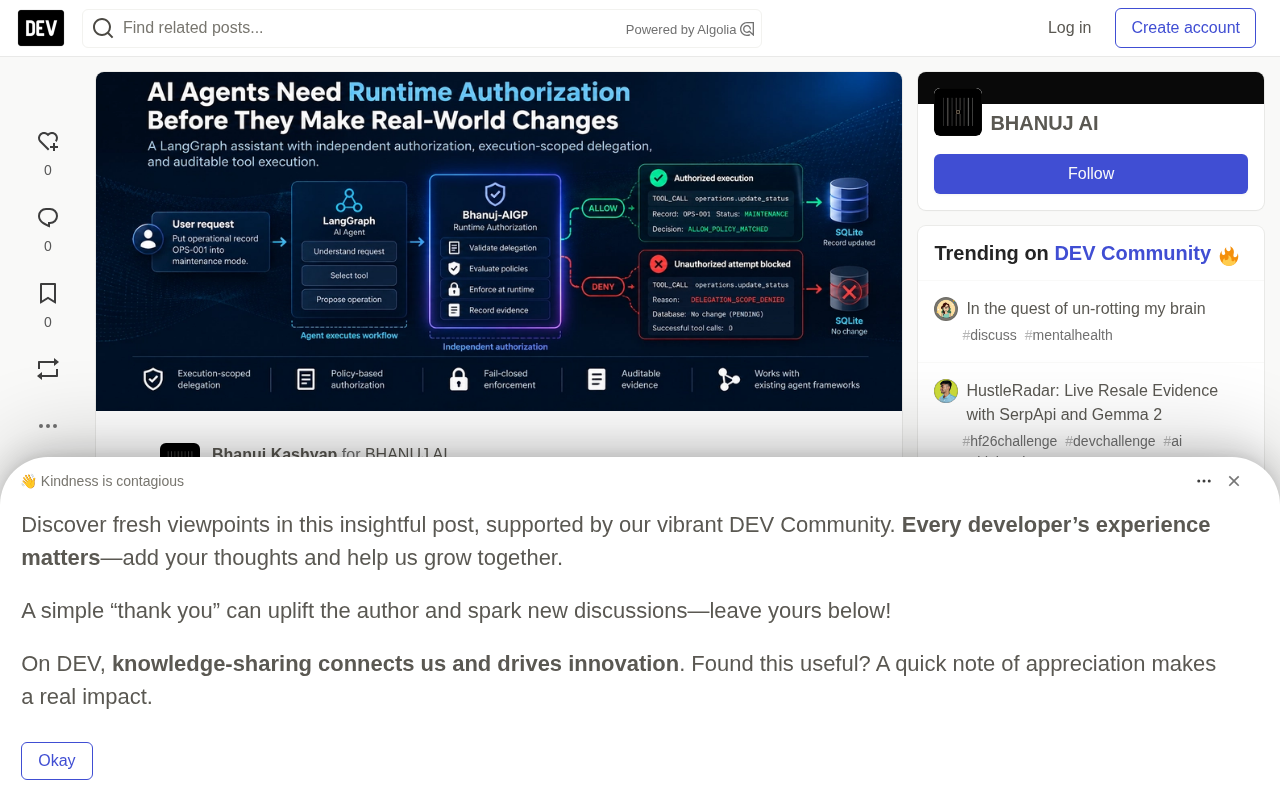
问题:工具访问权限不等于任务授权
设想一个运维助手,具备两项能力:operations.read_status(查看记录)和operations.update_status(修改记录)。当它收到"将OPS-001置为维护模式"的指令时,技术上完全知道该调用哪个工具。
但一连串授权问题悬而未决:这次操作是谁授权的?授权是否只针对这条记录?权限是否仍然有效?Agent能否把权限挪用到另一次操作?授权服务宕机时会发生什么?事后能否追溯是哪一次决策放行了这次数据库修改?
这些问题与"模型是否选对了工具"分属两个层面。工具选择决定Agent想做什么,授权决定它被允许做什么。 当前多数Agent框架把两者混在一起,安全边界因此变得模糊。
架构:执行归执行,授权归授权
实验刻意保留LangGraph作为工作流引擎,由它负责读取记录、准备变更、在获准后调用工具。BHANUJ-AIGP则独立做出授权决策,并接收执行证据。流程上,Agent提出更新后先经过授权检查,返回ALLOW才写入SQLite,返回DENY则原地停止。
一个关键的架构分工是:AIGP本身不执行数据库操作。LangGraph在调用SQLite之前强制执行返回的授权决定。由此形成三层职责:LangGraph管工作流执行与工具调用,AIGP管策略评估、授权决策与证据管理,SQLite管应用数据与状态。
这套设计的目标不是给Agent框架叠加一套新的治理系统,而是在"AI决策变成真实世界动作"的那个点上,插入一道显式的安全边界。
身份认证不等于被授权
实验中最值得玩味的部分是委托授权机制。运行时可以拥有合法身份,却不代表有权执行每一项操作。实验室用Keycloak认证了两个独立的服务身份:一个是委托签发方,受信任、有权签发范围极窄的委托;另一个是Agent运行时,执行LangGraph工作流,并在执行受保护操作前申请授权。
运行时不能自己给自己授权。执行前,集成应用会建立一个绑定到特定执行、运行时身份、动作、资源和过期时间的委托,授权服务校验并持久化该委托。当运行时随后提出受保护的工具调用时,授权服务独立验证委托与适用策略。这里存在两道彼此独立的控制:签发方是否有权委托该动作,以及运行时的拟议操作是否符合策略与委托范围。
Agent无法通过修改提示词来挑选更宽松的策略或扩大委托范围。一个通过认证的Agent,未必是一个被授权的Agent。
委托授权(Delegated Authorization) 是一种让持有合法身份的主体,代表另一主体(或自身)获取临时、细粒度操作权限的机制。在 OAuth 2.0 框架中,它通常通过 Token Exchange(RFC 8693)或 JWT 授权断言实现:签发方(delegator)基于自身权限,向执行方(delegatee)颁发一个绑定特定动作、资源和有效期的凭证。与静态 API Key 不同,委托授权强调“最小权限”与“上下文绑定”,一旦执行结束或委托过期,权限自动失效。本文实验中,AIGP 正是通过建立委托来约束 Agent 运行时的操作范围,使得身份认证与操作授权保持独立,从而避免 Agent 利用自身身份越权执行。
实验验证:放行与拦截
在允许场景中,SQLite初始记录OPS-001状态为PENDING,Agent提出将状态改为MAINTENANCE。SQLite执行前,运行时向AIGP申请授权。AIGP评估绑定到本次执行的委托与生效策略后予以放行,输出结果为WRITE_COMPLETED、原因为ALLOW_POLICY_MATCHED,数据库状态变为MAINTENANCE,AIGP证据状态为COMPLETED。
反过来,当运行时拿到的委托只允许operations.read_status,却尝试调用operations.update_status时,操作超出委托范围,策略返回DENY与DELEGATION_SCOPE_DENIED。数据库状态保持PENDING,成功工具调用事件为0。
这个拒绝结果是通过运行中的AIGP OSS API实际验证的,而非本地mock模拟。一个有意思的细节是:Agent整体执行仍然可以成功结束,因为它安全地处理了拒绝。这揭示了另一条重要区分——工作流成功完成,不代表工具执行成功或被授权。一个行为良好的助手完全可以报告"该操作未被允许"来完成任务,工作流结果与授权结果必须保持分离。
授权服务宕机时,默认拒绝
安全边界是否有用,取决于它的失效行为是否可预测。当Agent尝试受保护的数据库操作而授权服务超时时,助手是否应该因为请求看起来合理就继续执行?答案是不。
对于受保护操作,该集成采用fail-closed设计:拒绝决定、授权过期、无效响应、操作不匹配或授权服务不可用,都会阻止数据库写入。实验室还针对这些行为提供了确定性的离线故障演练。作者特别说明,离线夹具并不代表真实的AIGP授权决策——aigp场景走权威API,而allowed、denied、outage属于本地教学与测试场景。这个区分在评估一套安全架构能否走出演示环境时至关重要。
执行证据:能追溯,但非不可篡改证明
阻止未授权操作是底线,但运维团队还需要事后理解发生了什么。调查场景通常是:Agent改动了某条记录,这次改动被允许了吗?是哪次执行做的?哪个授权决策在工具调用之前?
实验中AIGP集成记录了一段有边界的执行历史,典型序列为EXECUTION_STARTED、WORKFLOW_STEP、RUNTIME_ACTION_AUTHORIZATION、TOOL_CALL、EXECUTION_COMPLETED。成功的工具调用记录通过causation_id引用对应的授权决策,审查者可以把运行时上报的动作与授权它的决策连接起来。
证据在设计上是隐私受限的:只包含标识符、决策元数据、结果与引用,不存储原始提示词、完整工具载荷、凭证或模型推理过程。作者也坦诚了局限——AIGP接收的是运行时上报的工具结果,它并不独立见证SQLite事务。这提供的是有用的授权溯源与执行证据,而不是对每个底层数据库效果的不可篡改证明。
causation_id 是一种用于建立因果关系链的标识符,常见于分布式追踪(如 OpenTelemetry 的 TraceID/SpanID)和事件溯源系统。在授权场景中,它把一次工具调用事件与触发该调用的授权决策事件关联起来,使审计者能够回溯“哪个决策放行了哪个动作”。与简单的父子关系不同,causation_id 强调因果传递:即使事件跨服务、跨存储,也能通过该 ID 重建决策到执行的路径。然而,causation_id 仅保证逻辑关联,不提供密码学完整性——若运行时恶意伪造该 ID,授权服务无法独立验证。因此,它适用于运维审计和故障排查,但不能替代数字签名或哈希链等不可篡改证明机制。
为什么不把授权全塞进LangGraph
当然可以在LangGraph工作流里写条件检查。问题在于,这些检查是否应该构成权威的安全边界。对于小型孤立实验,本地检查或许够用。但企业系统会引入多框架Agent、共享企业策略、独立的策略管理、显式的委托与撤销、一致的拒绝行为、集中式授权证据以及跨执行的运维可见性等要求。
把权威策略嵌入每个Agent实现,容易造成执行不一致:一个框架执行规则的方式可能与另一个不同,未来的工具集成可能绕过某项检查,策略变更也难以协调。替代方案是把策略决策与框架特定执行分离——每个Agent运行时对接权威授权服务,同时保留在实际工具边界执行该决策的责任。关键要求是运行时不能提供绕过执行的替代路径。如果工具仍能在不经过受保护边界的情况下执行,那么独立的策略服务就形同虚设。
策略决策点(PDP)与策略执行点(PEP) 是授权架构中的经典分离模式,源自 XACML 标准。PDP 负责评估策略并做出允许/拒绝决策,PEP 则负责在资源访问点拦截请求并执行 PDP 的决策。本文中,AIGP 充当 PDP,LangGraph 在调用 SQLite 前充当 PEP。这种分离的核心价值在于:策略集中管理、决策可审计,且执行点无法绕过决策。若将策略逻辑嵌入 LangGraph 内部,则每个 Agent 实现都可能成为独立的 PDP,导致策略碎片化、难以统一撤销和监控。值得注意的是,PEP 必须确保所有对受保护资源的访问都经过 PDP,否则分离架构形同虚设——这正是作者强调“运行时不能提供绕过执行的替代路径”的原因。
实验边界与工程之问
作者明确列出了局限:不引入新的Agent编排系统,不部署应用,不自动修复未授权变更,不保证所有下游业务约束都满足,不提供可重放的SQLite执行或因果重放,证据历史也不是正式密封账本或底层数据库事务的密码学 attestation。工具参数的完整性绑定保护的是授权与拟议操作之间的关系,不能替代应用内部的业务级校验。
实验代码已公开,开发者指南覆盖LangGraph工作流、SQLite集成、身份配置、策略设置、权威授权路径、故障场景与执行证据检查。首个只读检查点无需模型API或付费云服务。
作者最后抛给工程社区的问题值得每个做Agent落地的人思考:AI Agent工具调用的授权,应该放在Agent框架内、工具边界上,还是独立的策略服务里?更重要的是,你如何证明未授权动作无法绕过执行机制?
当Agent开始修改生产系统,安全边界不能只依赖模型"自认为"被允许做什么。模型可以决定下一个动作,但执行该动作的权限,必须来自模型控制之外的受信任系统。
相关推荐

Meta与出版商的AI数据之争:服务条款修改引爆互联网未来之战
Meta修改商业账户服务条款,允许用关联网站数据训练AI模型,引发出版商和创作者强烈反弹。媒体行业组织联名致信扎克伯格,Meta被迫删除"训练"措辞并推迟条款生效。这场争议揭示了AI时代数据授权与互联网未来的深层博弈。

当Outside Xbox遇上血染钟楼:Minecraft里的军团对局
Outside Xbox嘉宾Ellen和Mike做客Minecraft版《血染钟楼》,迎战军团恶魔局。三名好人如何在信息噪音中对抗多数邪恶?本文解析军团机制、信息角色博弈与终局逆转。

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。