AI Agent入门为何这么难?精炼教程的破局思路

为什么AI Agent让新手望而却步
当我们谈起AI Agent(智能体)开发时,很多人脑海中浮现的关键词往往是:门槛高、概念杂、无从下手。这种印象并非空穴来风,而是当下智能体学习生态的真实写照。
AI Agent本质上是一种能够感知环境、自主决策并执行行动的AI系统。与传统的单次问答式AI不同,Agent具备"规划-行动-观察"的循环能力,可以将复杂任务分解为多个步骤,调用外部工具(如搜索引擎、代码执行器、数据库等),并根据中间结果动态调整策略。当前主流的Agent框架包括LangChain、AutoGen、CrewAI等,它们大多基于大语言模型(LLM)的推理能力构建,通过"工具调用(Tool Use)"和"思维链(Chain of Thought)"等技术实现自主任务执行。正是这套复杂的技术栈,让许多新手在还没搞清楚基础概念时,就已经被大量术语淹没。
一方面,越来越多的人向往打造属于自己的AI智能体——一个能够自主规划、调用工具、完成复杂任务的AI程序;但另一方面,他们又迟迟不敢迈出第一步。市面上虽然已有各种收费或免费的Agent教程,但真正能帮新手跨过入门门槛的却寥寥无几。
据这套B站教程的作者分析,现有教程主要存在两类问题:一类是上来就堆砌专业术语,学了几天反而越听越懵;另一类则是内容太冗长细碎,让人没有耐心看完。这两种极端,恰恰是新手学习路上最常见的"劝退陷阱"。
学不会,往往不是知识本身太难
这套教程提出了一个值得深思的观点:我们不理解某个概念,不一定是因为知识本身难,而是没能把它和已知的事情建立联系,或者被过于抽象的技术描述迷惑了。
这其实点出了技术教学的核心痛点。很多教程习惯用API文档式的语言讲解,把Agent的运行逻辑描述得晦涩难懂。对新手来说,真正需要的是一座桥梁——把陌生的新概念与熟悉的认知连接起来。
用真实案例和视觉化降低理解成本
针对这一痛点,该教程的第一个特点是借助真实案例和可视化效果帮助理解。作者希望把智能体的运行逻辑拆解成"能看懂的清晰流程",而不是停留在抽象的文字描述上。
这种做法背后的逻辑是:AI Agent的核心运行逻辑通常遵循ReAct(Reasoning + Acting)范式,即交替进行推理和行动——Agent首先分析任务目标,生成行动计划;然后调用工具执行具体操作;再观察执行结果,判断是否需要调整策略,直到任务完成。这一循环本质上是一套工作流:它如何接收需求、如何思考、如何调用工具、如何输出结果。当这些环节被可视化呈现为清晰的流程图时,新手就能像看流程图一样理解智能体的运转方式,而不必被术语淹没。理解这个底层架构还有一个额外好处:无论使用哪种框架,核心范式是共通的,学会了思维方式,切换工具的成本会大大降低。
精炼,才是入门阶段的关键
这套教程的第二个特点是精炼。整套内容总时长控制在两小时左右,每个视频三到五分钟,专注覆盖AI Agent入门最核心的知识点。
为什么入门阶段不该学"细枝末节"
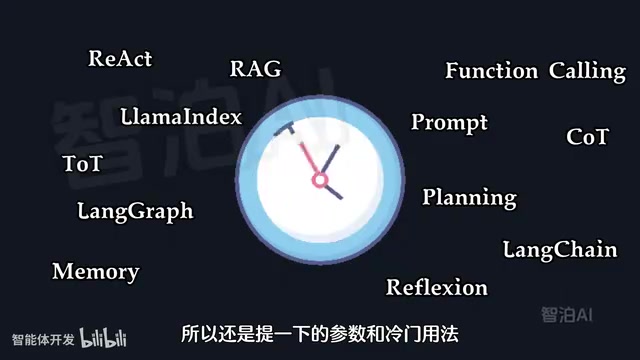
很多教学视频时长偏长,因为它们会讲解大量细节,包括一些并不常用、只是"顺便提一下"的参数和冷门用法。但作者认为,在入门阶段,花时间学习和记忆这些细枝末节反而会分散新手理解核心逻辑的精力,而且这些不常用的知识很容易被遗忘。
这个判断有坚实的认知科学依据。认知负荷理论(Cognitive Load Theory)由澳大利亚教育心理学家John Sweller于1988年提出,核心观点是人类工作记忆容量有限,学习过程中同时处理的信息量超出阈值时,学习效率会显著下降。好的入门课程应优先降低"外在认知负荷"(由信息呈现方式造成的额外负担),让学习者将有限的认知资源集中在"内在认知负荷"(知识本身的复杂度)上。因此,当新手同时被主线逻辑和大量支线细节包围时,往往两头都抓不住。先建立骨架,再填充血肉,才是更符合认知规律的学习路径。
真实开发不需要你成为"记忆大师"
作者还提出了一个务实的观点:真实世界里的Agent开发不是应试考试,不需要把框架细节、API参数全部记在脑子里,因为随时可以查阅技术文档和搜索资料。
有实际开发经验的人最终都会意识到,比记忆更重要的是三项能力:
- 拆解需求的能力
- 设计工作流的能力
- 高效解决问题的能力
掌握核心思维远比成为"参数字典"更有价值。在AI工具日益强大的今天,当搜索引擎和AI助手随手可得,死记硬背的边际价值正在快速下降。
掌握核心逻辑后,学新工具会更快
这套教程的定位很清晰:帮你跨过入门门槛,掌握AI智能体开发的核心思维。它并不试图成为百科全书,而是提供一个"相对轻松的开始"。
作者建议,在完成入门教程之后,学习者可以:
- 找其他更长的教程查漏补缺
- 找真实应用项目边做边学
- 进一步探索多智能体协作等更复杂的开发框架
关于最后一点,多智能体协作(Multi-Agent Collaboration)是AI Agent领域的重要进阶方向,指多个具有不同专长的Agent协同完成复杂任务。典型模式包括:由"协调者Agent"分配子任务给"执行者Agent"的层级架构,以及多Agent平行讨论、相互审核的"辩论"架构。AutoGen、CrewAI、MetaGPT等框架均提供了多智能体编排能力,通过角色分工突破单一Agent的能力边界。但这些进阶概念之所以能快速上手,前提正是对单智能体核心逻辑的深刻理解。
这背后的逻辑同样值得认同:一旦掌握了核心逻辑,再学习新工具和框架的时间会大大缩短。 不同框架之间,底层的Agent设计思想往往是相通的,学会了"如何思考",工具只是实现手段。
写在最后:迈出第一步才是关键
这套教程的思路,本质上反映了一种更成熟的技术学习观:对新手来说,最重要的不是学得多全,而是先把入门的门槛跨过去。
在AI Agent这个快速演进的领域,框架和工具几乎每隔几个月就会更新迭代。与其追逐永远学不完的细节,不如先建立起对智能体运行逻辑的直观理解,培养拆解问题、设计工作流的思维能力。毕竟,ReAct范式的核心思想不会因为LangChain发布新版本就过时,底层的认知框架才是真正可迁移的资产。
对于那些一直向往打造自己的AI智能体、却迟迟不敢开始的人来说,这或许正是一个值得参考的起点——先迈出第一步,剩下的路会越走越顺。
核心要点
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。