AI Agent时代:还需要自己写深度学习代码吗?
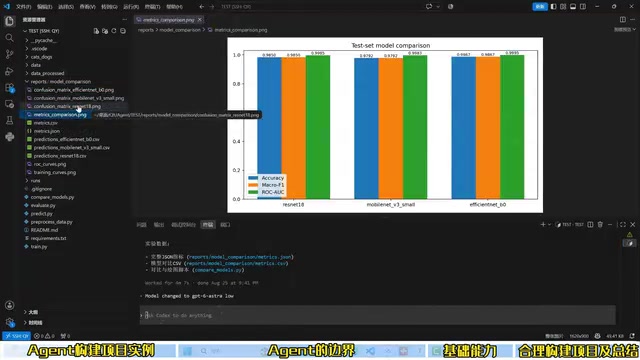
AI Agent能自动构建深度学习项目,但人必须保留理解流程与审查代码的能力。
本文通过一个实测演示说明:以Codex为代表的AI Agent已能从原始数据集出发,零人工编码地完成数据预处理、模型训练、结果可视化等完整深度学习流程。然而,这并不意味着人可以放弃对代码的理解。文章以「数据泄露」为核心案例,展示了Agent在划分训练集与验证集时可能将同一原始样本的多个增强版本分散到两侧,导致评估指标虚高的隐蔽问题。只有真正理解深度学习项目流程的人,才能发现这类错误并给出正确指令。结论是:AI时代的学习重心应从手写代码转向理解项目全貌、合理指挥Agent、审查代码质量,这三项能力才是真正不可替代的核心竞争力。
AI Agent能从零构建深度学习项目
随着Codex、Claude等AI编程助手的普及,一个问题摆在每个AI从业者和研究生面前:既然Agent能替我们写代码,我们还需要亲手学习深度学习项目的实现吗?B站UP主钱鱼通过一个实测demo给出了自己的答案。
实验设置非常直接:手头只有一份猫狗分类数据集,里面是不同类别的图片。把这份数据丢给AI Agent(如Codex),让它自主分析数据能做什么任务,完成数据预处理,编写完整的深度学习项目,执行训练,并绘制不同模型的对比结果。
整个过程中,操作者没有写任何一行代码。最终从一个只有原始数据的文件夹,得到了一个结构完整的项目——包含混淆矩阵、ROC曲线、训练Loss损失图与指标图,训练、验证、推理的代码一应俱全,而且项目是可复现的。
这个演示直观地说明:AI Agent确实有能力把一个端到端的深度学习项目自动搭建出来,把过去需要大量手工编写的重复性工作全部接管。
那我们就不用学写代码了吗?
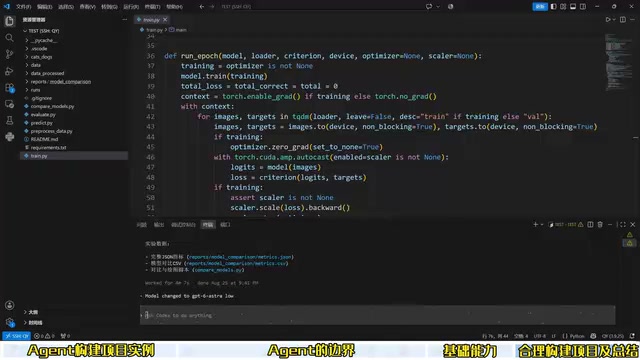
答案是否定的。UP主明确指出,AI只是替我们完成了重复性劳动——比如在训练脚本里写一个数据集加载类、搭建一套完整的训练流程。这些机械化的工作Agent能胜任,但这并不意味着我们可以彻底放弃对代码的理解能力。
真正的关键在于:我们必须具备阅读和检查AI所写代码的能力。AI生成的代码看起来能跑、能出结果,但结果是否正确、流程是否存在隐患,需要人来把关。如果连代码逻辑都看不懂,就无法判断Agent产出的项目是否可靠。
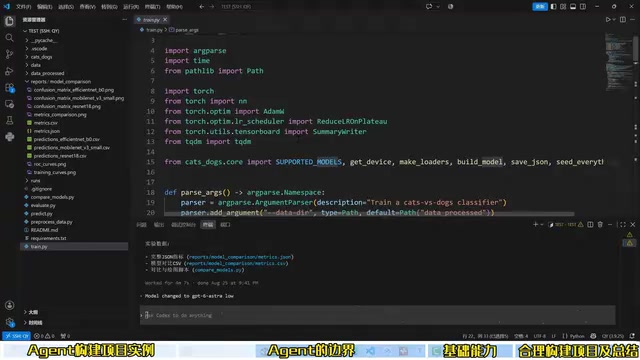
换句话说,写代码这件重复劳动可以外包给Agent,但对项目质量的判断力不能外包。这正是人在AI时代不可替代的价值所在。
数据泄露:AI容易踩的隐蔽陷阱
UP主用「数据泄露」这个经典问题,说明了为什么理解代码如此重要。
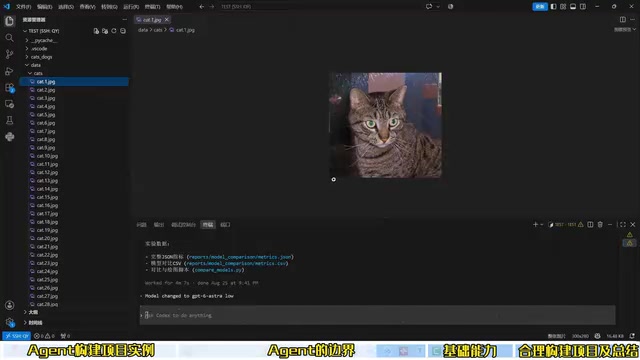
场景是这样的:猫狗两个类别的图像需要划分为训练集和验证集,训练集用于模型训练,验证集用于评估。如果我们先对原始数据做了增强——比如把第一张猫的图片通过旋转、翻转变成三张图片——问题就可能出现。
当你让Agent根据增强后的数据编写划分代码时,它很可能把同一只猫的三张图片,前两张分到训练集、后一张分到验证集。这就是典型的数据泄露:模型在训练时已经见过了这只猫的特征,验证指标自然会虚高,评估结果不再真实可信。
如何规避?两条路径:一是自己能看懂数据加载代码,及时发现问题;二是给出更精准的指令,要求Agent按个体划分——属于同一只猫的三张图片,要么全在训练集,要么全在验证集。
同理,在数据预处理环节,某些增强手段(如随机噪声、模糊)可能对特定任务产生负向影响,需要人来判断并剔除。这些判断都建立在对深度学习流程的真正理解之上。
数据泄露(Data Leakage)是机器学习中最常见也最难察觉的错误之一。其本质是:模型在训练阶段接触到了理论上只应在评估阶段才能看到的信息,导致验证集指标虚高,但模型在真实场景下的泛化能力远不如评估结果所呈现的那样好。数据增强场景下的泄露属于「样本级泄露」的典型形式——当多个增强样本来自同一原始样本(同一只猫),若未按原始个体做划分而是随机切分,同一实体的信息就会同时出现在训练集和验证集中,模型等于提前「背了答案」。另一种常见泄露形式是「特征泄露」,即预处理时使用了验证集的统计信息(如均值、方差)来对训练集做归一化,同样会导致评估失真。识别和规避这类问题,依赖的正是对深度学习全流程的系统理解,而非单纯的代码能力。
AI时代该把学习重点放在哪
结论清晰:深度学习依然要学,只是学习的重心发生了转移。
过去我们需要从零手写项目代码,如今这类重复性工作可以交给Agent。而我们应该把精力放在三件事上:
- 理解完整的项目流程:知道一个深度学习项目从数据到模型到评估的全貌
- 学会合理指挥Agent:清晰描述任务、说明数据位置、引导它先分析再构建
- 具备代码检查能力:能够发现数据泄露、预处理错误等隐患
UP主还分享了一份「搭建项目的提示文档」,涵盖如何从零构建项目(任务描述、数据定位、先分析后构建)、如何理解一个深度学习项目(数据检查、debug、构建Baseline、优化分析)等实用内容。
对于入门者,他建议的学习路径是:从Python基础起步,再到传统机器学习,最后进入前沿深度学习,配合各方向的入门项目循序渐进。
「Baseline」是深度学习项目开发中的一个关键概念,指在正式优化之前,先用最简单、最标准的方法跑通整个流程并得到一个基准性能数值。Baseline的意义在于:它是后续所有改进的参照系,只有先确定「最朴素的方案能达到什么水平」,才能判断后续的数据增强、模型改进、超参调整是否真的带来了提升。在指挥Agent构建项目时,要求它「先构建Baseline再进行优化」是一种有效的提示策略,可以避免Agent一开始就引入过多复杂模块,使得问题定位和结果验证变得困难。这一思路本身也是标准工业实践和研究规范的体现。
写在最后
AI Agent改变的是「怎么做」,而不是「要不要懂」。它把码农式的重复劳动自动化,却把对质量、正确性、方法论的把控更加凸显出来。会用Agent的人和会审Agent的人,能力差距会在数据泄露这类隐蔽问题上被无情放大。
对研究生和AI学习者而言,真正的基本功不再是背诵API或熟练敲键盘,而是理解流程、指挥工具、审查产出。这,才是Agent时代的核心竞争力。
相关推荐

xAI的Agent优势:把X实时数据变成模型工具
解析xAI为Grok打造的Agent能力:将X实时数据与Web作为模型工具,支持服务端工具调用、OpenAI兼容API和Beta多Agent架构。深入剖析其作为实时工具层的优势与作为完整Agent操作系统的不足。

Agent Gateway 接入 Cloud Trace:AI智能体请求的端到端追踪
Google Cloud 的 Agent Gateway 现已集成 Cloud Trace(预览阶段),可将一次 AI 智能体请求的智能体、网关、工具与 MCP 服务器全部调用收拢到同一条端到端追踪链路,基于 OpenTelemetry 标准实现,帮助开发者精准定位性能瓶颈。
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。