AI Agent时代新威胁:读个README就中招的间接提示注入
AI Agent时代,GitHub恶意仓库让「看一眼就中招」成真,防御关键在结构限权而非信任模型自判。
随着AI Agent具备自主读取和执行能力,GitHub上的恶意仓库已从「运行才中招」升级为「看一眼就中招」——攻击者将恶意指令藏入README或网页文本,Agent读取后便可能将私有数据外传或执行破坏操作,这一手法称为间接提示注入。安全公司追踪到约7600个恶意GitHub仓库,总下载量超1400万次,Claude Code、Gemini、ChatGPT均曾被诱导访问恶意仓库。让AI自行识别攻击的思路已被实验室测试证伪——12种防线九成被突破。业界共识转向结构性防御:Simon Willison的「致命三要素」(私有数据、不可信内容、对外通信)提供了清晰的拆解框架,主流工具也据此落地了只读起步、云端防火墙、沙箱执行等机制。对普通用户而言,优选可追溯来源、拆分高危权限、为Agent设置字段和白名单限制,是当下最务实的应对路径。
GitHub是开发者的宝库,上面有海量现成的妙妙工具。一条被反复验证的经验是:动手之前先搜一下,找不到再自己写,能节省大量时间和成本。但天下没有免费的午餐——开源精神固然宝贵,那些看起来人畜无害的工具里,可能藏着你无法承担的代价。
下载并运行陌生人代码,最常见的风险是依赖投毒、后门植入、数据窃取和挖矿勒索。而随着AI Agent时代到来,投毒变得更容易、更难防,甚至跃升到了「看一眼就中招」的地步。
从「运行才中招」到「看一眼就中招」
今年7月,一家安全公司披露了一次追踪行动,发现约7600个GitHub恶意仓库,其中800多个直接伪装成AI插件,这些插件和工具服务器总下载量超过1400万次。研究者甚至没有精确指向这些项目,只是命令Agent自己去寻找某个能力,结果Claude Code、Gemini、ChatGPT都直接找到了恶意仓库。
这些库真正可怕的地方在于:它们不需要你手动拉取到本地运行,只要AI阅读了这个项目、甚至只是看了一眼README,就可能中招。
这听起来像编造的恐怖故事。长期以来我们都相信「只看不拉取不会有事」,但现在情况变了。AI Agent具备了执行能力,一旦恶意文字进入它的上下文,它很可能分不清哪些是你的指令、哪些是网页里夹带的指令——因为对它来说,这些都只是文本。
间接提示注入:从学术概念到现实威胁
这个攻击手法有个名字:间接提示注入(Indirect Prompt Injection)。前几年它还停留在学术探讨阶段,如今已成为AI应用面临的主要安全问题。
这不是假设。据这位B站UP主分享,他本人在今年8月30日晚上就踩了坑:让Agent去GitHub搜方案,搜到两个星标204和194的仓库,看起来一切正常,Agent按流程把搜索结果整体读进上下文,结果直接报错,整个任务被干停。
类似案例在主流社区并不少见:
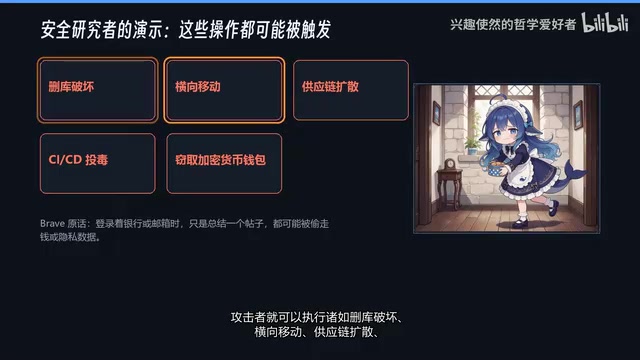
- Brave安全团队演示过在截图里藏一段人眼看不见的文字,浏览器Agent读到后照做,真的打开了Gmail,把一封邮件标题发给了攻击者的网址。按他们的说法,只要浏览器保存了登录状态,攻击者就能执行删库破坏、横向移动、供应链扩散、CI/CD投毒、窃取加密货币钱包等操作。
- 微软曾出过一次零点击事故:用户什么都没点,Copilot检索内部文件时碰到藏好的指令,就把它能看到的私密内容泄露了出去。
- Anthropic用Agent做红队测试了123个用例,自主模式下攻击成功率超过两成,加缓解措施后剩一成,采用最新防护机制可降到千分之一以下——说明问题并非无解。
间接提示注入与「直接提示注入」的区别在于攻击路径:直接注入是用户自己输入恶意指令绕过模型限制,而间接注入则是攻击者将指令藏在AI会主动读取的第三方内容中——网页、文档、代码注释、README、图片OCR结果,甚至不可见Unicode字符。AI Agent在执行任务时会自动抓取这些外部内容并放入上下文,模型无法从结构上区分「主人指令」和「内容中夹带的指令」,因为两者对它而言都是同一个token序列的一部分。这一缺陷源于大语言模型的基本工作机制:它被训练成「尽量遵循上下文中的指令」,却没有内建的可信来源标记体系。2023年以前该攻击主要停留在学术论文中,随着Claude Code、Cursor、Copilot等具备文件读写和网络访问能力的Agent工具普及,攻击面从「读」扩展到「读+执行」,危害等级因此大幅上升。
为什么不能指望AI自己防御
很多人会问:为什么不让无敌的AI自己去识别并抵御攻击?
答案是:测试过了,效果很差。14家实验室联名的论文显示,他们测试了12种注入防线,被突破概率高达九成,人工红队环节则全部被突破。
这也是为什么OpenAI的Lockdown Mode官方帮助页写得很直白:它不会试图阻止注入内容,只聚焦于切断外传数据的路径。防御的重点应放在结构限制上,而不是指望模型自己识别。
安全研究者Simon Willison把风险根源概括为「致命三要素」:私有数据、不可信内容、对外通信。三样凑齐,出事只是时间问题。破解之道是去掉其中一条,最容易去掉的就是「对外发数据」。Meta也持相似观点:三样最多只能占两样,若三样都占,就不要让它自主运行。
OpenAI的Lockdown Mode(锁定模式)是ChatGPT等产品中针对Agent场景推出的一项安全设置,其设计哲学体现了当前业界的主流共识:与其让模型在语义层面判断某段文字是否是恶意指令(已被证明极不可靠),不如在系统架构层面直接切断数据外传的通道。具体而言,Lockdown Mode会限制Agent调用外部URL、阻止将用户数据写入第三方服务,即便模型被注入了「把文件内容发到某网址」的指令,执行层也会拦截这个动作。这类「执行层防护」比「语义层识别」更可靠,因为它不依赖模型的理解能力,而是依赖确定性的规则判断。代价是功能受限:许多需要联网或调用外部API的合法任务也会受到影响,因此该模式通常需要用户手动开启,用于处理高敏感度任务。
主流工具的防护现状
基于「结构限制优先」的思路,主流Agent工具的防护逻辑已趋于一致:
- Claude Code 默认从只读权限开始,抓网页需要用户批准;
- GitHub Copilot 会在云端挂防火墙;
- Cursor 会把过不了白名单的命令放进沙箱执行。
通常审批类防护默认开启,而沙箱类往往需要手动打开。连DeepSeek广告也补上了相关防护,包括内网地址拒收、跨源跳转拒绝等。
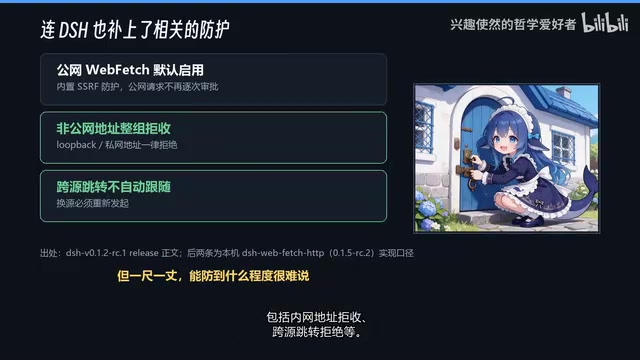
不过安全问题始终是道高一尺、魔高一丈,能防到什么程度,实在很难说。
沙箱(Sandbox)在这里指将Agent执行命令的环境与宿主系统隔离开来的技术机制。传统沙箱通过虚拟机或容器(如Docker)实现隔离,使恶意代码即便被执行也无法访问外部文件系统或网络。Cursor等工具的沙箱实现更轻量,核心逻辑是:对未通过白名单审核的shell命令,不在用户本地环境直接运行,而是放到受限的子进程或云端环境中执行,执行结果返回给用户审阅后再决定是否落地。白名单机制则要求用户或管理员预先声明哪些域名、命令、文件路径是可信的,Agent只能在该范围内自主行动,超出范围的操作必须暂停等待人工确认。这两类机制的共同缺点是配置成本较高,开箱即用体验较差,导致很多用户在实际使用中将其关闭,从而使防护形同虚设。
给普通用户的三条实用建议
我们不可能因噎废食,从此不去GitHub拉仓库。参考业界成熟路径,日常使用时可注意三点:
- 优选可追溯来源:尽量找大厂或开源可追溯的库,避免来路不明的项目。
- 拆分高危权限:别让同一个Agent同时握有「接触私有数据 + 处理不可信内容 + 对外发请求」这三项高级权限,敏感场景先断掉对外请求。
- 给Agent设闸:包括字段筛选、长度封顶、白名单机制,限制它能接触和输出的内容范围。
在这个日新月异的时代,我们获得了前所未有的强大力量,同时也遭遇了此前不太可能遇到的危险。当AI Agent从「读文本」进化到「执行动作」,安全的边界也随之重构。保持警惕,理解攻击原理,用结构化的权限设计而非盲目信任模型,才是当下最稳妥的应对方式。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。