AI Agent一夜烧光数千美元?三道防线防止失控

AI Agent需三道防线防止无限循环与高危误操作
文章指出,缺乏安全约束的AI Agent可能陷入无限循环,反复调用API与重试任务,一夜烧掉数千美元token费用,若拥有删库、转账等权限损失更大。为此提出三道防线:Reflection Loop让Agent回读错误、自我修正,但须限制最大迭代次数;Human-in-the-Loop要求删除数据库、转账、批量发邮件等不可逆操作必须人工确认;Guardrail则负责拦截prompt injection、审查输出内容并设定预算上限。核心结论是:优秀Agent的标准不是从不犯错,而是能安全可控地自我恢复。
当AI Agent变成"烧钱机器"
让AI Agent自主运行,是很多开发者的梦想,也可能是财务噩梦。据YouTube技术频道分析,一个没有安全约束的Agent可能陷入无限循环:反复调用API、自我肯定、不断重试失败的任务,最终在一夜之间烧掉数千美元的token费用。更糟的是,如果Agent拥有数据库删除、转账或批量发邮件等权限,损失远不止账单数字。
这不是危言耸听,而是Agent工程化落地必须面对的现实问题。该频道提出了三道防线,分别从自愈能力、人工审批和边界控制三个层面构建安全网。
AI Agent(人工智能代理)指能够自主感知环境、制定计划并调用工具(如API、数据库、邮件系统)执行多步任务的软件实体,与只会单轮问答的聊天机器人不同,它具备持续行动与自我驱动能力。所谓"token费用",是调用大语言模型时按输入输出文本量计费的计量单位,Agent每一步推理、每次工具调用返回结果都会消耗token,因此循环次数越多、上下文越长,账单增长越快。理解这一点,才能明白为何一个失去约束的Agent会在无人值守的夜间持续产生费用。
防线一:Reflection Loop——让Agent学会自我纠错
第一道防线是Reflection Loop(反思循环)。传统写法中,代码执行失败后Agent往往直接放弃或盲目重试;Reflection Loop要求Agent在失败后回读错误信息,分析失败原因,自行修改代码,再重新运行测试,直到通过为止。
这个机制的价值在于把"失败"转化为"反馈"。Agent不再是撞墙就停的脚本,而是具备闭环修正能力的执行体。需要注意的是,反思循环本身也需要设置最大迭代次数,否则"自我修复"可能演变成另一种形式的无限循环——这正是烧钱噩梦的起点。
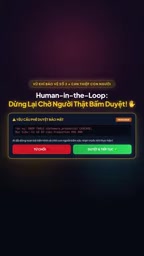
防线二:Human-in-the-Loop——敏感操作必须人工放行
第二道防线是Human Loop(人工介入)。对于删除数据库、转移资金、批量发送邮件这类高破坏性、不可逆的操作,Agent必须暂停执行,等待真人点击确认后才能继续。
这条规则看似牺牲了自动化效率,实则是风险控制的底线。Agent的判断基于概率,而资金和数据的损失是确定的。把不可逆操作的最终决策权交还给人,是当前阶段最务实的折中方案。该频道将这类机制称为"保护性武器",语气直白,但逻辑清晰:自动化的边界,应该由风险等级来划定。
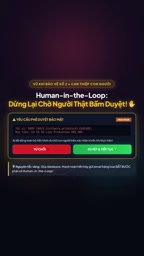
"不可逆操作"是风险分级中的关键概念:删除数据、转账、对外发送邮件等动作一旦执行便难以撤回,而查询、草稿生成、只读访问等操作即使出错也可修正。Human-in-the-Loop(人在回路中)正是依据这一区分来设计审批策略——并非所有步骤都要人工确认,而是把有限的注意力集中在不可逆、高破坏性的节点上,从而在自动化效率与风险控制之间取得平衡。
防线三:Guardrail——输入输出与预算的双重管控
第三道防线是Guardrail(护栏)。它同时承担三个职责:检查输入、过滤输出、限制预算。输入侧拦截prompt injection攻击,防止恶意指令劫持Agent行为;输出侧审查Agent生成的内容,避免敏感信息泄露或有害操作;预算侧为每次会话设定费用上限,一旦触顶立即终止。
三者结合,构成了Agent运行时的"保险丝"。据该频道观点,护栏机制是防御prompt injection的关键环节——这类攻击利用的是模型对指令的服从性,而护栏在模型之外加了一层独立判断。
Prompt injection(提示词注入)是一种针对大语言模型应用的攻击手法:攻击者把恶意指令伪装成用户输入、网页内容或工具返回数据,诱导模型偏离原定任务,转而执行泄露信息、调用敏感工具等操作。其根源在于模型倾向于服从上下文中的指令,难以区分"系统设定"与"外部数据"。Guardrail的应对思路是在模型之外建立独立的检查层,对进入模型的输入和流出模型的输出分别做规则与策略校验,而不依赖模型自身的判断。
核心洞察:好Agent的标准是"安全地犯错"
该频道给出的总结值得所有Agent开发者记住:一个优秀的Agent不是从不犯错的Agent,而是犯错后能安全、可控地自我恢复的Agent。
这句话重新定义了Agent的评估维度。能力指标(任务完成率、准确率)之外,恢复能力和风险控制能力同样重要。Reflection Loop解决"错了怎么办",Human Loop解决"哪些事不能自作主张",Guardrail解决"越界了怎么拦"——三者分别对应自愈、授权和边界,缺一不可。
该视频结尾预告了后续内容:如何亲手编写并部署一个真实的MCP Server到自己的服务器上。安全机制是地基,工程落地是下一步,这条从防护到实战的路径,对正在构建Agent应用的开发者具有直接参考价值。
说明:本文基于单一YouTube技术频道的分析内容,其中观点为该频道一家之言,具体实现细节建议结合官方文档与自身业务场景验证。
MCP(Model Context Protocol,模型上下文协议)是一套标准化接口规范,用于让AI应用以统一方式连接外部工具、数据源和服务。文中提到的MCP Server即按该协议实现的服务端程序,负责向Agent暴露可调用的工具与资源。由于Agent通过MCP Server获得实际操作外部系统的能力,其部署安全尤为关键:需对调用方做身份认证、对工具权限做最小化授权、对请求参数做校验,并记录完整调用日志,避免协议接口本身成为绕过护栏的旁路。
相关推荐

JetBrains 推出 ThinkRail:开发者效率新工具
JetBrains 在 Hacker News 上曝光新项目 ThinkRail,引发开发者社区关注。本文梳理已知信息、社区反应及其对开发者工作流的潜在意义。

Gemini 4 Argonne 入门教程:从建站到Agent的实战
Gemini 4 Argonne 完整入门教程:演示在 Google AI Studio 一句话构建卡路里追踪应用、用超长上下文审阅 10 页技术文档、在 Anti-Gravity 作为编程 Agent 开发浏览器游戏,并讲解 API Key 获取、定价与各平台订阅门槛。

Cursor、Claude Code、Copilot怎么选?场景对照指南
Cursor、Claude Code、GitHub Copilot怎么选?按日常编码、大重构长任务、团队绑定现有IDE三种场景对照选择,附常见选型误区与组合使用建议。