AI Agent智能体从零搭建全攻略:知识库与工作流实战

从认知到落地,一套系统化的AI智能体学习路径拆解
本文基于一套B站AI Agent实战课程大纲,为零基础学习者梳理了从认知到落地的智能体学习路径。文章指出,当前学习者的核心痛点不是缺乏教程,而是卡在动手环节——模型选型、工作流串联、知识库搭建是三大难关。课程以"三实一理"结构展开,覆盖智能体核心要素认知、私有知识库搭建(结合Cherry Studio、腾讯IMA等工具)、低阶与高阶两档实现方案(基于Coze/Dify平台及VS Code Cline插件),以及工作流编排与Deep Research类能力拓展。文章最后强调,面对快速演进的工具生态,抓住"模型+知识库+工具+工作流"这一底层框架比纠结单一工具操作更有长期价值。
AI Agent(智能体)正在成为个人与企业提效的新基建。有人把当下搭建智能体的机会比作早期公众号的红利期——越早动手,越可能成为“第一批吃螃蟹的人”。但现实是,九成的学习者都卡在同一个环节:收藏了大量教程,真正动手时却不知从何下手,模型选哪个、工作流怎么串、搭出来的东西“看着像回事,一问就露馅”。
本文结合B站一套系统化的AI Agent实战课程大纲,梳理一条从认知到落地的清晰路径,帮助零基础学习者少走弯路。
为什么现在要学智能体
智能体的价值,可以从个人与企业两个维度理解。
对个人而言,智能体更像一个“得力助手”:它不仅能承担重复性工作、提升效率,还能辅助内容创作、吸引粉丝,甚至打通变现路径。对自媒体从业者、自由职业者和学生党来说,这是一个门槛不高却回报可观的技能。
对企业而言,智能体的商业价值更为广阔。无论是客服、知识管理还是业务流程自动化,智能体都能嵌入真实的生产场景。原课程强调的核心判断是:真正有价值的不是“看起来很酷”的 Demo,而是真正能用、能跑通业务的智能体。
这也点出了多数学习者的痛点——教程刷得多,动手能力却没跟上。学习智能体的关键,是从“看懂”走向“做出来并用起来”。
课程定位与学习目标
这套课程面向的是“所有人”:职场人士、自媒体创业者、学生党、自由职业者都在适用范围内,门槛被刻意压低。
在学习目标上,课程采用“三实一理”的结构:前三个目标聚焦实操落地,确保学完能真正搭出可用的智能体;最后一个目标回归理论原理,做到“知其然,也知其所以然”。
这种设计值得借鉴。纯理论容易空泛,纯操作又难以迁移。只有把“怎么做”和“为什么这么做”结合起来,才能在面对新平台、新需求时具备举一反三的能力,而不是机械照搬教程步骤。
智能体的核心认知
课程的第一个模块是智能体概述,涵盖两个层面:
其一,是对智能体的认知演变——从早期对 Agent 的理解,到现代大模型驱动下的智能体概念,两者差异显著。早期更偏向规则驱动的自动化,而现代智能体则建立在大语言模型的推理与工具调用能力之上。
其二,是智能体的核心要素。理解这些要素(模型、提示、工具、记忆、工作流等)是搭建一切应用的基础。很多人之所以“工作流串得乱、搭出来一问就露馅”,根源往往在于对核心要素缺乏系统认知,只是在拼凑功能块。
私有知识库:智能体的记忆底座
知识库是让智能体“专业可靠”的关键。通用大模型知识面广但不懂你的业务,而私有知识库能把企业文档、个人资料接入智能体,让回答有据可依。
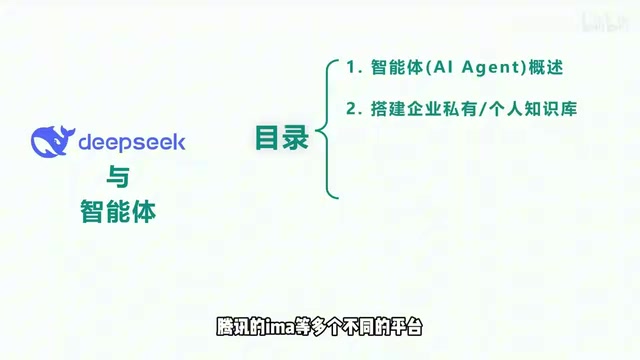
课程在这一环节结合了多个平台进行讲解,包括 Cherry Studio 和腾讯的 IMA 等工具,演示如何搭建“靠谱、好用”的企业私有或个人知识库。
多平台对比的意义在于,不同工具在易用性、数据隐私和检索效果上各有侧重。对初学者来说,先用上手门槛低的工具跑通一个最小可用的知识库,再逐步理解背后的检索增强(RAG)逻辑,是更务实的路径。
RAG(Retrieval-Augmented Generation,检索增强生成)是私有知识库背后的核心技术原理。其工作流程分为两个阶段:离线阶段将文档切片、向量化后存入向量数据库;在线阶段则将用户提问同样转化为向量,通过相似度检索找到最相关的文本片段,再将其作为上下文注入提示词,让大模型"有据可查"地生成回答。这种方式的优势在于,知识库内容可以随时更新而无需重新训练模型,且能有效减少模型"幻觉"(凭空编造事实)。理解RAG逻辑有助于判断知识库效果差的根源——通常出在文档切片策略不合理、向量模型选择不当,或检索召回数量不足等环节,而非模型本身的问题。
低阶与高阶智能体的实现路径
课程坦诚指出,现阶段智能体的实现仍在不断完善中,并没有唯一标准答案。为此,它给出了分层的实现方案。
在工具选择上,课程基于 Coze/Dify 类平台(原文提及的 Codes Define 平台)以及 VS Code 的 Cline 插件展开。前者可视化、低门槛,适合快速搭建;后者更贴近开发者,灵活度更高。
实现方式分为两档:
- 低阶智能体:提供多种实现方式,侧重快速落地与功能验证;
- 高阶智能体:给出三种实现方式,涉及更复杂的编排与能力扩展。
这种分层设计符合学习曲线——先用低阶方案建立成就感和整体认知,再逐步挑战高阶实现,避免一上来就被复杂架构劝退。
Coze(扣子)和Dify是目前国内使用最广泛的两类无代码/低代码智能体搭建平台。Coze由字节跳动推出,与豆包生态深度集成,提供插件市场和Bot发布渠道,上手极快;Dify则是开源项目,支持私有化部署,在数据隐私要求较高的企业场景中更受欢迎,同时对工作流的编排能力更为灵活。VS Code的Cline插件则代表另一种路径——面向有一定编程基础的用户,以代码编辑器为载体调用大模型API,适合需要高度定制化的场景。三者并非竞争关系,而是针对不同技术背景和需求的分层选择。
工作流:生产力的核心载体
如果说知识库是记忆,模型是大脑,那么工作流就是智能体真正释放生产力的方式。
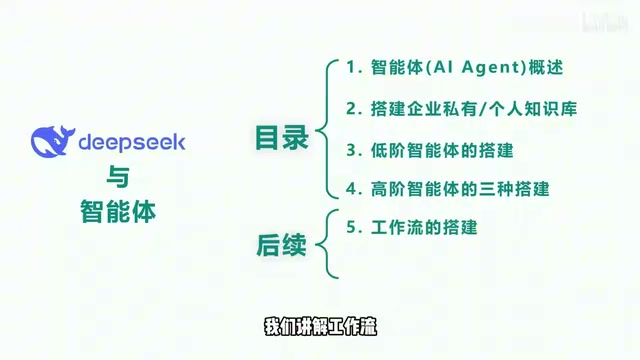
课程把工作流定位为“现阶段生产力的体现”,并基于平台重点讲解其搭建方法,配以多个实战案例。此外,还延伸到 Deep Research(深度研究)类能力的拓展应用。
工作流的本质,是把多个步骤、工具和判断逻辑串联成一条可自动执行的链路。它决定了智能体能否稳定、可控地完成复杂任务,而不是停留在单轮问答。这也是初学者最容易“串乱”的部分——理解每个节点的输入输出关系,是搭建稳健工作流的核心。
Deep Research是近期兴起的一类智能体应用范式,由OpenAI、Gemini等大模型厂商率先推出。其核心思路是让智能体自主分解研究问题、多轮检索网络信息、迭代筛选与整合,最终生成接近人工研究报告质量的深度内容。与单轮搜索问答不同,Deep Research依赖工作流对"搜索→阅读→判断是否需要继续搜索→归纳"这一循环的编排能力。在Coze、Dify等平台上,可以通过条件分支节点和循环节点来模拟这一过程,是学习复杂工作流编排的典型练手场景。
写在最后
从认知、知识库、低阶/高阶实现到工作流,这套大纲勾勒出一条相对完整的智能体学习地图。对零基础学习者而言,它的价值在于把零散知识点体系化,并强调“真正能用”的落地导向。
需要提醒的是,智能体领域仍在快速演进,具体工具和平台可能持续更新。学习时与其执着于某个工具的操作细节,不如抓住“模型 + 知识库 + 工具 + 工作流”这一不变的底层框架,才能在变化中保持竞争力。
相关推荐

OpenAI办公室发现录音设备:安全与隐私再引关注
OpenAI在一处办公室发现录音设备,事件细节有限但引发对AI公司物理安全与隐私保护的广泛讨论。本文分析事件背景、行业影响及对AI从业者的安全启示。

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。