AI“读脑补丁”事件复盘:权重读取真实可复现,但编辑能力被夸大

AI权重读取能力真实可复现,但数学性能飞跃被指夸大,实为代码与练习循环的功劳。
文章追踪了一起“AI自动修复AI”新闻的后续争议。软件库作者Matthew Honnable批评原报道标题误导:7.9%到48.1%的数学基准提升并非纯权重读取,而是Astra编写Python代码并在最多50批练习题上运行模型的结果。与此同时,开发者Simon Willison在笔记本电脑上复现了纯读取测试,Quinn 3.8(27B)成功从原始权重识别出Pac-Man、Pong和Breakout三款游戏,每款约需一小时推理,第四款失败。两个独立来源在“权重读取真实可复现”上达成共识,但在“编辑能力是否被夸大”上存在分歧。文章结论认为,权重读取能力真实,但大规模性能提升依赖工具循环,叙事需谨慎区分“纯读取”与“带工具编辑”。
事件回顾:一个被夸大的标题?
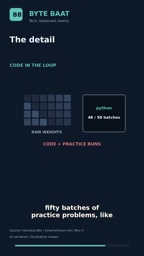
昨天我们报道了一个AI为另一个AI“打补丁”的故事,但仅一天后,事件就出现了分化。据YouTube频道分析,知名软件库作者Matthew Honnable公开批评该新闻标题具有误导性——那个著名的数学修复成绩(从7.9%提升到48.1%的基准测试),并非单纯通过读取原始权重实现。实际上,Astra编写了Python代码,并让模型在最多50批练习题上运行,就像人类工程师会做的那样。纯粹的、不借助工具的权重读取只出现在小型实验中。
这一澄清至关重要:媒体广泛传播的“AI自动修复AI”故事,其核心突破被简化了。真正实现大幅提升的,是一个包含代码编写、问题练习的完整循环,而非单纯“读脑”。
复现实验:权重读取能力得到验证
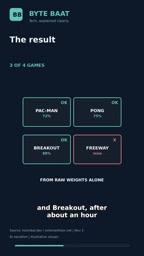
就在争议发酵之际,开发者Simon Willison在自己的笔记本电脑上运行了纯读取测试。他使用的模型是Quinn 3.8(27B参数),在仅读取原始权重、不借助任何外部工具的情况下,模型成功识别出了Pac-Man、Pong和Breakout三款游戏——每款游戏大约需要一小时的推理时间。不过,在第四款游戏上它失败了。
这一复现结果具有双重意义:一方面,它证实了“读取权重”能力真实存在且可在消费级硬件上复现;另一方面,也显示了该能力目前仍有边界。据Simon Willison的实验,模型在推理约一小时后才给出答案,说明这种读取需要大量计算时间,并非瞬时完成。
Quinn 3.8 与参数规模:文中提到的 Quinn 3.8(27B 参数)属于中等规模的开源大语言模型。27B 即 270 亿参数,这一量级使其可以在配备足够显存的消费级笔记本(如搭载 24GB 以上显存的移动工作站)上以量化方式运行。参数规模直接决定了模型内部可编码的知识密度和推理能力,也是“纯权重读取”实验能否在本地复现的关键前提。相比动辄数百亿甚至千亿参数的模型,27B 在推理时间与硬件门槛之间取得了平衡,但单次推理仍需约一小时,说明权重读取对算力的消耗远高于常规前向传播。
证据现状:什么站得住脚,什么被夸大
综合两个独立来源的分析,我们可以将当前证据分为两层:
站得住脚的部分:AI能够从原始权重中读取信息,这已在笔记本电脑上得到可复现的验证。Quinn 3.8成功命名三款游戏的事实,为“权重读取”提供了具体证据。
被夸大的部分:那个从7.9%到48.1%的数学基准提升,并非单纯权重读取的功劳。Matthew Honnable指出,Astra编写了Python代码并在最多50批练习题上运行了模型——这更像是一个人类工程师的工作流程,而非“魔法般的读脑”。据分析,Astra在过程中扮演了主动编写代码和练习的角色,而不仅仅是读取权重。
两个来源在“权重读取真实可复现”上达成共识,但在“编辑能力是否被夸大”上,Matthew Honnable的批评与原始报道形成分歧。目前来看,纯读取实验仅在小规模测试中成立,而大规模性能提升依赖于代码和练习循环。
基准测试提升的含义:文中反复出现的“从 7.9% 提升到 48.1%”指的是模型在某个数学基准测试上的准确率变化。基准测试通常由大量标准化题目组成,7.9% 接近随机猜测水平,而 48.1% 则表明模型具备了实质性的解题能力。然而,这种提升如果是在“最多 50 批练习题”上反复运行并配合代码生成实现的,就更接近监督微调或工具增强推理,而非单纯从权重中直接提取知识。区分“基准分数”与“能力来源”是评估此类报道的关键,因为分数本身不揭示模型是通过内部知识还是外部循环达成的。
深度分析:为何“纯读取”与“带工具”的界限重要
这一争议的核心在于对AI能力边界的准确描述。如果AI能够纯粹通过读取权重就实现数学能力的飞跃,那将意味着模型内部存在可直接提取的“知识结构”,无需外部交互。但Matthew Honnable的批评揭示,实际过程包含了代码生成和反复练习——这更接近“AI使用工具自我改进”的范畴。
Simon Willison的复现则从另一个角度提供了参照:纯读取确实可行,但耗时较长(每款游戏约一小时推理),且并非万能(第四款游戏失败)。这提示我们,权重读取能力目前更像是“X光透视”,能看清结构,但不足以直接完成复杂编辑。
正如原始评论所言:“一个像X光一样读取权重的AI,不需要一个过度推销的笔。”诚实的描述依然足够有力——AI能够读取权重,并在工具辅助下实现显著提升,但将两者混为一谈会误导公众对技术成熟度的判断。
权重读取与工具增强的技術分野:权重读取(weight reading)指模型不依赖外部工具、仅凭内部参数回答关于自身结构或训练数据的问题;而工具增强(tool augmentation)则允许模型生成并执行代码、调用计算资源或进行多轮练习。两者在技术实现和能力上限上差异显著:前者反映模型内部表征的可解释性与可提取性,后者体现的是智能体(agent)在循环中自我改进的工程能力。将工具增强的成果归因于纯权重读取,会高估模型内部知识的可直接访问程度,也会模糊当前 AI 系统“需要外部脚手架”这一阶段性特征。
结论:技术真实,叙事需谨慎
多源交叉验证的结果显示:权重读取能力真实且可复现,但“AI自动修复AI大脑”的叙事掩盖了代码编写和练习循环的关键作用。对于关注AI前沿的读者而言,区分“纯读取”与“带工具编辑”不仅是技术细节,更关乎对AI能力阶段的准确认知。未来,随着更多独立复现的出现,这一边界将更加清晰。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。