AI Gateway 新增 Private Inference:自托管模型统一接入

Vercel AI Gateway 推出 Private Inference,将自托管与微调模型纳入统一认证、SDK 和可观测性管理。
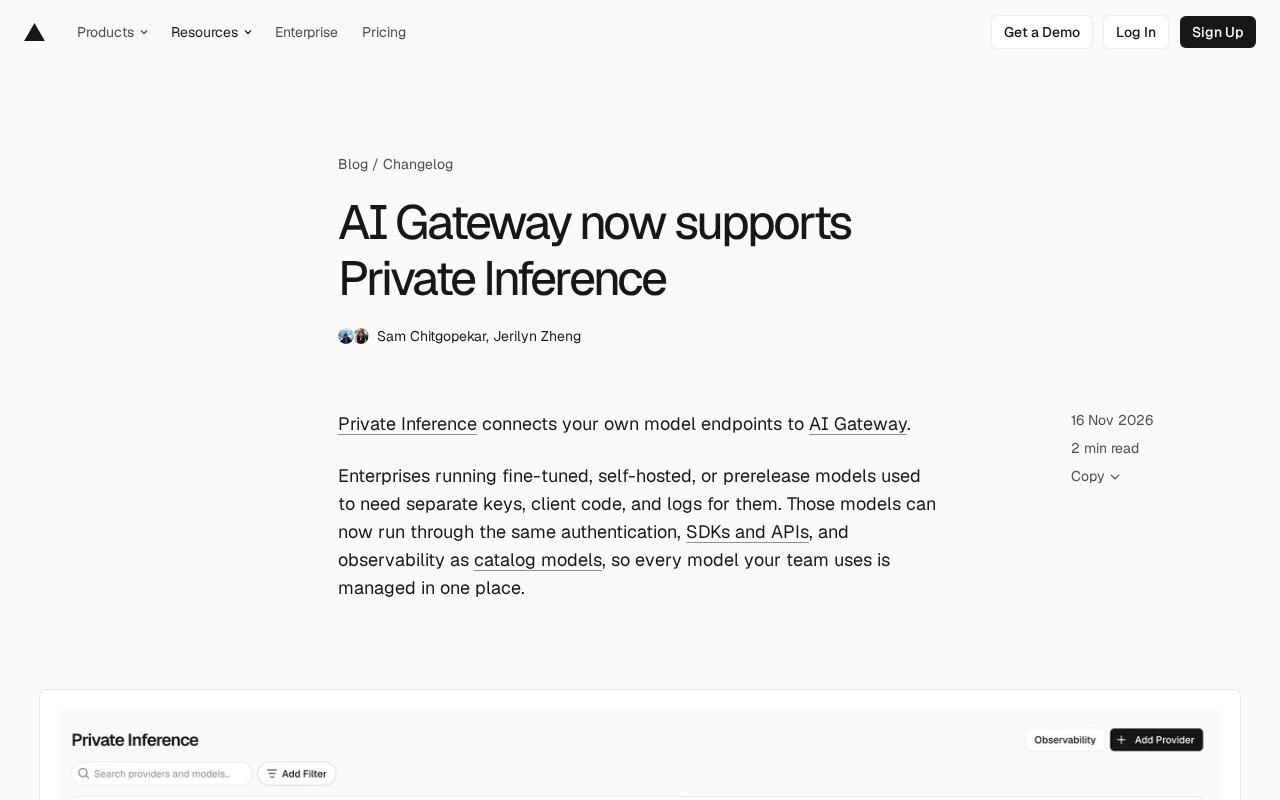
Vercel 的 AI Gateway 新增 Private Inference 功能,允许企业将自研、微调或预发布模型通过“私有提供商”接入网关,使用与目录模型相同的认证、SDK 和 API 调用。私有模型以 `private/<slug>` 模型 ID 调用,仅对所属团队可见,凭据加密存储并可选零数据保留。接入方式包括控制台配置和 Vercel CLI 65.16.0 以上版本。私有模型请求会统一进入日志、trace drains 和报表,可按模型查看请求数、token 数与首 token 时间;端点故障时可回退到目录模型。该功能解决的是模型治理与运维割裂问题,而非模型能力本身。
AI Gateway 新增 Private Inference:自托管模型统一接入
企业自研或微调的大模型,长期游离在统一的 AI 基础设施之外。Vercel 的 AI Gateway 现在通过 Private Inference 功能,将这类模型拉回主流程——用同一套认证、SDK 和可观测性来管理所有模型。
为什么需要 Private Inference
运行微调模型、自托管模型或预发布模型的企业,过去需要为这些模型单独管理密钥、客户端代码和日志。这意味着团队在 AI Gateway 上看到的只是一个割裂的视图:一部分流量走网关,另一部分散落在各个自建端点。
Private Inference 的核心思路是消除这种割裂。按照官方说明,私有模型现在可以像目录模型(catalog models)一样,通过相同的认证、SDK 和 API 调用,并共享同一套可观测性能力。团队使用的每一个模型,都在一个地方被管理。
AI Gateway 是 Vercel 提供的一项基础设施服务,它在应用与各个模型提供商(如 OpenAI、Anthropic、Google 等)之间充当统一代理层。开发者通过一个网关端点即可调用多种模型,网关负责处理认证、请求格式转换、速率限制、重试与故障回退,并集中记录调用日志和用量指标。其核心价值在于将模型调用从“每个提供商一套密钥和客户端”简化为“一个 API、一套凭据”。文中提到的目录模型(catalog models) 即指网关内置支持的这些公开可用模型,它们已经预先配置好端点与协议适配,用户无需自行维护连接细节。
私有模型如何接入
接入流程围绕“私有提供商”(private provider)展开。在 Private Inference 页面添加端点时,需要填写基础 URL、选择 API 格式,并添加凭据,然后登记该端点所服务的模型。
也可以通过 Vercel CLI 完成注册,要求版本 65.16.0 或以上。命令行方式适合纳入自动化流程:先创建私有提供商并指定 base URL,再创建模型并关联提供商与上游 API 模型名。
调用时使用 private/<slug> 形式的模型 ID。无论是 Chat Completions、Responses 还是 Messages 接口,AI Gateway 都会把请求翻译成端点所需的格式,因此切换私有模型和目录模型只需要改模型 ID。
零数据保留(Zero Data Retention) 是指服务提供商承诺不存储、不记录用户请求与响应内容的一种数据治理模式。在 AI 推理场景中,启用 ZDR 通常意味着请求 payload 在完成推理后即被丢弃,不会用于模型训练、日志分析或人工审查。对于金融、医疗等受监管行业,ZDR 是满足数据最小化与合规要求的关键配置。Private Inference 允许按私有提供商粒度启用该策略,使企业在享受统一网关便利的同时,仍能对敏感数据的留存范围保持控制。
首 token 时间(Time to First Token,TTFT) 是衡量大模型响应速度的核心指标,指从发出请求到收到第一个输出 token 所经历的延迟。与总生成时间不同,TTFT 更直接地反映用户感知的“等待感”,尤其影响流式交互与编码代理等场景的体验。在可观测性中按模型拆分 TTFT,有助于区分延迟瓶颈来自网关转发、上游端点负载还是模型本身。
关键能力拆解
团队隔离与凭据安全
私有模型只在所属 Vercel 团队内可见和可调用,不会出现在公开目录中。凭据以加密形式存储,并且可以按提供商启用零数据保留(Zero Data Retention)。对于处理敏感数据的企业,这层隔离是私有推理能否落地的前提。
编码代理直接可用
Claude Code、Codex、Cursor 等连接到 AI Gateway 的编码代理,可以直接使用私有模型。这让内部微调的代码模型不必再单独搭建一套代理接入层。
统一的可观测性
私有模型请求会与目录模型流量一起出现在日志、trace drains 和自定义报表中。可观测性图表按私有模型拆分请求数、token 数和首 token 时间。对于同时运行多种模型的团队,这意味着排障和成本分析不再需要跨系统拼凑数据。
可配置的故障回退
如果私有端点调用失败,可以选择回退到目录模型。这一设计降低了自托管端点稳定性波动对上层应用的影响,也给预发布模型的灰度验证提供了缓冲。
对企业的实际意义
Private Inference 解决的不是模型能力问题,而是模型治理问题。当企业同时使用公有目录模型和自托管模型时,最大的摩擦往往来自运维层面:密钥分散、日志割裂、调用方式不一致。把私有端点纳入网关后,模型切换退化为一个 ID 的变更,监控和回退策略也能复用同一套机制。
对于正在把微调模型投入生产环境的团队,这种统一接入方式减少了自建中间层的必要性。具体的模型类型支持范围、接入要求和计费细节,官方建议查阅 Private Inference 文档。
相关推荐
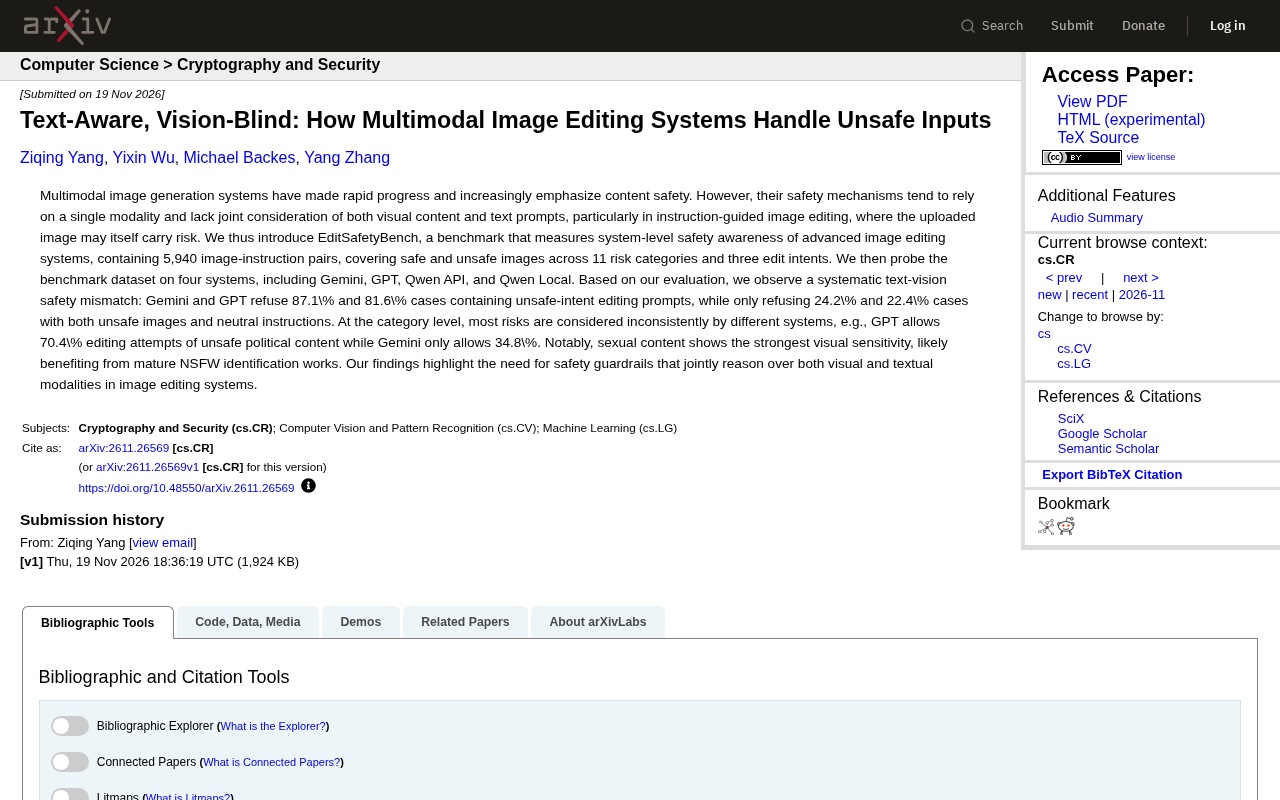
多模态图像编辑的安全盲区:文本敏感、视觉失明
EditSafetyBench基准测试Gemini、GPT、Qwen等图像编辑系统,发现文本-视觉安全错配:系统对不安全提示拒绝率高,对不安全图像却大幅放行,呼吁多模态联合安全护栏。
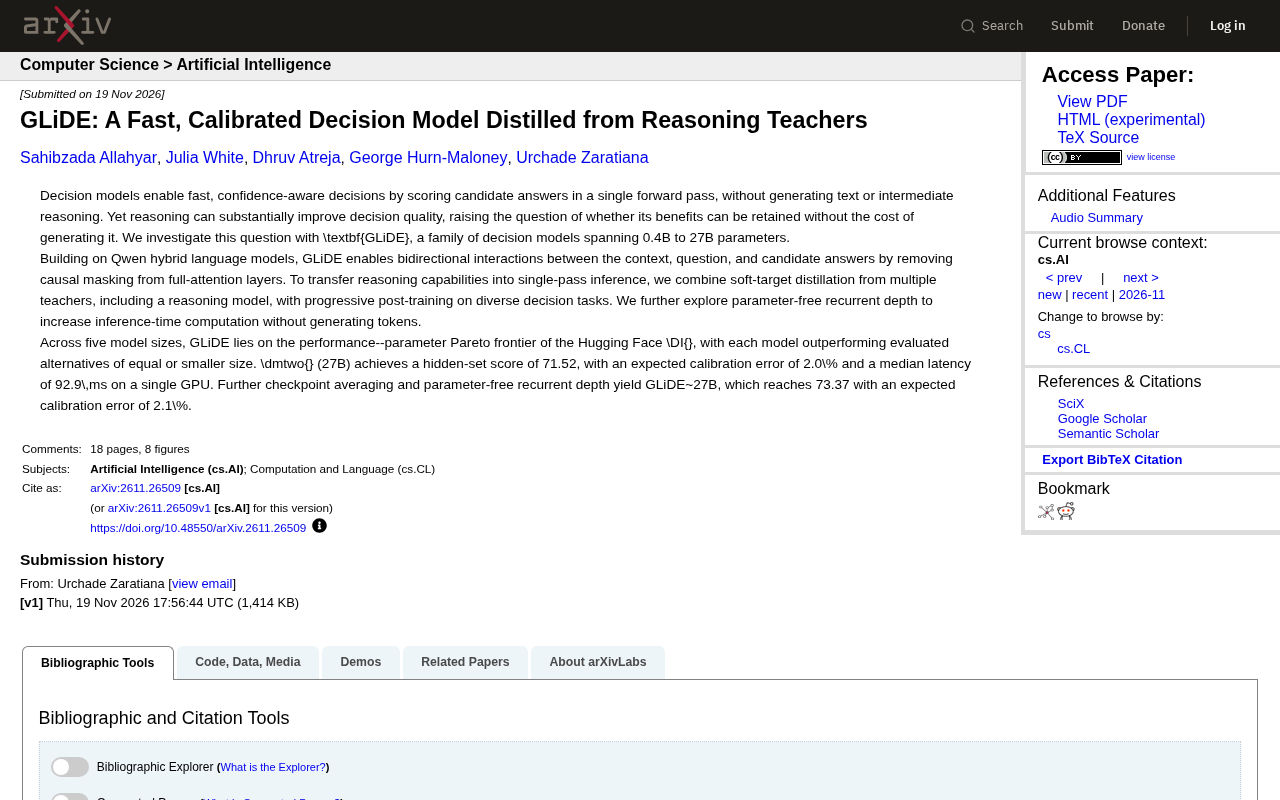
GLiDE:从推理教师蒸馏的快速校准决策模型
GLiDE 是一系列从推理教师蒸馏而来的决策模型,参数覆盖 0.4B 到 27B,通过移除因果掩码和软目标蒸馏实现单次前向的快速校准决策,27B 模型隐藏集得分 71.52,校准误差 2.0%,延迟 92.9ms。
用Claude Code几分钟搭建专业网站:五步实战指南
详解如何用Claude Code在几分钟内搭建专业网站:从规划提示词、精准迭代、MCP接入图片生成,到参考图重做设计与一键发布上线的完整五步流程。