AI SDK for Python 新增 Jev:实时语言检测与逐步代码生成实验
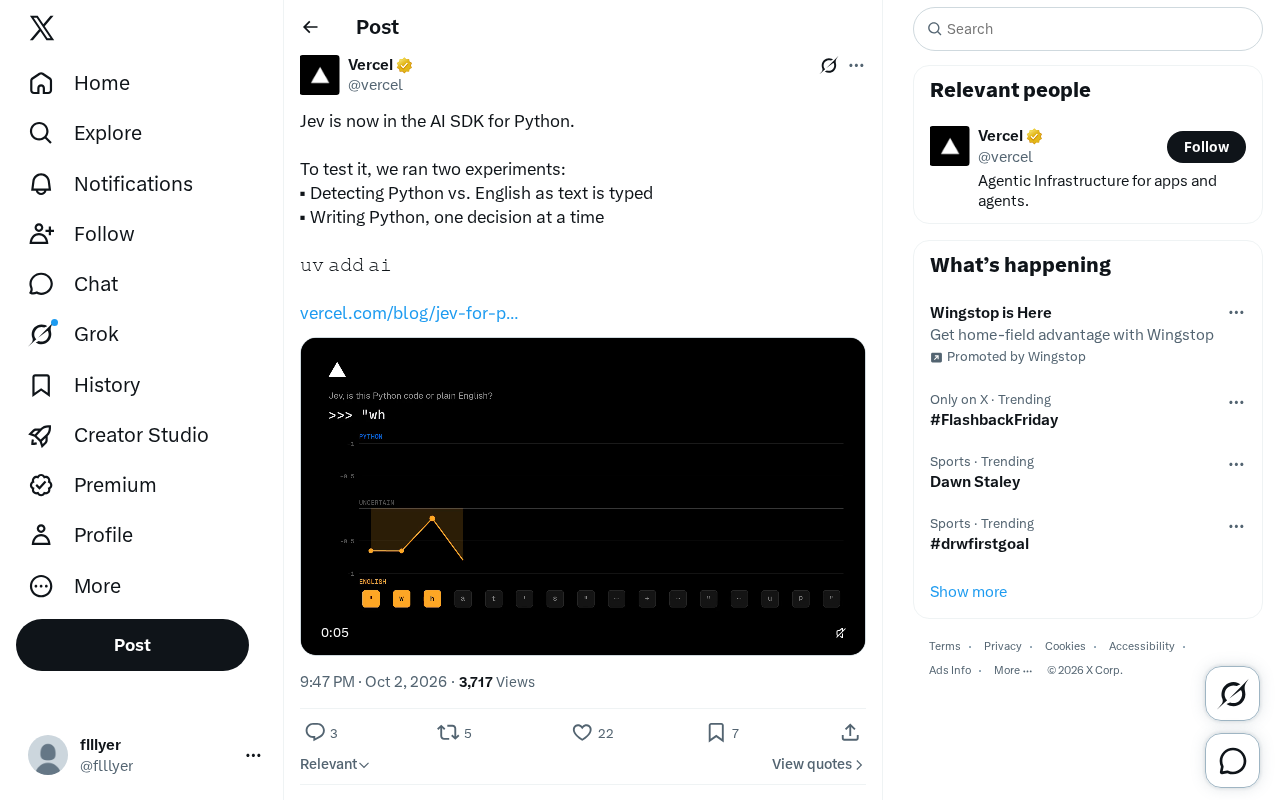
Jev 集成进 Python AI SDK,支持实时文本分类与逐步代码生成两大核心能力。
面向 Python 的 AI SDK 新增了 Jev 集成,开发者只需执行 `uv add ai` 即可将模型推理能力作为普通依赖引入项目。官方通过两个实验展示其核心价值:一是在用户逐字输入时实时判断内容是 Python 代码还是英文,考验低延迟推理能力;二是以"逐步决策"方式渐进生成 Python 代码,兼顾可控性与可解释性。这次集成折射出更大的行业趋势——AI 能力正从独立 API 服务演变为开发工具链的原生组成部分,大幅缩短从想法到原型的路径。目前关于 Jev 的技术细节与性能数据仍较有限,但其对实时交互与渐进生成的强调,使其成为 AI 编程工具领域值得持续关注的动向。
AI SDK for Python 迎来 Jev 集成
开发者生态中的 AI SDK 正在快速向 Python 社区扩张。根据 Twitter 上的最新动态,Jev 已被纳入面向 Python 的 AI SDK,并通过 uv add ai 这样简洁的命令即可完成安装。这一变化意味着 Python 开发者可以更方便地在本地项目中接入模型推理能力,而无需繁琐的环境配置。
从命令形式看,官方选择了 uv——一个近年来在 Python 社区快速走红的高速包管理与安装工具——作为推荐的安装入口。这种搭配既降低了上手门槛,也反映出团队希望让 AI 能力像普通依赖库一样被轻松引入工作流。
uv 是由 Astral 团队(也是 Ruff 代码格式化工具的开发者)用 Rust 编写的 Python 包管理工具,于 2024 年初正式发布后迅速获得社区关注。相比传统的 pip,uv 在依赖解析和包安装速度上有数量级的提升,同时兼容 pip 的接口习惯,支持虚拟环境管理与 pyproject.toml 项目规范。它的走红代表了 Python 工具链正在经历一轮以性能和开发者体验为导向的现代化升级。官方选择 uv add ai 作为推荐安装方式,也意味着该 SDK 从设计之初就优先适配了这套新兴工具链,而非沿用较为繁琐的传统安装流程。
两个实验:验证模型的实时能力
官方围绕 Jev 的集成设计了两个颇具代表性的实验,用来展示它在实际场景中的表现。
实验一:边输入边检测 Python 与英文
第一个实验聚焦于实时文本分类:当用户逐字输入内容时,系统需要即时判断这段文本是 Python 代码还是普通英文。这类任务看似简单,实则对低延迟推理提出了很高要求——模型必须在字符不断流入的过程中持续更新判断结果,而不是等待完整输入后再做一次性分类。
这个场景的价值在于它贴近真实的编辑器体验。现代代码编辑器需要在用户敲击键盘的瞬间就理解上下文,才能提供恰当的语法高亮、补全或切换输入模式。将语言检测做到“随打随判”,正是这类智能体验的基础能力之一。
实时文本分类在技术实现上通常依赖流式推理(streaming inference)机制:模型不等待完整输入,而是在接收到部分 token 序列后就开始输出概率判断,并随着新字符的到来持续修正结果。这对模型架构和推理引擎都有一定要求——前者需要能在短上下文窗口下给出有效判断,后者需要将首次响应延迟(Time To First Token,TTFT)压缩到用户感知阈值(通常约 100 毫秒)以内。在代码编辑器场景中,这类能力往往与语言服务器协议(LSP)配合使用,是实现智能补全、语法高亮切换等功能的底层支撑。
实验二:逐个决策地编写 Python
第二个实验更进一步,演示了逐步生成代码的能力:模型并非一次性吐出整段程序,而是“一个决策接一个决策”地写出 Python 代码。这种渐进式生成方式更接近人类程序员的思考过程——先决定变量、再确定逻辑分支、最后补全细节。
逐步决策的模式也有助于提升可控性与可解释性。相比黑盒式的整段输出,分步生成让开发者有机会在每一步介入、审查或修正,从而降低模型“跑偏”带来的返工成本。
为什么这类集成值得关注
将 AI 能力深度嵌入 Python SDK,背后反映的是一个更大的趋势:AI 正从独立服务走向开发工具链的原生组成部分。过去调用模型往往需要单独的 API 层和复杂的封装,而现在通过一行 uv add ai 就能把推理能力当作普通依赖纳入项目,这大幅缩短了从想法到原型的距离。
两个实验的设计也颇有针对性:一个考验实时性与低延迟,一个考验生成质量与可控性。它们共同指向一个目标——让 AI 在开发者日常高频使用的编辑、编码场景中真正落地,而非停留在演示层面。
小结
受原始素材所限,关于 Jev 的技术细节、性能指标与底层模型信息目前仍较为有限。但从公开的两个实验方向可以看出,这次集成强调的是实时交互与渐进式生成两大能力。对于关注 AI 编程工具演进的开发者而言,这是一个值得持续跟踪的动向。待更多文档和基准数据公开后,其实际价值将更加清晰。
相关推荐
语音识别远未解决:Mistral音频研究负责人深度解析
Mistral AI音频研究负责人Pavan Kumar Reddy深度解析语音识别为何远未解决:从Voxtral模型架构、连续隐变量生成、流式与批量权衡、说话人分离难题到DPO修复幻觉,以及语音技术在真实企业场景的落地短板。
AI权重可被复制,为何反而扼杀了创造力?
AI模型权重可被随意复制,这种开放权重的无约束特性反而削弱了创造力。本文解析复制为何是反模式、约束如何催生新颖,以及"约束工程师"这一正在浮现的新角色。
NVIDIA Cosmos解析:物理AI如何打通语言、视频与动作
NVIDIA研究负责人Ming-Yu Liu深度解析Cosmos物理AI世界模型:如何用单一架构打通语言、视频、音频与动作,涵盖自回归塔与扩散塔协作、多模态时间对齐、策略验证仿真及Super/Nano/Edge三种开源模型。