AI SDK 类型安全包 3.0.23 发布:决策调用新增推理与令牌控制

类型安全包 3.0.23 为实验性决策调用新增输出长度与推理参数并透传。
`@ai-sdk/typesafe-ai` 发布 3.0.23 补丁版本,核心改动是为实验性决策调用新增 `maxOutputTokens` 和 `reasoning` 两个参数,并将其透传给语言模型驱动的决策流程,同时将 `@ai-sdk/provider` 与 `@ai-sdk/provider-utils` 分别更新至 4.0.31 和 5.0.64。两个参数在不同适配器下行为不同:语言模型适配器在未传入 `reasoning` 时默认禁用推理,取向保守;原生决策提供商若不支持任一设置则发出警告而非静默忽略。文章认为,这次更新把类型安全层从约束输入输出结构扩展到覆盖调用行为的运行时策略,对多模型、多提供商应用尤其有价值,并给出了升级时的检查要点。
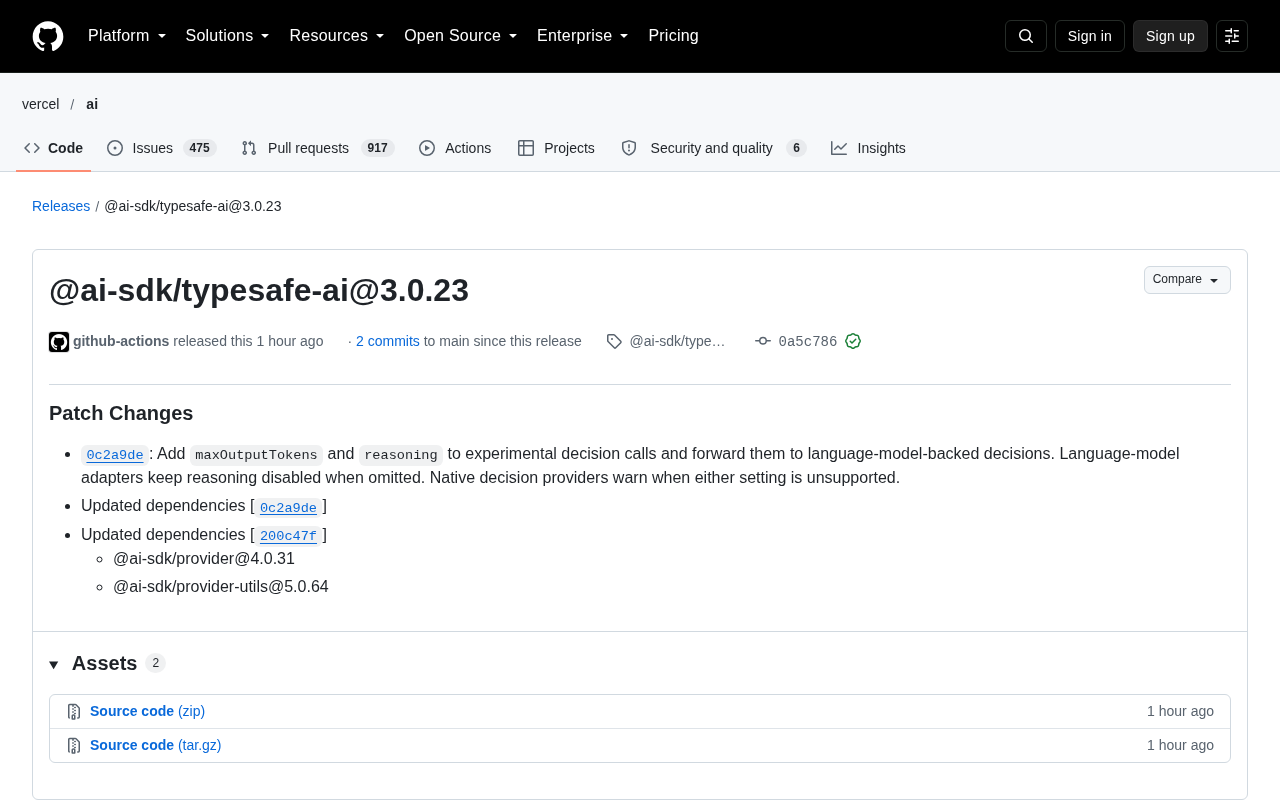
AI SDK 生态中的类型安全扩展包 @ai-sdk/typesafe-ai 发布 3.0.23 版本,这是一次小版本补丁更新,但改动触及了 AI 应用中一个日益关键的环节:如何在类型安全的前提下控制模型的输出长度与推理行为。
一次补丁更新,补上了决策调用的两个缺口
根据 GitHub 上的发布说明,本次更新的核心提交为 0c2a9de,内容是为实验性的决策调用(experimental decision calls)新增 maxOutputTokens 和 reasoning 两个参数,并将它们透传给由语言模型驱动的决策流程。同时,依赖项 @ai-sdk/provider 和 @ai-sdk/provider-utils 分别更新至 4.0.31 和 5.0.64。
从版本号来看,这是一个常规的补丁版本,但它解决的是开发者实际使用中会碰到的配置传递问题:当决策逻辑由不同后端承担时,参数能否保持一致地生效。
Vercel AI SDK 是面向 TypeScript/JavaScript 的大模型应用开发工具包,核心思路是把不同模型提供商(OpenAI、Anthropic、Google 等)的接口抽象为统一协议;@ai-sdk/provider 定义这套协议的接口类型,@ai-sdk/provider-utils 提供参数校验、流式解析等共用工具。@ai-sdk/typesafe-ai 则建立在其之上,为调用链补充更强的编译期类型约束。由于这三个包处于同一依赖链,底层包的小幅调整常常需要上层包同步版本号,本次 provider 与 provider-utils 的更新即属于这类联动,也是补丁版本中出现依赖变化的原因。
参数语义:默认保守,不支持则告警
发布说明中明确了两个参数在不同适配器下的行为差异,这部分细节决定了开发者迁移时需要关注的点。
语言模型适配器:未指定即禁用推理
当决策由语言模型适配器驱动时,如果调用方没有传入 reasoning 参数,推理功能会保持禁用状态。这是一个偏保守的默认值,避免在未明确要求的情况下触发额外的推理开销或行为变化。对于已经在生产环境运行决策流程的团队,升级后若希望获得推理能力,需要显式传参。
原生决策提供商:不支持就发出警告
对于原生决策提供商(Native decision providers),如果后端不支持这两个设置中的任意一个,系统会发出警告而非静默忽略。这种设计把配置与能力不匹配的问题暴露在开发阶段,比运行时无声失败更容易排查。
两相对照可以看出,这次更新的设计取向是「默认安全、问题可见」:不擅自启用可能增加成本的功能,也不让不支持的配置悄悄失效。
“实验性”(experimental)是 AI SDK 中一类命名约定:带此前缀的 API 表示接口形态尚未冻结,可能在次版本中调整甚至移除,但会提前进入发布包供开发者试用和反馈。实验性决策调用指由模型判断下一步动作(而非仅生成文本)的调用形态,其参数集合仍在演进,因此新增 maxOutputTokens、reasoning 时选择挂在这一入口而非稳定 API 上,既能让早期使用者验证行为,也保留了后续调整参数语义的空间。在依赖版本策略上,补丁号递增通常对应向后兼容的修复与新增可选参数,但实验性接口不受此保证约束,升级时仍应阅读发布说明。
为什么这两个参数值得单独做一次发布
在类型安全的 AI 调用封装中,参数透传看似琐碎,实则是类型系统与运行时能力之间的接缝。maxOutputTokens 关系到成本与响应时延的可控性,reasoning 则关系到模型是否进入更耗算力的推理模式。二者都属于「不传有默认、传了要生效、不支持要说清楚」的配置项。
把这类参数纳入实验性决策调用的统一入口,意味着类型安全层正在从单纯约束输入输出结构,扩展到覆盖调用行为的运行时策略。对于构建多模型、多提供商应用的团队,这种一致性比单个功能点更有价值。
升级建议
本次更新属于补丁级别,依赖项同步更新,未提及破坏性变更。使用实验性决策调用的项目可以按常规流程升级,并检查两件事:依赖语言模型适配器的决策路径是否需要显式开启 reasoning;使用原生决策提供商的路径是否会因为新增参数触发不支持警告。若出现警告,属于预期行为,按提示调整配置即可。
对于尚未使用实验性决策调用的项目,本次更新不影响现有调用,可随下次依赖更新一并处理。
常见问题
这次更新是破坏性变更吗?
发布说明标注为 Patch Changes,未列出破坏性变更。主要风险点在于原生决策提供商对新增参数的支持情况,不支持时会发出警告。
不传 reasoning 会发生什么?
在语言模型适配器下,推理默认禁用;在原生决策提供商下,若不支持该设置则会告警。
maxOutputTokens 的作用范围是什么?
作用于实验性决策调用,并被透传至语言模型驱动的决策流程,用于约束输出令牌数量。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。