AI SDK OpenAI 3.0.141 更新:结构化输出与提示缓存优化

AI SDK 的 OpenAI 提供方发布补丁,修复结构化输出 schema 变化时的缓存与推理复用问题。
`@ai-sdk/openai@3.0.141` 是一次低调的补丁级发布,核心围绕 Responses API 的结构化输出与提示缓存展开。它支持带定位的格式更新,使 JSON Schema 变化时仍能保留先前的推理内容并复用提示缓存;新增稳定的请求级文本格式覆盖,让单次调用的格式控制更明确;并为生成与流式结果暴露提示缓存对比诊断,便于排查命中情况。三点合起来,把 schema 迭代从高成本操作推向日常操作,对频繁调整输出格式的 Agent 与数据管道场景尤其有价值。发布未给出具体性能数字,实际收益需借助诊断信息自行评估。
一次低调但关键的小版本更新
AI SDK 的 OpenAI 提供方包发布了 @ai-sdk/openai@3.0.141 补丁版本。从发布说明看,这不是一次大张旗鼓的功能扩张,而是一次针对 Responses API 结构化输出 和 提示缓存复用 的底层修复。对于在生产环境中依赖结构化输出做数据抽取、Agent 工具调用的开发者来说,这类改动往往比新 API 更值得关注。
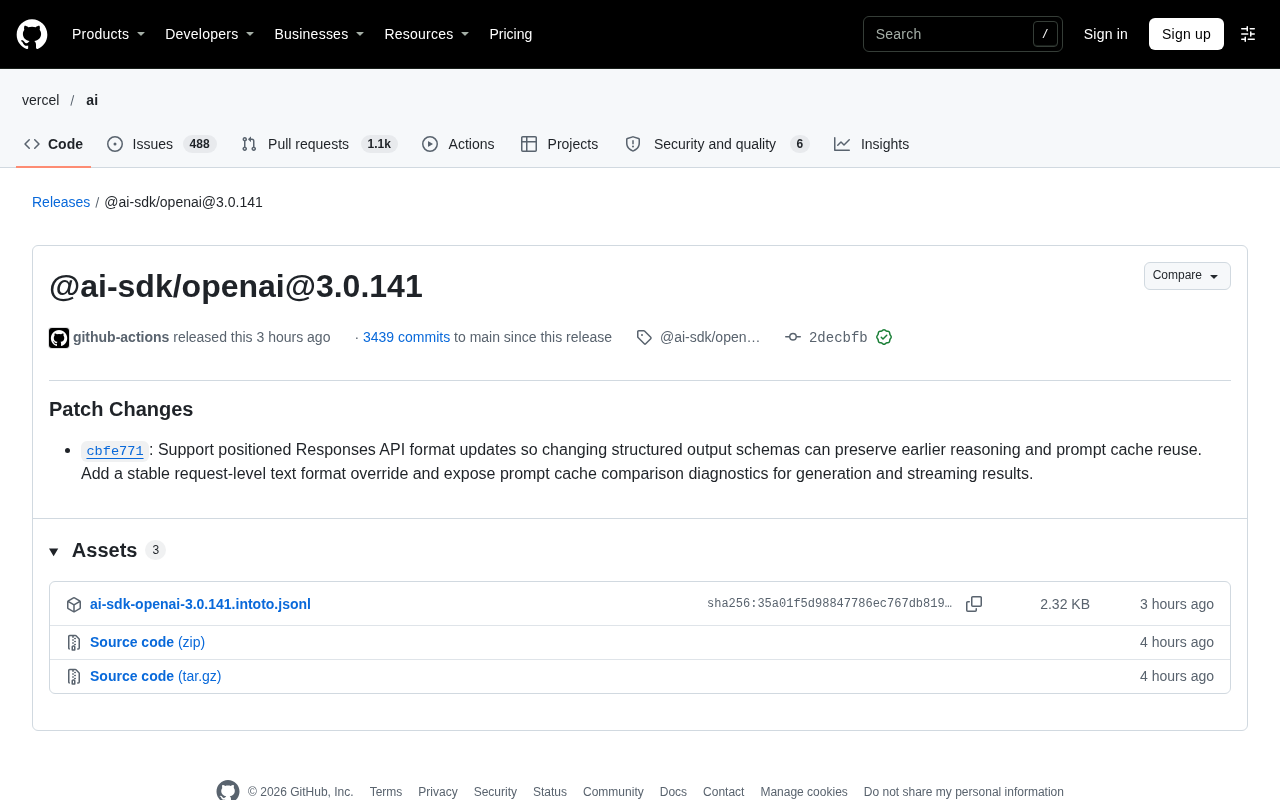
本次发布由 GitHub Actions 自动构建并签名,属于常规的补丁变更(Patch Changes)。发布说明只有一条核心变更记录,但信息密度不低。
核心变更:让结构化输出的模式切换不丢上下文
保留推理与提示缓存
根据发布说明,本次补丁「支持带定位的 Responses API 格式更新,使结构化输出 schema 的变化能够保留先前的推理内容并复用提示缓存」。
这句话的关键在于「schema 变化」这个场景。在实际开发中,结构化输出经常需要迭代——你今天调整一个 JSON Schema 字段,明天给某个属性加上枚举约束。在旧的行为下,schema 一变,请求格式随之变化,模型侧的提示缓存可能失效,此前的推理内容也难以延续,等于每次改 schema 都要付出一次完整的上下文重建成本。
新版本让这些格式更新变得「可定位」,从而在 schema 演进时保住两样东西:先前生成的推理内容,以及已经建立的提示缓存。对需要反复调优输出结构的团队来说,这直接关系到调用成本和响应延迟。
提示缓存(Prompt Caching) 是模型服务商提供的一种成本与延迟优化机制:当多次请求共享相同的提示前缀(如系统指令、长文档、工具定义)时,服务端会缓存这部分内容的计算结果,后续请求直接复用而无需重新计算。OpenAI 的自动缓存通常在提示超过一定长度(约 1024 token)后触发,命中后可显著降低输入 token 的计费并缩短首 token 延迟。缓存以「前缀完全一致」为前提,因此请求体格式的细微变化——哪怕只是工具定义顺序或 JSON Schema 结构不同——都可能导致前缀不匹配而缓存失效。这正是本文所述 schema 变化会带来成本波动的原因。
Responses API 是 OpenAI 相对 Chat Completions 推出的新一代接口,统一了文本生成、工具调用、内置工具与多轮状态管理,并通过 previous_response_id 等机制支持跨轮次延续。结构化输出在其上以 text.format 形式声明(如 json_schema)。
请求级文本格式覆盖
补丁还新增了一个「稳定的请求级文本格式覆盖」能力。这相当于在单次请求层面提供一个显式的格式控制开关,让开发者可以更确定地指定本次调用使用的文本格式,而不是完全依赖默认推导。结合上面的缓存保留逻辑,这个覆盖机制让格式切换变得可控且可预测。
结构化输出(Structured Outputs) 是指通过 JSON Schema 约束模型输出,使其严格符合给定结构,区别于仅靠提示词「希望」模型输出 JSON 的宽松做法。OpenAI 的实现包含 strict: true 模式,由解码阶段约束保证 schema 合规,但这也要求 schema 满足一系列限制(如所有字段必须列入 required、不支持某些关键字)。由于 schema 直接参与请求编码,它的任何改动都会改变请求指纹,进而影响缓存与推理延续——这是理解本次补丁价值的前提。
缓存对比诊断
另一个值得注意的点是「为生成和流式结果暴露提示缓存对比诊断」。这意味着开发者在普通生成和流式两种调用模式下,都能拿到关于提示缓存命中与对比的诊断信息。对于排查「为什么这次调用没有命中缓存」「缓存复用效果如何」这类问题,诊断信息是第一步。
这些改动意味着什么
把三点放在一起看,能看出这次补丁的意图:让结构化输出的迭代过程不再与缓存机制相互干扰。
过去,schema 调整常常被当作「破坏性变更」对待,团队会尽量攒一批改动再统一发版,以摊销缓存失效的代价。而格式更新可定位、支持请求级覆盖、并提供缓存诊断,这套组合把 schema 迭代从「高成本操作」推向「日常操作」。这对频繁调整输出格式的 Agent 应用、数据管道场景尤其有价值。
需要说明的是,发布说明并未给出具体的性能数字或缓存命中率数据,因此实际收益仍取决于调用模式和 schema 变化的幅度。开发者可以借助新增的诊断信息自行评估。
推理内容(Reasoning) 在推理模型(如 o 系列、GPT-5 系列)中由模型生成,用于记录得出答案前的思考过程。在使用 Responses API 进行多轮或工具调用时,这些推理项可随上下文回传,帮助模型保持一致思路;若请求格式变化导致推理项无法续接,模型需重新「思考」,既增加 token 消耗也影响结果稳定性。因此「保留先前推理内容」对依赖推理模型的 Agent 场景尤为关键。
升级建议
这是一次补丁级发布,没有引入破坏性 API 变更的描述,风险较低。建议以下几类项目优先升级:
- 正在频繁迭代结构化输出 schema 的项目;
- 对提示缓存成本敏感、需要诊断缓存行为的生产服务;
- 同时使用生成与流式两种调用模式的 AI 应用。
升级后,可以先用新增的缓存对比诊断观察一段时间,确认 schema 变更场景下的缓存复用行为符合预期,再大规模推广到线上流量。
小结
@ai-sdk/openai@3.0.141 的价值不在「新增了什么功能」,而在「让已有能力更省成本地运转」。结构化输出与提示缓存是 AI SDK 用户的两条主线,这次补丁把二者之间的耦合冲突做了针对性处理,属于典型的、值得跟进的基础设施级小版本。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。