@ai-sdk/xai 3.0.146 更新:成本信息进入响应元数据
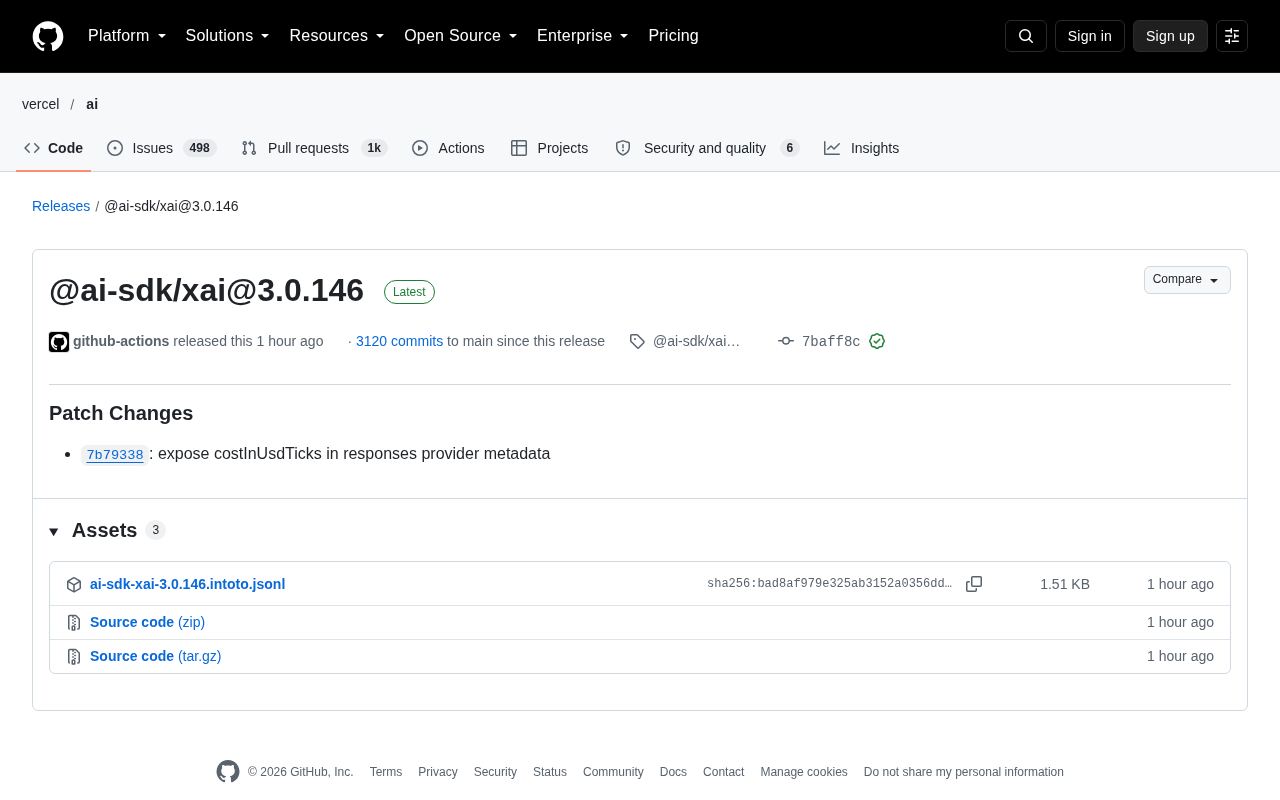
@ai-sdk/xai 3.0.146 在响应元数据中暴露成本字段,推动接入层内建成本可观测性。
AI SDK 的 xAI 接入包 @ai-sdk/xai 发布 3.0.146 补丁更新,唯一改动是在响应的 provider metadata 中暴露 costInUsdTicks 字段。文章认为,这一行变更的意义超出其体量:它把调用成本从开发者按 token 数自行估算,转变为由 provider 层直接返回的结构化数据。ticks 采用整数刻度以避免浮点误差,便于精确累加,但需要显式换算为美元。文章进一步建议开发者不要丢弃 metadata,应将其透传到日志与指标系统;同时提醒多 provider 场景下成本字段在命名、单位和是否提供上存在差异,需在应用层建立归一化层,并呼吁关注补丁级更新对可观测性能力的持续积累。
一次小版本更新,指向 AI SDK 的可观测性演进
AI SDK 生态中负责 xAI(Grok 系列模型)接入的官方包 @ai-sdk/xai 发布了 3.0.146 版本。这是一个补丁级别(patch)的更新,版本记录显示改动集中在一处:在响应的 provider metadata 中暴露 costInUsdTicks 字段。
单看变更条目,这只是一行 patch changes。但把它放回 AI SDK 的整体设计脉络里,它反映的是多模型接入层正在把「调用成本」当作一等公民的数据来处理——不再让开发者自己去按 token 数做乘法估算,而是由 provider 层直接返回可直接读取的成本数值。
变更解读:costInUsdTicks 意味着什么
把成本从「自己算」变成「直接读」
在 AI SDK 的抽象里,provider metadata 是各个模型服务商回传的非标准化附加信息存放处。不同厂商对 token 计费、缓存命中、批处理折扣的规则差异很大,统一抽象很难覆盖所有细节,于是 metadata 成为承载这些厂商特有信息的位置。
costInUsdTicks 被放进响应元数据,说明 xAI 的返回结果里开始携带结构化的成本数据。字段名中的 ticks 提示它采用整数刻度而非浮点美元金额——这是计费系统里常见的做法,用最小计价单位避免浮点误差,便于精确累加和结算。
Vercel AI SDK 的核心设计是提供一套统一的编程接口来调用不同厂商的大语言模型,其架构大致分为三层:最上层是面向开发者的 generateText、streamText 等函数;中间层是 provider 接口规范,定义了语言模型应实现的方法;最下层是各厂商的实现包,如 @ai-sdk/openai、@ai-sdk/anthropic、@ai-sdk/xai。LanguageModelV1 接口的返回对象中包含 usage(输入输出 token 数)、rawCall(原始请求信息)和 providerMetadata 等字段。providerMetadata 是一个按 provider 名索引的嵌套字典,允许厂商在不破坏统一接口的前提下回传私有数据。理解这一分层,就能明白为什么成本字段会被放进 metadata 而非顶层的 usage:它尚未被抽象成跨厂商的通用契约。
成本可观测量在实际项目中的价值
对构建在 AI SDK 之上的应用而言,这个字段的实用价值体现在几个场景:按用户或租户维度归集调用开销、在 Agent 多轮循环中实时监控成本上限、以及在对比不同模型路由策略时把成本作为可编程的决策变量。过去这些通常靠事后对账或自行估算,现在可以在每次请求的返回结果里直接拿到。
「刻度(ticks)」是金融与计费系统中的通用概念,指用固定小数位的最小整数单位来表示金额。例如某些交易系统以 1e-8 为最小单位,1 美元记为 100000000 ticks。这么做的好处是全程用整数运算,避免 IEEE 754 浮点数在累加大量小额数值时产生的舍入误差。对 costInUsdTicks 而言,开发者需要知道该 provider 定义的一 tick 对应多少美元(即刻度因子),才能正确换算。由于不同厂商的因子可能不同,且该信息通常记录在 provider 的文档或常量中,把刻度因子与换算函数集中管理、并写进类型定义或配置,是避免报表口径分裂的关键。
补丁级更新的定位
从版本号与变更记录看,这次发布没有引入 API 破坏性改动,属于增量式的能力补充。这类改动往往容易被忽略,但它们是 SDK 逐步积累可观测能力的方式:每接入一个 provider,就把该 provider 能提供的计费与用量信号沉淀到统一的数据通道里。
语义化版本(SemVer)规定版本号形如 主版本.次版本.补丁版本:主版本号变更表示不兼容的 API 破坏性改动,次版本号变更表示向后兼容的功能新增,补丁号变更表示向后兼容的问题修复或微小改进。3.0.146 中 146 的递增说明这是该次版本线下的第 146 次补丁发布,通常由自动化发布流程(changesets 等工具)根据提交的变更类型自动生成。在 provider 包高频迭代的生态里,补丁号快速累加是常态,单看版本号很难判断改动分量,必须结合变更日志中的具体条目来评估影响。
对使用 AI SDK 的团队的启示
关注 metadata,而不只是文本输出
多数开发者调用模型时只关心生成的文本或工具调用结果,而 provider metadata 常常被直接丢弃。随着各家厂商在 metadata 中补充用量、成本、缓存状态等信息,忽略这部分数据等于放弃了一层免费的观测能力。建议在封装调用层时,把 metadata 一并透传到日志或指标系统里。
计费单位的换算需要显式处理
以 ticks 形式返回的成本值需要开发者明确换算规则后才能展示给业务方。这类整数刻度的设计虽然精确,但如果换算逻辑散落在各处,容易产生前后不一致的报表。把它收敛到一个统一的换算函数里,是接入这类字段时值得做的工程约束。
多 provider 场景下的一致性挑战
AI SDK 的核心价值之一是让不同厂商的模型可以互换调用。但成本字段一旦进入 metadata,不同 provider 的字段命名、单位、是否提供该字段都会出现差异。团队如果要做跨模型的成本对比,需要在应用层建立归一化层,而不是假设所有 provider 都会返回同构的成本数据。
小结
@ai-sdk/xai 3.0.146 是一次范围很小的发布,变更内容仅涉及在响应元数据中暴露 costInUsdTicks。它值得被记录的原因不在于功能体量,而在于它延续了一个明确的趋势:模型接入层正在把成本与用量的可观测性内建到协议返回中。对开发者来说,及时消费这些元数据字段,能让成本管理从被动的事后核算转向请求级的实时掌控。
背景补充
从更宏观的视角看,可观测性(observability)在 LLM 应用中包含三个维度:延迟、用量与成本、质量。AI SDK 的 usage 字段已覆盖 token 用量,providerMetadata 则正在承担成本与缓存命中等厂商特有信号的载体。业界常见的做法是把这些字段统一导出到 OpenTelemetry 的 span 属性或专用指标中,再接入 Langfuse、Helicone 等观测平台,实现按 trace 维度的成本归因。这意味着应用层不仅要透传 metadata,还要为不同 provider 定义映射规则,把异构字段映射到统一的指标 schema,才能真正做到跨模型的可比与可聚合。
相关推荐

Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。

给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。