AI 写的代码能上生产吗?7 个必须检查的关键点

AI 能快速生成可运行的代码,但能跑通不等于可上生产,开发者须用工程判断力验证其正确性与安全性。
文章系统梳理了 AI 辅助开发中最容易被忽视的七个风险区。核心观点是:能运行的代码不等于正确的代码,一个成功的 API 响应并不能证明端点安全,例如 AI 生成的查询常缺少数据归属校验,导致越权访问。通过测试同样不等于覆盖完整,支付等场景还需考虑幂等性、并发、重试与信任边界。最危险的 Bug 集中在安全授权、数据库完整性、错误处理、性能和密钥配置五类隐蔽风险。作者建议让 AI 批判性审查自己的实现,但必须结合自动化安全工具与独立验证;同时把大功能拆成需求、设计、分片实现、逐块测试、集成、部署验证六个阶段。最终,AI 时代开发者的核心价值是工程判断力,而非写代码本身。
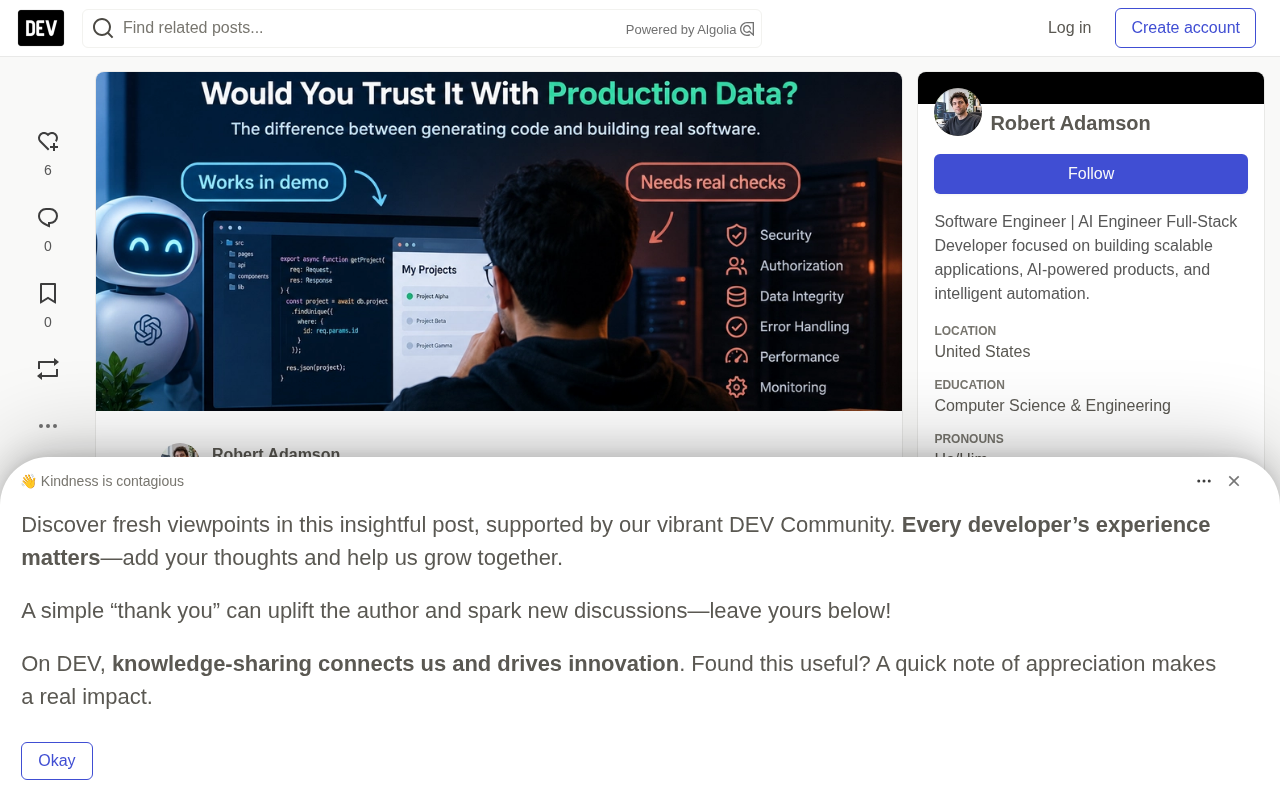
AI 编程智能体(Coding Agent)现在能在几分钟内生成一个包含前端、API、数据库模型、认证逻辑和测试的完整应用——这在几年前需要几天时间。但一个关键问题随之而来:你愿意把 AI 生成的代码用在真实用户、真实资金和真实生产数据上吗?
Demo 能跑通,和生产级就绪,是两回事。原文作者系统梳理了 AI 辅助开发中最容易被忽视的七个风险区,下面逐层拆解。
一、能运行的代码,不等于正确的代码
以一个「按 ID 返回项目」的 API 端点为例。AI 通常会这么写:
app.get("/projects/:id", async (req, res) => {
  const project = await db.project.findUnique({
    where: { id: req.params.id }
  });
  res.json(project);
});
代码逻辑没有问题,但一个用户请求另一个用户的 project 时会发生什么?如果没有校验数据归属,越权访问就此产生。
更安全的写法是把 ownerId 一并作为查询条件:
const project = await db.project.findFirst({
  where: {
    id: req.params.id,
    ownerId: req.user.id
  }
});
if (!project) {
  return res.status(404).json({ error: "Project not found" });
}
这个例子的重点不是「AI 总写不安全的代码」,而是:一个成功的响应,并不能证明这个端点安全或正确。 人必须理解代码应该保护什么。
二、通过测试,仍然可能漏掉关键问题
测试是必要的,但它只能告诉你「被测试过的场景」是通的。
假设 AI 生成了一个支付功能,你用四个场景测试:成功支付、无效支付被拒、金额显示正确、确认消息展示。全部通过——支付系统就能上生产了吗?
未必。更关键的边界场景往往没被覆盖:
- 支付渠道确认成功,但你的数据库更新失败怎么办?
- 支付渠道重复发送同一个 webhook 怎么办?
- 因为首次响应延迟,用户重试请求怎么办?
- 有人提交前篡改了请求里的价格怎么办?
这些问题涉及失败恢复、重试、并发和信任边界。支付系统通常需要幂等性(同一笔操作或 webhook 处理多次不应重复扣款)、服务端价格校验,以及与支付渠道的可靠对账。AI 可以帮你实现这些保障,但开发者必须验证这些保障真的存在、且行为正确。
通过测试只意味着被测试的场景通过了,不代表所有重要场景都被覆盖。
幂等性(Idempotency) 是分布式系统中的核心概念:同一个操作执行一次或执行多次,对系统状态的影响应当完全相同。在支付场景中,支付渠道可能因为网络超时而重复发送同一个 webhook,用户也可能因为界面无响应而重复点击「支付」。如果服务端没有幂等保障,同一笔订单就可能被扣款两次、发货两次。
实现幂等性的常见手段包括:为每笔操作生成唯一的幂等键(idempotency key),服务端处理前先查询该键是否已被处理过;在数据库层面对订单号等业务标识加唯一约束,让重复写入直接失败;以及把「扣款」与「记录订单状态」放进同一个事务或状态机中,避免部分成功导致的不一致。
需要强调的是,幂等性不是可以事后加上的补丁,而是必须在设计阶段就考虑进去的架构决策。AI 生成支付代码时往往默认「每个请求只来一次」,这恰恰是最危险的假设。
三、最危险的 Bug 往往不显眼
按钮失灵、页面崩溃、API 报错,这类 Bug 一眼就能发现。真正危险的是那些埋在生产环境里、直到真实用户使用才暴露的问题。原文列出了五类值得重点检查的隐患:
安全与授权:每个受保护的操作是否都验证了当前用户有权限执行?认证解决「你是谁」,授权解决「你能做什么」,两者不能混为一谈。
数据库完整性:并发请求会不会产生重复记录?删除一条记录会不会留下不一致的关联数据?重要约束是否由数据库层面强制?
错误处理:外部 API 超时、数据库连接失败、出现意外值时,系统会怎样?
性能:只需要的十条记录,接口是不是加载了上千条?页面是否发出了多余的 API 请求?查询会不会随着数据增长变得昂贵?
配置与密钥:API Key 是否暴露在前端代码里?生产密钥是否安全存储?必需的环境变量缺失时,应用会安全失败吗?
这些问题并非 AI 代码独有,资深开发者也会犯。但当 AI 快速生成大量代码时,你很容易产出超过自己审查能力的代码量——真正的风险从这里开始。
认证(Authentication)与授权(Authorization) 经常被混为一谈,但它们在安全模型中承担完全不同的职责。认证解决的是「你是谁」,即验证用户身份,常见实现包括密码登录、JWT token 校验、OAuth 登录等。授权解决的是「你能做什么」,即判断已认证的用户是否有权访问某个资源或执行某个操作。
最典型的越权漏洞就发生在两者之间:用户确实登录了(认证通过),但系统没有检查他是否有权访问目标资源(授权缺失)。这类问题在 AI 生成代码中尤为常见,因为 AI 往往只实现了「登录后才能访问」这一层,却忽略了「只能访问自己的数据」这一层。
防御要点是:授权检查必须在服务端强制执行,绝不能依赖前端隐藏按钮或菜单;对每一个受保护的操作,都要显式验证当前用户与目标资源之间的归属或角色关系。认证是门槛,授权才是真正的边界。
四、别再只问「它能跑吗」
当一个功能完成后,跑起来点几下就收工,是最容易犯的错。作者建议换一组提问方式:让 AI 批判性地审查自己的实现。
可以给 AI 一段这样的审查提示:
Review this implementation as a critical software engineer.
Do not assume the code is correct just because it works.

Check for:
1. Authentication and authorization problems.
2. Data leaks between different users.
3. Input validation issues.
4. Database consistency and race conditions.
5. Missing error handling.
6. Security vulnerabilities.
7. Performance problems.
8. Missing tests and edge cases.

For every finding:
- Explain the actual risk.
- Identify the affected code.
- Describe how the problem could be reproduced.
- Suggest a concrete fix.

Do not claim an issue exists unless you can support it
with evidence from the code or a reproducible test.
这是一个有用的起点,但不是安全保证。AI 审查器可能漏掉漏洞,也可能报告并不存在的问题。对重要系统,要把代码审查与自动化安全工具、针对性测试和独立验证结合起来。另外,不要只让 AI 列问题,要让它给出证据——说明哪里会出问题、为什么重要、如何复现。
五、给 AI 更小的任务,然后自己验证结果
另一个提高可靠性的习惯是:不要把一个大功能当成一个巨型 Prompt 丢给 AI。
以构建完整订阅系统为例,可以拆成六个阶段:
- 定义需求:明确订阅状态、支付流程、取消规则、访问权限和失败场景。
- 设计实现:在生成代码之前,先审查数据库结构、API 契约和关键安全决策。
- 分片实现:把订阅模型、支付集成、webhook 处理、访问控制逻辑拆成可控的小块。
- 逐块测试:检查正常行为、非法输入、重复请求、失败操作和异常状态。
- 审查集成:确认各组件组合在一起仍能正确工作。
- 验证部署:检查生产配置、数据库迁移、日志、监控和回滚流程。
这种方法不能消除 Bug,但能让问题更容易被隔离、理解和修复。你依然可以用 AI 快速推进,只是别把速度当作衡量进度的唯一指标。
API 契约(API Contract) 指的是前后端、服务与服务之间关于接口行为的明确约定,通常包括:请求的路径、方法、参数格式与校验规则;响应的状态码、数据结构与错误格式;以及各种边界情况下的行为(如资源不存在、权限不足、参数非法时返回什么)。
在让 AI 生成代码之前先确定契约,价值在于把「设计决策」和「代码实现」分开。契约一旦确定,就可以先审查数据库结构、权限模型和错误处理策略是否合理,再让 AI 分块实现;同时,清晰的契约也让前后端可以并行开发,并为后续的集成测试提供明确依据。
没有契约就急于生成代码,常见结果是:接口字段名前后不一致、错误码随意定义、边界行为全靠猜。等到集成阶段才发现问题,返工成本远高于提前花时间把契约写清楚。
六、开发者的角色在改变,而不是消失
作者的核心判断是:AI 能不能写代码,已经不是最重要的问题——它显然能。更有意思的问题是:当写代码变得更快更容易,开发者应该把注意力放在哪里?
答案是工程判断力:理解需求、选择合适的架构、识别风险、验证实现、对结果负责。AI 在这些环节都能帮忙——解释陌生代码、建议替代架构、生成测试、识别潜在漏洞、自动化重复劳动。
但「生成一个建议」和「证明这个建议是对的」,是两件不同的事。随着 AI 工具越来越强,对基本功的理解反而更有价值——你需要能判断一个实现是否合理、一个假设是否危险、什么时候需要更多证据。
七、上线 AI 生成代码前的实用清单
在部署 AI 辅助构建的功能前,作者建议逐项确认:
- 实现是否满足真实需求?
- 认证与授权是否在服务端强制执行?
- 一个用户能否访问另一个用户的私有数据?
- 输入是否在服务端校验?
- 错误处理是否会泄露敏感信息?
- 重要边界场景是否已被测试?
- 重试或并发请求是否会导致重复或不一致的操作?
- 密钥是否被排除在公开代码和日志之外?
- 数据库查询和 API 调用是否做过性能审查?
- 是否运行过自动化检查和相关安全工具?
- 功能出问题时,能否被监控和回滚?
并非每个功能都需要同等程度的审查。个人原型和生产支付系统的风险画像完全不同——失败的潜在影响越大,需要的证据和独立验证就越多。
写在最后
AI 编程智能体确实改变了构建软件的速度,这是好事。开发者可以更快实验、自动化重复任务、把时间花在更有意义的问题上。
但更快的代码生成不会自动带来更可靠的软件。能跑的 Demo 不是安全证明,通过的测试不是完整性证明,AI 说一句「实现完成」也不是功能可上生产的证据。
真正的技能,是知道如何把生成的代码转化为你敢于维护的软件。别只让 AI 帮你构建应用,还要让它帮你证明应用是正确的——然后由你自己核实这些证据。
相关推荐

Claude Pro不含API权限?Max与Team计划新增API额度详解
Claude Pro订阅不含API访问权限,API需单独计费。但Max和Team计划现已包含每月API额度:Max 5x为100美元,Max 20x为200美元,Team每席位最高合计500美元。本文详解各档位额度、领取方式及对开发者的影响。

隔离环境实测35万星REA:4秒装完,但两个坑要当心
隔离实验室实测35万星开源逆向工程工具REA:4秒安装、15秒列出截图工具全部外联地址、梳理565个通信通道,同时暴露写入用户级设置与31个高风险工具权限两个坑,附三条安全使用规则。
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
一位开发者因Adobe提前取消费转向逆向工程,用AI Coding Agent几周内做出7款开源替代品。本文解析逆向工程原理、Reverse Engineer Anything这个MCP Server六天破10万星的原因,以及AI克隆应用在性能、专有数据和法律层面的真实边界。