爱一个网站,就把它备份下来

HN 热帖提醒:喜欢一个网站就备份它,因为内容不会永久在线。
文章由 Hacker News 上一篇题为《If you love a website, back it up》的热帖出发,探讨互联网内容并非永久可访问的现实。域名到期、主机停运、平台下架与审核政策变化,都可能让曾经活跃的网站消失,把 URL 当作永久地址是一种错觉。文章将“备份网站”拆解为单页保存、整站抓取、公共归档服务和内容再分发四个可操作层面,并指出备份不仅是技术动作,也具有内容伦理意义:本地副本或存档链接能让引用在原始页面失效后仍有据可查。对独立创作者而言,主动提供归档、导出或 RSS 全文输出,能降低读者保存门槛,延长内容的传播周期。
一个 HN 热帖引出的数字保存焦虑
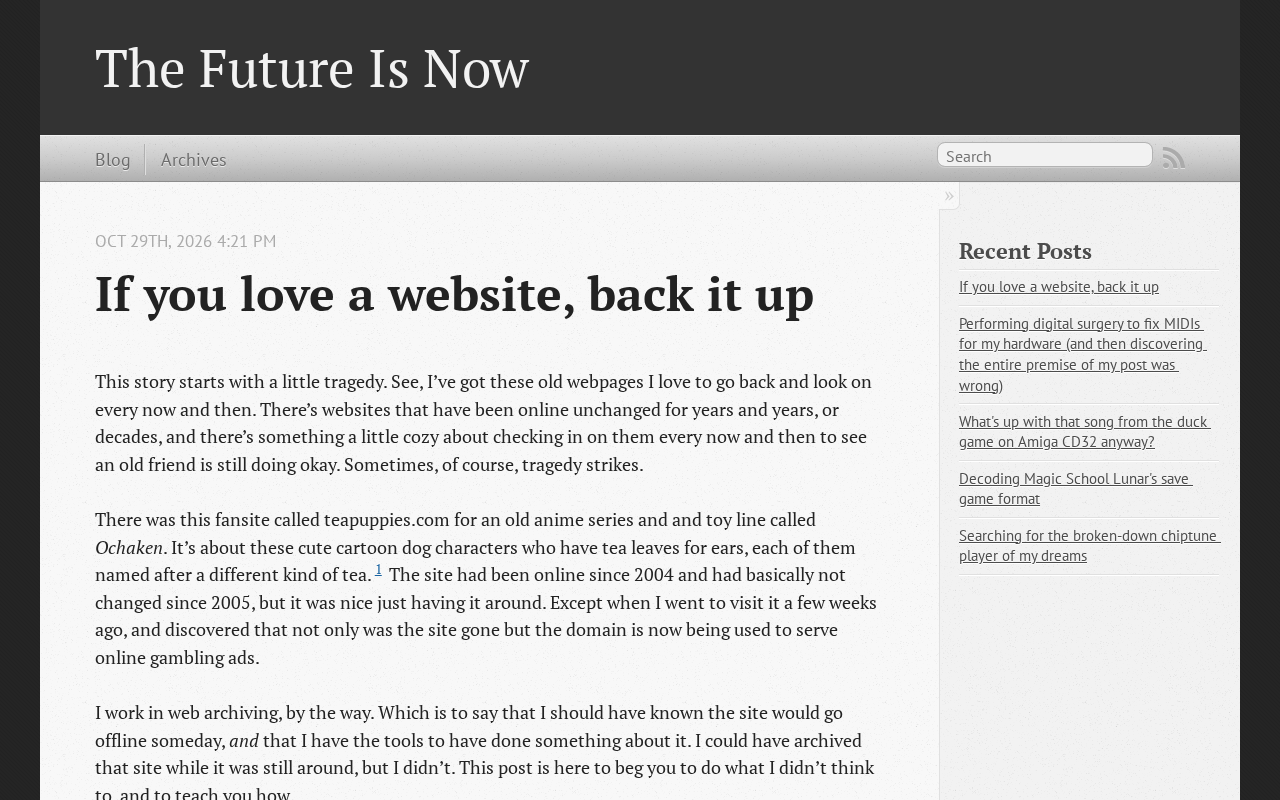
Hacker News 上出现了一篇题为《If you love a website, back it up》的帖子,获得了 212 个点数与 52 条评论。这个标题本身就点破了一件事:互联网上的内容并不天然持久,而“备份”这个看似技术化的动作,其实是一种内容消费之外的主动保护行为。
帖子源自个人博客 blog.mistys-internet.website,讨论的核心不是某个具体工具或协议,而是一种态度——当你认为某个网站值得长期阅读和引用时,把它的内容保存到本地,可能比指望它一直在线上更为可靠。
为什么“网站一直在”是一种错觉
链接腐烂与内容消失
日常使用互联网时,人们倾向于把 URL 当作永久地址。但个人博客、独立站点和兴趣社区的生命周期,往往比商业平台短得多。域名到期、主机停运、作者失去维护兴趣,都会让一个曾经活跃的网站归于沉寂。
Hacker News 上的讨论虽然原文未逐条展开,但 52 条评论意味着有相当多读者对这一话题有表达欲。从一个标题贴能获得 212 点来看,这种“看到喜欢的内容就想存下来”的冲动,在技术读者群体中相当普遍。
链接腐烂(Link Rot) 是数字保存领域的经典术语,指原本有效的超链接随着时间推移指向失效页面(404)或内容被替换的现象。哈佛法学院 2014 年的一项研究曾抽查《纽约时报》等媒体文章中的链接,发现超过 49% 的链接在数年内已无法访问原始目标。链接腐烂对学术引用、法律文书和新闻报道的伤害尤为严重——当引用的源头消失,论证的可验证性也随之瓦解。与之相伴的概念是内容漂移(Content Drift),即链接仍然可访问,但页面内容已被修改或删除,导致引用语境失真。这两个现象共同说明:URL 只是指向资源的指针,而非资源本身,指针失效或指向偏移时,唯有独立副本能保存原始信息。
平台托管不等于永久保存
即便内容托管在大型平台上,也不意味着它会被无限期保留。账号删除、平台政策调整、内容审核机制变化,都可能让一篇曾经可访问的页面消失。独立网站看似更脆弱,但至少备份的主动权在自己手里;平台内容一旦下架,用户往往连导出都无从谈起。
公共网页存档服务是应对内容消失的重要基础设施,其中最著名的是非营利项目 Internet Archive 及其 Wayback Machine。它自 1996 年起持续抓取全球网页,至今存档页面超过 8000 亿个,用户可提交任意 URL 触发即时快照,也可查阅历史版本。类似的还有 archive.today(支持按需抓取并保留页面截图与 DOM 结构)以及各国国家图书馆主导的网页归档项目。这类服务的价值在于第三方托管:即使原站关闭,存档副本仍独立存在。不过它们也有局限——抓取可能不完整、动态内容或登录后页面无法保存、且存档本身依赖机构持续运营,因此常被视作兜底而非唯一备份手段。
备份一个网站,实际操作上意味着什么
从原文标题出发,可以把这个建议拆解为几个可执行的层面:
- 单页保存:把重要的文章另存为本地文件或 PDF,适合零散的参考资料。
- 整站抓取:对内容连贯的独立博客,用站点镜像工具保存结构与页面,保留内部链接关系。
- 归档服务:利用公共网页存档服务提交 URL,让第三方留下一份历史快照作为兜底。
- 内容再分发:把关键文字整理到自己的笔记系统或知识库中,脱离原始页面也能继续使用。
这些方法并不互斥,选择哪一种,取决于你对该网站的使用频率和对内容损失的容忍度。
整站抓取常用工具包括 HTTrack(开源、跨平台,可递归下载站点并重写链接以支持离线浏览)、wget 的镜像模式(--mirror 参数适合命令行用户),以及面向现代前端的 SingleFile(将整页内联为单个 HTML 文件)。对于静态博客,直接克隆其 Git 仓库或下载 RSS 全文输出往往是最轻量的方式。需要注意的是,整站抓取会受 robots.txt 约束,且对依赖 JavaScript 渲染或需登录的站点效果有限;抓取前应确认网站的服务条款与版权声明,避免将备份用于再分发而侵犯作者权益。
备份不只是技术动作,也是内容伦理
把“爱一个网站就备份它”当作口号,背后还有一层容易被忽略的含义:备份让引用和讨论有据可查。当原始页面失效时,一份本地副本或存档链接能让后续读者验证你引用的内容是否真实存在过。
对独立创作者而言,这也是一个双向提醒——如果你自己运营网站,主动提供归档、导出或 RSS 全文输出,会降低读者保存内容的门槛,也间接延长了内容被阅读和传播的周期。
结语:把“以后再看”变成“已经存下”
这篇帖子没有给出复杂的方案,它提供的是一种简单的优先级判断:与其相信某个网站会永远在线,不如在看到值得保留的内容时,立刻做一次备份。212 个点数和 52 条评论说明,这不是少数人的偏执,而是许多长期使用互联网的人已经形成的习惯。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。